AI大模型测试三阶段详解:从断言到评估的测试新范式

AI测试从辅助走向主导,核心是从断言转向评估思维,掌握三层对象与版本管理方法。
本文系统梳理了AI时代软件测试的新范式。作者将AI测试分为三种递进体系:用AI辅助测试(已是过去式)、AI主导测试、以及针对AI应用的测试。其中最核心的思维转变是:由于大模型输出具有概率性,传统"通过/失败"的断言逻辑不再适用,必须引入"评估"(打分)机制。评估并非取代测试,而是解决"打多少分"的问题,测试则负责划定及格线。文章还强调AI评估须同时固定被测版本与评估版本,并将评估对象分为大模型、知识库(RAG)、智能体三个递进层次,最终推荐以Promptfoo作为工程化评估工具。
AI时代,测试正在被重新定义
软件测试正在经历一场深刻变革。这位来自B站的测试领域UP主指出一个明确的行业趋势:AI不仅改变了开发方式,也彻底重塑了测试工作。他坦言自己从测开出身、主攻Python,如今写项目已经开始用JS——「行业在变化,学习不能停下来」。
半年前,业内讨论AI测试还停留在「AI辅助测试、提高效率」的层面,而现在这一话题已经成为过去式。腾讯、阿里、字节这三家国内AI发力较大的公司,加上从模型研究转向工程化的DeepSeek广告,正在推动测试进入新的阶段。
作者早在一年前就提出了AI时代测试的三种体系,如今这套框架越来越清晰:用AI测试、和AI测试、对AI测试。理解这三层递进关系,是入门AI测试岗位的关键。
三种测试体系:用AI、和AI、对AI
用AI测试与和AI测试
「用AI测试」指的是借助AI辅助人工,提高测试效率,这是最早期的形态,如今已被行业翻篇。取而代之的是「和AI测试」——即AI主导测试。
在这种模式下,测试人员不再是完全的主导者,而是与AI各司其职。作者强调,需求分析、用例设计、系统探索、代码编写、自动化回归等大部分工作都可以交给AI完成,人只负责关键决策环节。
对AI测试:AI应用测试的崛起
第三种体系「对AI测试」是作者一年前埋下的伏笔,如今终于兑现。随着越来越多的软件在内部集成AI功能——AI客服、AI占卜、AI视频生成等——如何测试这些AI应用成为全新课题。
这类测试的思路、流程与传统软件测试完全不同,因此被单独列为一个方向,业内也称之为AI应用测试。这也是本次内容聚焦的核心。
从断言到评估:测试思维的根本转变
传统软件测试依赖断言(Assertion):结果只有通过或失败两种,没有第三种可能。接口测试中可以断言状态码、返回数据、字段内容,输出确定、断言稳定可靠。
但AI大模型打破了这种确定性。作者从两个角度解释了AI输出的概率性:
第一,从原理上讲,主流大模型采用Transformer架构,其本质在输出时存在概率选择。大模型天生带有概率性——同一个问题可能得到不同回答。
第二,从结果表现看,即便答案确定(比如数字「2」),也存在中文大小写、阿拉伯数字、二进制、十六进制等多种表现形式。再加上模型参数、上下文的任何微小改变都会导致结果巨变,简单的相等断言变得不再适用。
因此,AI测试引入了国际通用的术语——评估(Evaluation)。这与医学诊断、高考选拔的逻辑一致:你无法简单判断一个人是好是坏、聪明与否,而要通过打分来体现差距。对模仿人类的AI进行测试,同样应采用评分方式。
评估不等于取代测试
值得澄清的是,评估并非完全取代测试。评估解决的是「打多少分」的问题,而测试环节则为分数划定及格线——正如高考有录取分数线、医学诊断有临界值。
AI评估通常使用0到1的连续值打分(如0.1、0.9、0.999),但也可以用0和1两个固定值来模拟传统断言:0表示不通过,1表示满分。这种离散化处理让传统测试与AI评估在实践中可以灵活切换。
Transformer架构是目前主流大语言模型(如GPT、DeepSeek)的基础结构,由Google在2017年论文《Attention Is All You Need》中提出。其核心机制是"注意力机制"(Self-Attention),允许模型在生成每个词时参考上下文中所有词的相关性权重。在生成阶段,模型并非直接输出一个确定的词,而是计算词表中所有词的概率分布,再通过采样或贪心策略选取输出——这一过程中的"温度"(Temperature)参数控制分布的平滑程度:温度越高,随机性越强;温度为0时接近确定性输出。这也是同一问题在不同对话中得到不同答案的根本原因,也是传统"等值断言"在大模型场景下失效的技术根源。
版本固定:AI评估的严格要求
由于评估结果模糊、波动,对版本管理的要求比传统测试更严格。作者强调必须同时固定两个版本:
被测版本:不仅是软件版本号,还包括使用的模型、传入的参数、提示词以及上下文。任何一项变化都意味着被测版本改变——比如从DeepSeek换成GPT,结果就必须重新评估。
评估版本:即测试的手段本身,包括数据集、断言、提示词、门槛等。如同同一个人考江苏卷和全国卷,结果自然不同。
横向对比的前提是只改变其中一个版本。固定评估手段、更换模型,可对比不同模型质量;固定被测系统、改变门槛,可对比不同门槛效果。若两个版本同时变化,结果就失去了对比价值,成为完全独立的评估。
作者还提供了一个类比:AI评估与性能测试高度相似。两者都不特别关心对错,而是在特定条件下通过一组数据发现问题,且都需要多轮对比而非单次判定。有性能测试经验的同学理解这套逻辑会更有优势。
评估什么:大模型、知识库、智能体三层递进
很多人误以为AI评估就是套用一堆指标(如召回率、忠诚度)。作者纠正了这一观念:必须先确定评估对象,不同对象的目的和指标完全不同。
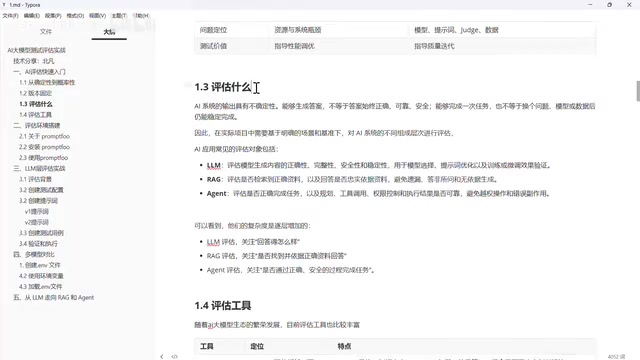
第一层:大模型(LLM)。主要评估生成内容的正确性、完整性、安全性和稳定性。对DeepSeek这类公司是必测项;对普通公司,则用于模型选型、提示词优化、微调后模型的验证。
第二层:知识库(RAG)。其原理是先检索资料再结合资料回答,因此评估重点在各个环节——检索是否准确、生成结果是否有对应参考资料。忠诚度指标就是判断答案是否严格基于指定资料生成,召回率也主要用于此。
第三层:智能体(Agent)。客服、数据、法律、医疗等各类Agent将越来越多。其原理涉及任务规划、工具使用、任务推进,评估复杂度最高。
这三层是递进关系而非三选一:智能体内部往往挂载知识库,知识库又依赖大模型。学习路线应从大模型入手,再到知识库,最后到智能体。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前企业落地大模型的主流方案之一。其工作流程分为两步:首先将用户问题转化为向量,在预先构建的知识库(通常是向量数据库)中检索最相关的文档片段;然后将检索结果连同原始问题一起送入大模型,让模型"基于资料"生成回答,而非依赖训练时记忆的知识。RAG的优势在于可以低成本接入私有知识、降低模型幻觉风险,但也因此引入了两个独立的失败点:检索环节可能找错或找不到相关内容,生成环节可能忽视检索结果自行发挥。这解释了为何RAG评估需要分别考量"召回率"(检索是否找到了正确内容)和"忠诚度"(生成答案是否真正基于检索到的资料),而非只看最终答案对不对。
工具选型:Promptfoo 为何值得推荐
最后是「用什么测」的问题。作者列举了多款AI测试工具,并重点推荐了一款PyTest风格的评估工具(Promptfoo),理由有几点:
它由命令行和YAML驱动,支持CLI方式——这意味着它可以被AI自己调用,未来将出现「AI评估AI」的场景。同时它支持人工评估(在AI评估领域,人工评估是金标准,因为当前AI仍不如人聪明),支持批量调用和Python自定义扩展。更重要的是,它已被OpenAI收购,其优秀得到了行业头部公司的认可。
作者也给出了差异化选型建议:做学术性指标研究可选专业评估工具;面向线上用户的智能体可用生产监控类工具;而对大部分测试同学来说,评估的目的是判定产品能否上线(带有验收味道),Promptfoo更为合适,且能覆盖大模型、知识库、智能体三个层次。
Promptfoo是一款开源的LLM评估框架,核心设计理念是以YAML配置文件描述测试用例,通过命令行(CLI)执行评估,风格上类似Python生态中的PyTest。其基本结构包括三部分:providers(被测模型或接口)、prompts(提示词模板)和tests(测试用例及断言规则)。断言类型支持精确匹配、正则、语义相似度、以及调用外部LLM作为"裁判"进行评分等多种方式,能灵活覆盖从离散断言到连续评分的各类场景。由于整个评估流程可由CLI触发,Promptfoo天然适合集成到CI/CD流水线中,实现模型版本迭代时的自动化回归评估,这也是其相较于以Notebook为主要交互方式的学术评估工具在工程落地上的核心优势。
写在最后
作者反复强调,这些看似枯燥的理论——评估思维、版本固定、评估对象分层、工具选型——恰恰是整个AI测试体系中最有价值的部分。后续的工具操作和脚本编写都建立在这套方法论之上。即便暂时不动手实践,理解这些方向性内容,也足以在面试或实际工作中占据主动。对于想入行2026年热门AI测试岗的从业者,掌握从断言到评估的思维转变,是绕不开的第一课。
相关推荐

5步构建机器人仿真SimReady资产:前沿AI模型实战指南
NVIDIA分享借助前沿AI模型构建机器人仿真SimReady资产的5步工作流,涵盖CAD转OpenUSD、材质配置、碰撞体生成与物理属性标注,助力机器人仿真开发高效落地。

Restock:能在Slack里用Stripe买办公用品的AI采购代理
Restock 是基于 Managed Deep Agents 构建的开源示例 AI 代理,能在 Slack 里理解采购需求、通过 Zinc 搜索真实商品、用 Stripe Link 完成付款。它展示了 AI 代理安全执行真实交易的「人在环中」范式,并提供免下单的排练模式供试用。

生物医学影像的真正瓶颈:数据,而非模型
生物医学影像AI的真正瓶颈不在模型而在数据。本文分析医院海量影像数据背后的可获取性、标注成本、隐私合规与标准化难题,探讨数据基础设施为何比模型更难突破。