AI盗用你的肖像做广告怎么办?维权与自保指南
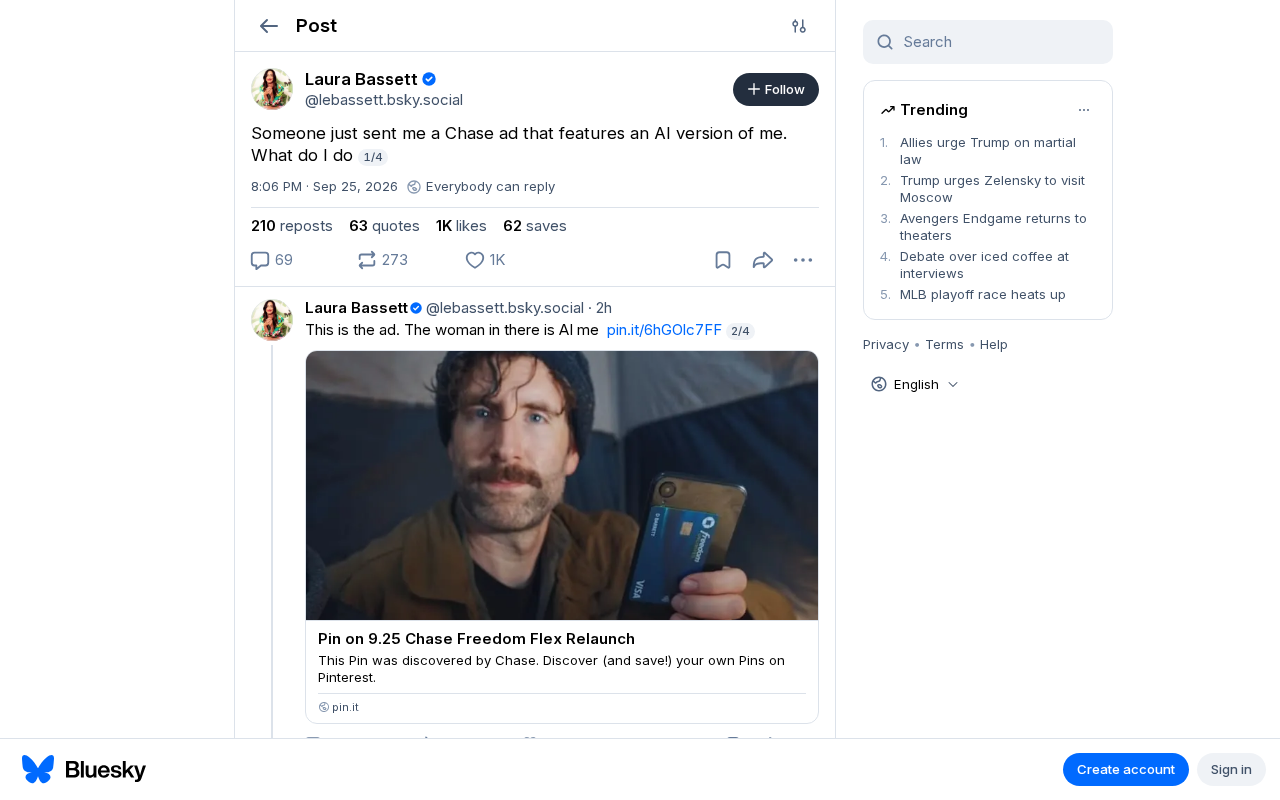
AI合成"数字分身"用于商业广告的侵权问题日益普遍,本文梳理了法律边界与实操应对步骤。
生成式AI的普及使任何人只需少量公开影像或音频,就能合成他人的"数字分身"并用于商业广告,由此引发肖像权、声音权和虚假代言三类法律风险。文章以Hacker News上一则真实求助帖为引,系统梳理了遭遇此类侵权时的四步应对策略:第一时间固定证据、向广告平台提交有针对性的举报、追溯并联系广告主发送停止侵权函、以及在自身社交渠道公开澄清。文章同时指出,技术门槛的下降让普通人也成为被克隆的目标,而法律立法永远滞后于技术演进,个人需要主动控制高清影像和音频素材的公开传播,并定期监控自身形象是否被滥用,以此作为第一道防线。
当你成为AI广告里的“数字分身”
一位用户在Hacker News上发出求助:有人给他发来一则广告,广告里出现了一个“AI版的自己”——用他的形象、可能还有他的声音,来推销某个他从未授权过的产品或服务。帖子虽短(15个赞、3条评论),却戳中了生成式AI时代一个越来越常见的痛点:你的脸、你的声音,正在被别人拿去训练模型、合成内容、用于商业牟利,而你毫不知情。
这不是危言耸听。随着文生图、语音克隆和数字人技术门槛的急剧下降,任何人只要拿到几张公开照片或几十秒录音,就能生成一个足以以假乱真的“数字分身”。当这个分身出现在广告里,问题就从技术好奇变成了法律与个人权益的严肃议题。
先确认:这到底侵犯了什么权利
遇到这种情况,第一反应往往是愤怒和无措,但冷静下来理清“对方到底侵犯了你什么”,才能决定后续动作。通常涉及三类权益:
肖像权与形象权
未经许可将你的面部、体貌特征用于商业广告,几乎在所有司法管辖区都构成对肖像权(在美国部分州称为 right of publicity,形象权)的侵犯。广告是明确的商业用途,这一点让维权比“恶搞表情包”更有底气。
值得注意的是,"形象权"(right of publicity)在各国的保护范围存在显著差异。美国目前有超过30个州通过了独立的形象权法规,其中加利福尼亚州和纽约州的保护最为完善,甚至延伸至死后一定年限。中国《民法典》第1019条明确禁止任何组织或个人未经肖像权人同意,制作、使用、公开其肖像,并专门将"利用信息技术手段伪造"纳入禁止情形,这意味着AI合成肖像在中国法律框架下已有明确的规制依据。欧盟则通过GDPR将生物特征数据(包括面部图像用于身份识别的情形)列为特殊类别数据,未经明确同意不得处理。了解自己所在司法管辖区的具体规定,决定了你能走多远的法律路径。
声音权
如果广告里还克隆了你的声音,这可能构成对声音权益的单独侵犯。近年来多起语音克隆纠纷已经把“声音”作为一种可被保护的个人标识确立下来。
虚假代言与商誉损害
更严重的是,广告让公众误以为“你在为某产品站台”。如果这个产品是骗局、劣质品或与你价值观相悖的东西,还可能损害你的名誉和商业信誉,构成虚假背书。
立刻要做的四件事
1. 固定证据
在做任何事之前,先把证据保全下来。完整截图、录屏保存广告内容,记录下广告出现的平台、链接、发布账号、投放时间。这些是后续举报和法律主张的基础,一旦对方删除就难以取证。
2. 向平台举报
绝大多数广告平台(Meta、Google、TikTok、X等)都有针对冒充与未授权肖像的举报通道。以“未经授权使用我的肖像/声音进行虚假代言”为由提交举报,通常比笼统投诉“虚假广告”更容易获得处理。
3. 追溯广告主
试着弄清楚这则广告到底是谁投放的:是一个想蹭你影响力的第三方,还是某个直接盗用素材的骗子?如果是有实体的公司,可以发送正式的停止侵权函(cease and desist)。如果是纯诈骗账号,重点就转向平台下架与公开澄清。
4. 公开澄清
在自己的社交渠道发声明,告知关注者“这不是我,我从未代言此产品”。这既能保护可能被误导的受众,也在为潜在的名誉损害留下你及时切割的记录。
为什么这件事会越来越普遍
这个求助帖的价值,不在于它的热度,而在于它是一个信号。过去伪造名人代言需要专业团队,如今一个普通人也可能成为被“数字克隆”的对象——只要你在网上留下过足够的公开影像。
技术的普及意味着两件事:其一,被侵权的门槛降到了每个人头上;其二,取证与维权的难度反而上升了。 因为合成内容可以批量生产、快速换号重发,单靠个人追着删除往往疲于奔命。
这也解释了为什么各国正在加快立法。针对深度伪造(deepfake)的专项法规、对AI生成内容强制标识的要求、以及对声音和肖像的新型保护条款,都在陆续落地。但法律永远滞后于技术,个人的自我保护意识才是第一道防线。
从技术层面看,当前推动这一现象的核心是两类模型能力的成熟:一是人脸替换与驱动技术(如基于扩散模型的图像生成和视频重演算法),只需少量参考图像即可将目标人物的面部特征迁移到任意视频素材上;二是零样本语音克隆(zero-shot voice cloning),部分商业级模型已经可以用不到10秒的音频样本合成高度相似的声音。两种技术的API化和产品化意味着攻击者无需任何深度学习知识,只需调用现成接口即可完成克隆。这也是为什么本文所描述的威胁不再局限于拥有大量公开素材的名人——任何在视频平台、社交媒体或会议录像中留下过清晰影像的普通人,都已进入潜在的攻击面。
日常如何降低被“克隆”的风险
完全避免几乎不可能,但可以提高对方的成本:
- 控制高清正面影像的公开传播,尤其是多角度、高清晰度的人脸素材。
- 对公开演讲、播客等长音频保持警觉,这些是语音克隆的优质训练数据。
- 定期做反向搜索,用图片搜索和关键词监控自己的名字与形象是否被滥用。
- 保留原始素材的时间戳和出处,一旦发生纠纷,能证明“哪个是真的你”至关重要。
写在最后
“有人用AI版的我做广告”从一句无助的提问,正在变成数字时代每个人都可能面对的现实。技术本身中立,但当它被用来冒用你的身份牟利时,快速固证、平台举报、公开澄清、必要时诉诸法律,是目前最务实的组合拳。更长远看,如何在AI能轻易复制“你”的世界里,重新界定身份、肖像与声音的归属,将是社会和立法必须共同回答的问题。
背景补充
部分平台和工具正在提供主动防御手段。例如,Adobe、微软等公司推动的**内容真实性倡议(Content Authenticity Initiative, CAI)**通过为数字媒体附加加密来源元数据(C2PA标准),使创作者能够为自己的原始内容"签名",从而在纠纷中证明真实出处。此外,学术界已出现针对人脸图像的对抗性扰动工具(如Fawkes、PhotoGuard),能够在人眼不可见的像素层面为图片添加噪声,使其被输入AI模型时产生严重的特征偏移,从而干扰人脸识别和克隆训练。这些工具目前仍处于早期阶段,对不同模型的防御效果参差不齐,但代表了个人主动防御的技术方向。
相关推荐

MCP工具投毒:被忽视的AI智能体攻击面与防御之道
MCP工具投毒正成为智能体AI的新攻击面。本文解析工具描述为何可被恶意利用,剖析信息鸿沟与数据外泄链条,并给出白名单注册表、哈希固定、最小权限与链路策略等分层防御方案。
MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP联合创造者David Soria Parra在演讲中指出,决定智能体未来的是连接性与开放标准,而非更强的模型。本文梳理模型能力演进、编程Agent落地逻辑、MCP的无状态改造及Tasks、Skills、身份授权等未来路线图。
SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
Amazon SageMaker 推出 aws-ai-ml 新技能,通过 Agent Toolkit for AWS 为 Kiro、Claude Code、Codex 等编码智能体注入生成式AI推理优化专长,支持自然语言生成可执行的 SageMaker Python SDK v3 代码完成基准测试、推荐与对比。