SageMaker新技能上线:为编码智能体赋能生成式AI推理优化
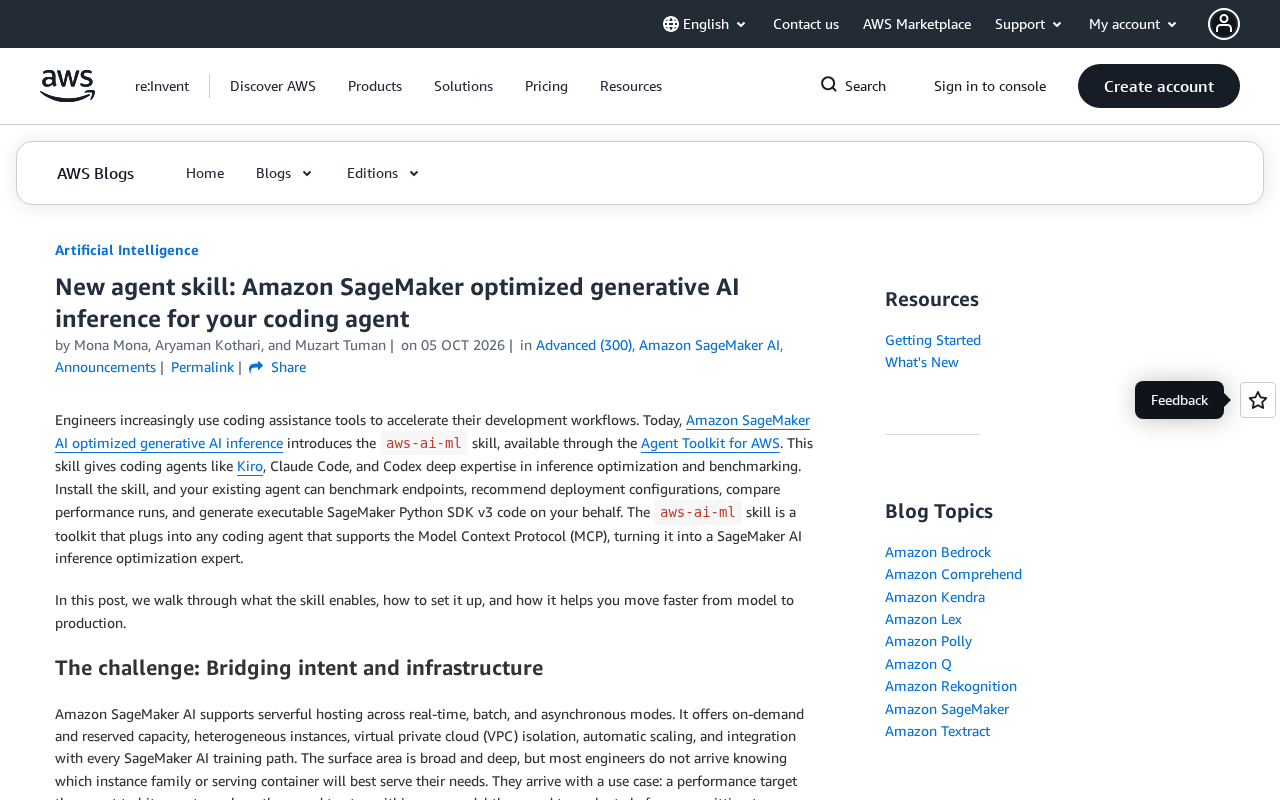
SageMaker 将推理优化专长封装为智能体技能,开发者可用自然语言驱动 Kiro、Claude Code 等工具自动生成基准测试与部署优化代码。
Amazon SageMaker 通过 Agent Toolkit for AWS 推出 `aws-ai-ml` 技能,将生成式AI推理优化的专家经验直接注入 Kiro、Claude Code、Codex 等主流编码智能体。开发者只需以自然语言描述需求,智能体便可生成可执行的 SageMaker Python SDK v3 代码,覆盖推理部署的基准测试、方案推荐与多方案对比三类核心任务。这一能力的价值在于把原本需要工程师在实例选型、批处理策略、量化方案等多维度反复权衡的专业工作自动化,大幅缩短从想法到可运行验证代码的路径。从更宏观的角度看,此举也体现了云厂商将服务能力打包为跨工具可复用"技能"的趋势,标志着编码智能体正从代码助手演进为具备领域专长的工程伙伴。
让编码智能体懂得推理优化
Amazon SageMaker 推出了一项名为 aws-ai-ml 的新能力,通过 Agent Toolkit for AWS 向编码智能体开放。这意味着像 Kiro、Claude Code 和 Codex 这类工具,不再只是帮你写普通代码,而是获得了在生成式AI推理优化与基准测试方面的专业知识。
这类能力的价值在于把专家经验内化到智能体中。过去,部署和优化一个大模型推理服务需要工程师对实例类型、吞吐、延迟、成本等多维度做反复权衡,门槛相当高。而现在,这些经验被封装成了智能体可以直接调用的"技能"。
用自然语言生成可执行代码
这项技能的核心交互方式非常直接:你只需用自然语言描述想要达成的目标,智能体便会生成可执行的 SageMaker Python SDK v3 代码。生成的代码能够完成三类关键任务——对部署方案进行基准测试(benchmark)、给出推荐配置(recommend)以及对比不同部署方案(compare)。
换句话说,开发者不必手动翻阅文档去拼凑 SDK 调用,而是把"我想比较两种实例在这个模型上的推理表现"这样的需求直接交给智能体。智能体理解意图后,输出的是可以直接运行的代码,而不是停留在抽象建议层面。这种"描述即执行"的模式,大幅缩短了从想法到验证的路径。
面向推理优化的专业场景
推理优化本身是一项高度专业化的工作。模型在生产环境中的表现,受到硬件选择、批处理策略、量化方案等因素的综合影响。aws-ai-ml 技能将这些领域知识注入编码智能体,让智能体在生成代码时能够考虑到基准测试与性能对比的实际需求,而非泛泛地给出模板代码。
推理优化中的几个核心概念值得简要说明。实例类型选择涉及GPU/加速芯片的算力与显存权衡,例如 ml.g5 系列适合中等规模模型,ml.p4d 系列则面向超大模型;**批处理策略(Batching)**决定了同一时刻处理多少并发请求,直接影响吞吐量(Tokens/s)与单请求延迟的平衡;量化方案(如 INT8、FP8)通过降低权重精度来压缩显存占用和加速推理,但可能带来轻微精度损失。这些变量之间存在复杂的耦合关系——例如更激进的量化可以让更小的实例跑起更大的模型,却未必能降低P99延迟。正是这类多维权衡的经验,此前只能依赖资深MLOps工程师积累,现在被 aws-ai-ml 技能尝试系统化地注入编码智能体。
Agent Toolkit 的生态意义
值得关注的是,这项能力通过 Agent Toolkit for AWS 交付,并且明确支持多款主流编码智能体。这一点体现了一种趋势:云厂商正在把自身的服务能力打包成"技能",让其能够被不同的AI智能体消费,而不是绑定在单一产品里。
对开发者而言,无论习惯使用 Kiro、Claude Code 还是 Codex,都能获得同样的 SageMaker 推理优化专长。这降低了工具切换成本,也让AWS的推理服务更容易被纳入到日常的智能体工作流中。
Agent Toolkit for AWS 是亚马逊提供的一套标准化接口层,允许第三方编码智能体通过统一协议调用AWS服务能力。其设计理念类似于插件或工具市场:智能体平台(如 Kiro 或 Claude Code 的宿主环境)声明支持 Toolkit 协议后,即可动态加载 aws-ai-ml 等技能,而无需各家平台分别与AWS对接定制集成。这种架构与 OpenAI 的 Function Calling、Anthropic 的 Tool Use 机制在思路上一脉相承——将外部能力结构化地暴露给大模型,让模型决定何时调用、如何传参。对AWS而言,Toolkit 也是一种渠道策略:通过兼容多款主流智能体,避免服务能力被单一入口垄断。
对开发工作流的影响
从更宏观的角度看,这类"智能体技能"正在重新定义云服务的使用方式。开发者与基础设施之间的交互,正从命令行、控制台、SDK 文档,逐步转向以自然语言驱动的智能体协作。
当基准测试、方案推荐和对比这些原本需要专门投入时间的工作,可以由智能体自动生成可执行代码来完成时,团队能把更多精力放在模型本身和业务逻辑上。对于正在生产环境部署生成式AI的团队来说,这是一个实用的效率提升点。
需要提醒的是,当前公开的信息主要集中在能力介绍层面,关于具体性能数据、支持的模型范围以及实际使用中的限制,还需要在实践中进一步验证。但方向已经明确:编码智能体正在从代码助手,演进为具备领域专长的工程伙伴。
相关推荐
192GB统一内存Framework台式机:本地跑超大AI模型
搭载AMD Gorgon Halo与192GB统一内存的Framework台式机,可在单机本地运行DeepSeek V4.1 Flash、MIMO V2.6 Flash等超大开源模型,支持双模型协作与异构推理,附实测性能数据。
树莓派5实测8款本地大模型:仅3款真正可用
树莓派5实测8款本地大模型,从速度到实用任务全面评估。仅Gemma 2B、Gemma 4B、Granite三款真正可用,附完整测试标准与选型建议。
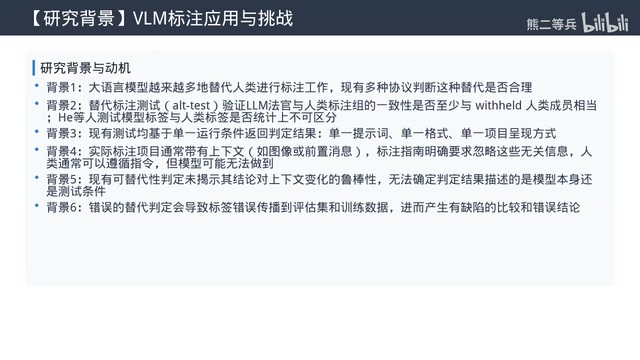
VLM当标注员竟被无关图片带偏?MIST测试揭露多模态模型隐藏缺陷
一篇关于VLM作为标注替代者的论文发现:只要加入图片,哪怕要求忽略,多模态大模型的标注结果就会被打乱,且干扰不指向图片含义。本文解读MIST测试集的设计与颠覆性发现,揭示自动标注的隐藏风险。