MCP联合创造者:智能体需要的是连接性,而非更强模型
MCP创造者David认为,模型能力已非瓶颈,智能体规模化落地的关键在于开放的连接标准。
Anthropic工程师、MCP联合创造者David Soria Parra在一场技术大会上提出:随着模型能力以复利方式增长,智能体系统的真正瓶颈已从"模型有多强"转向"如何将模型与真实世界系统连接"。他回顾了编程Agent率先落地的原因(可借助编译器等自动化工具纠偏),预判2026年将是智能体走向通用知识工作的分水岭,并用MCP生态数据(Claude累计工具调用超10亿次、SDK月下载超5亿次)佐证连接层基础设施的爆发式增长。在协议演进上,MCP今年的核心变化是实现真正无状态架构,未来12个月将聚焦Agentic Messaging(MCP Tasks)、Skills语义扩展与身份授权三大方向,目标是成为智能体交互的默认开放标准。
在日本举办的一场技术大会上,MCP(Model Context Protocol)联合创造者、Anthropic工程师David Soria Parra抛出了一个与行业主流叙事略有不同的判断:决定智能体(Agent)系统未来的,不是模型能力的进一步提升,而是连接性——以及围绕连接性构建的开放标准。
这一观点背后,是他对模型能力演进曲线与智能体落地路径的系统性梳理。以下是这场演讲的核心脉络与分析。
模型能力正在以复利方式增长
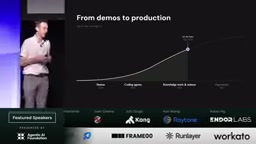
David开场便引用了一张关于模型能力随时间变化的曲线图。他指出,一年前的模型只能完成人类约几个小时量级的任务,且需要人类不断「掌舵」和纠偏;而如今,模型已经在快速逼近能够独立完成「数周工作量」任务的阶段——模型几小时就能完成人类需要数周才能做完的工作。
他特别强调,这些能力呈现出复利式(compound)增长的特征,几乎沿着一条笔直的直线向上延伸。按照这个趋势,几个月后就会出现能把人类数月工作量压缩到几小时完成的模型。这一判断为他后续的论点奠定了前提:当模型本身已经足够强,瓶颈就会转移到别处。
从Demo到编程Agent:为什么编程是第一个落地场景
David回顾了智能体产品的演进节奏。2024年MCP诞生时,工具调用(tool calling)对模型还是全新概念——到今天也仅有大约两年历史。那个阶段人们构建的大多是「看起来很酷」的Demo,并不具备生产可用性,因为模型还无法完成足够长的任务,工具调用能力也不稳定。
2025年则完全属于编程Agent。他给出了一个值得玩味的解释:为什么编程Agent是第一批真正进入生产环境的智能体?因为编程天然具备一种特殊属性——可以用单元测试、编译器这类自动化系统来对模型进行实时纠偏和引导。即便模型当时一次只能稳定工作几个小时,开发者仍能借助编译器等工具把它「拉回正轨」。
随着模型能力大幅提升,如今人们可以越来越依赖模型「直接做对」,而不必时刻监督。
2026的分水岭:知识工作需要的是连接
David判断,这将是智能体系统首次大规模走出编程领域、进入通用知识工作、科学发现、数学等场景的生产级应用阶段。
但他提醒,面向开发者的应用和面向通用知识工作者的应用存在根本差异。知识工作者——比如财务顾问、会计——他们真正需要的只有一件事:连接性,即模型能够与他们关心的系统进行交互的能力。这些人日常打交道的是Microsoft 365、Google Workspace,以及大量内部系统和SaaS系统。
他的核心论点由此成立:当模型能力以复利速度增长、逐渐逼近天花板时,真正的关键就从「模型有多强」转向「我们如何把它连接起来」。
MCP的爆发式增长数据
为佐证这一趋势,David给出了一组生态数据:
- Anthropic的Claude AI上,通过MCP累计发生的工具调用已超过约10亿次;
- MCP SDK月下载量超过5亿次;
- Vercel、Linear等公司将MCP Server视为其产品线中增长最快的部分;
- 从Anthropic到竞争对手OpenAI,整个行业的MCP工具调用量都在「爆表」。
这个两年前的「小项目」正在成为行业基础设施。而随着行业越来越依赖MCP,协议本身也必须持续演进。
MCP的演进:走向真正的无状态
David梳理了MCP的迭代历程:2024年发布后,陆续加入了远程连接(remote connectivity,目前使用最广的版本)、授权机制,以及去年引入的应用(applications)概念。
而今年最具分量的改动,是让MCP真正实现无状态(stateless)。他透露,这是Microsoft、Google、Anthropic、OpenAI等多家行业领导者共同协商的结果,目标是在保持无状态的同时,支持智能体系统特有的交互模式——因为有些交互模式是单纯的HTTP所无法胜任的。
其中一个被提及的模式叫做「short MRTR」(multi-round trip request,多轮往返请求)。配合无状态核心,MCP还引入了可缓存结果(cacheable results),并开始废弃那些不再需要的部分。
**无状态(stateless)**架构是指服务器不在请求之间保存任何客户端会话信息,每个请求都携带完整的上下文自描述。与之对应的有状态架构需要服务器维护会话状态,这在横向扩展时会带来复杂的状态同步问题。MCP早期版本依赖长连接(如SSE)来维持会话,限制了大规模部署的灵活性。转向无状态后,MCP Server可以像普通HTTP API一样被任意负载均衡和水平扩展,极大降低了企业级部署的运维复杂度。
可缓存结果则是无状态架构的配套机制——对于相同输入产生确定性输出的工具调用,客户端或中间层可以缓存结果以减少重复计算和网络往返。**short MRTR(multi-round trip request,多轮往返请求)**则是对"无状态但需要多次交互"场景的补充方案:在单次逻辑操作中允许有限次数的往返协商,既保持了无状态的架构优势,又支持了确认、授权等需要交互的智能体工作流。
未来12个月:Tasks、Skills与身份授权
David展望了MCP社区未来约12个月的三大重点方向:
一是智能体消息传递(Agentic Messaging)。 目标是让MCP成为智能体消息与编排的默认协议。为此引入了MCP Tasks概念,支持长时运行操作——你可以把一个MCP Server当作Agent来调用,让它在准备好时主动返回结果。与普通工具调用不同,MCP Tasks允许耗时数分钟、数小时、数周乃至数月的任务。
二是扩展语义表达能力。 David认为单纯的工具调用有一定局限性,因此他个人最期待的是一个名为Skills over MCP的扩展——即通过MCP Server提供Agent技能。这不仅能把技能与一组工具捆绑,帮助他人更好理解你的MCP Server,还能让企业以前所未有的方式构建中央技能注册中心,因为分发渠道变成了MCP本身,而非复杂的市场系统。
三是授权与身份(Authorization & Identity)。
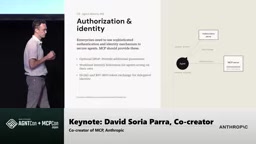
David坦言这或许不是技术上最有趣的部分,却是智能体系统概念上最重要的环节之一。随着Agent越来越多地自主承担任务,识别它们、明确它们代表谁工作、并建立可观测性与策略机制,变得至关重要。他表示这也是MCP社区目前投入工作量最大的方向。
MCP Tasks与传统的同步工具调用存在根本性差异。普通工具调用类似一次函数调用——调用方等待返回值,整个过程通常在毫秒到秒级完成。MCP Tasks则更接近一个异步作业队列:调用方提交任务后可以断开连接,MCP Server(此时充当一个自主Agent)在后台持续执行,完成后主动推送结果。这种模式对于需要调用外部API、执行复杂推理链或等待人工审批的长流程任务尤为关键。
Skills over MCP的概念则试图解决当前"工具发现"的语义贫乏问题——现有MCP Server仅能暴露工具列表和参数描述,但无法传递"这组工具协同完成什么业务能力"这类高阶语义。通过Skills,一个MCP Server可以声明自己具备"财务对账"或"代码审查"等技能,使编排层(Orchestrator)能够更准确地路由任务,也使企业能够以技能粒度而非工具粒度来治理其AI能力资产。
开放社区才是MCP的核心
演讲最后,David强调MCP最重要的部分始终是社区本身。他呼吁三种参与方式:构建并分享经过充分评估的高质量MCP Server;通过类似本次的大会交流各自企业的挑战与需求(他尤其提到希望理解日本市场的独特性);以及直接加入这个始终开源的项目,通过Discord或工作组贡献来自不同地区的视角。
他的收尾落点清晰:MCP的目标是成为智能体交互的默认开放标准,而这需要全球社区的共同参与。
结语
David的演讲提供了一个有价值的视角切换:在一个普遍关注「下一个模型有多强」的行业里,他把注意力引向了「模型如何触达真实世界系统」这一更工程化、也更贴近落地的命题。当模型能力增长见顶或趋于同质化,连接性与开放标准很可能成为智能体规模化落地的真正胜负手。
相关推荐
192GB统一内存Framework台式机:本地跑超大AI模型
搭载AMD Gorgon Halo与192GB统一内存的Framework台式机,可在单机本地运行DeepSeek V4.1 Flash、MIMO V2.6 Flash等超大开源模型,支持双模型协作与异构推理,附实测性能数据。
树莓派5实测8款本地大模型:仅3款真正可用
树莓派5实测8款本地大模型,从速度到实用任务全面评估。仅Gemma 2B、Gemma 4B、Granite三款真正可用,附完整测试标准与选型建议。
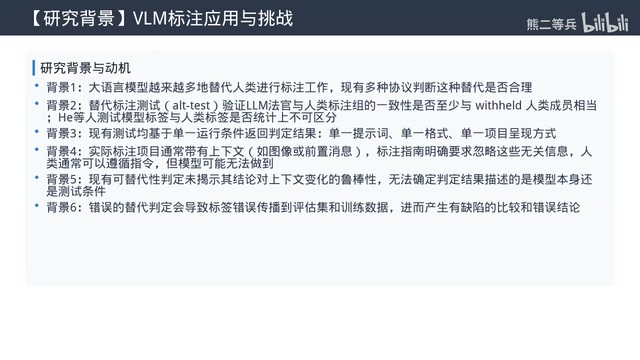
VLM当标注员竟被无关图片带偏?MIST测试揭露多模态模型隐藏缺陷
一篇关于VLM作为标注替代者的论文发现:只要加入图片,哪怕要求忽略,多模态大模型的标注结果就会被打乱,且干扰不指向图片含义。本文解读MIST测试集的设计与颠覆性发现,揭示自动标注的隐藏风险。