AI功能何时算「可以上线」?一个被忽视的决策难题

一位ASU研究生的Reddit调查,揭开了AI功能上线验收背后的技术、流程与组织三重难题。
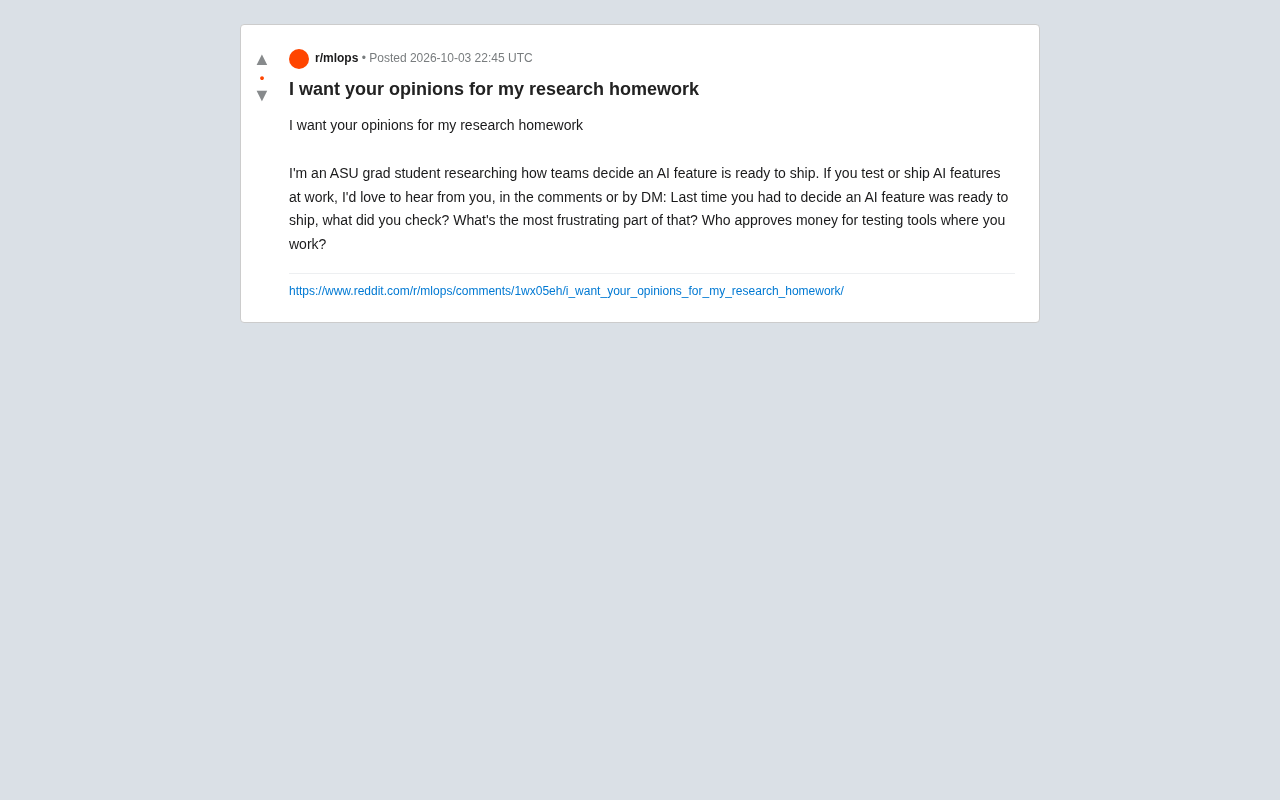
一位亚利桑那州立大学研究生在Reddit发起调查,聚焦三个核心问题:AI功能上线时检查哪些指标、评估流程中最大的摩擦是什么、测试工具预算由谁审批。文章以此为切入点,指出AI功能验收远比传统软件复杂——输出的概率性与不确定性使二元判定失效,团队必须依赖评估集、A/B测试和人工抽检来建立信心。评估流程的主要摩擦集中在三点:各方对"足够好"缺乏共识、测试数据构建成本高昂、主观质量难以量化。更被忽视的是预算审批这一组织层面的障碍——当评估工具被视为不产生直接价值的支出,团队往往只能凭感觉拍板上线,这正是AI产品风险的深层根源。
一个研究生抛出的真问题
一位亚利桑那州立大学(ASU)的研究生在Reddit上发起了一项调查,主题看似简单却直指行业痛点:团队究竟如何判断一个AI功能「准备好可以发布」了?
他提出了三个核心问题——上一次决定AI功能可以上线时,你检查了哪些指标?这个过程中最让人头疼的环节是什么?在你所在的公司,谁来批准测试工具的预算?
这三个问题串起了AI产品落地过程中一条常被忽略的隐形链条:技术验收标准、评估流程摩擦、以及资源审批权力。虽然原帖本身是一次开放式征集,尚未给出结论,但问题本身足以引发从业者的深度思考。
为什么「AI功能是否ready」是个难题
传统软件功能的上线标准相对明确:功能跑通、通过测试用例、没有阻断性Bug,就可以进入发布流程。但AI功能的「就绪」判断要模糊得多。
一个大模型驱动的功能,可能在90%的情况下表现出色,却在剩下10%的长尾场景里给出离谱的回答。准确率达到多少才算「够好」?幻觉率控制在什么水平可以接受?这些问题没有统一答案,往往取决于具体业务的容错边界。
更棘手的是,AI的输出具有概率性和不确定性。同一个输入在不同时间可能得到不同结果,这让传统的「通过/不通过」二元判定失效。团队不得不依赖评估集(eval set)、人工抽检、A/B测试等手段来建立信心,而这些手段本身的覆盖度和代表性又成了新的变量。
评估集(eval set)是AI功能验收的核心工具,其本质是一组精心构建的输入样本及对应的预期输出或评判标准,用于系统性地衡量模型在特定任务上的表现。一个高质量的评估集需要覆盖典型场景、边界情况和潜在的高风险输入(如对抗性提示、罕见语言表达等)。问题在于,评估集本身就存在「代表性偏差」——它只能覆盖构建者预想到的情况,而真实用户的使用行为往往远超预期。这就导致一个悖论:在评估集上表现完美的模型,上线后仍可能在真实流量中翻车。因此,评估集的持续迭代与维护,和模型本身的迭代同等重要,但这一工作在许多团队中长期处于欠投入状态。
评估流程中的典型摩擦
原帖特意问到「最让人头疼的环节」,这恰恰是实践中最真实的痛点所在。
结合行业普遍经验,AI功能验收常见的摩擦点包括几个方面。其一是评估标准缺乏共识:产品、工程、业务方对「足够好」的理解各不相同,常常在上线前夜还在争论指标阈值。其二是测试数据构建成本高:要搭建一个能代表真实用户分布的评估集,需要大量人工标注和持续维护,很多团队在这一步就半途而废。
其三是主观质量难以量化。对于生成式AI,内容的「好坏」往往涉及语气、风格、相关性等主观维度,很难用单一数字衡量,最终只能靠人工评审,而人工评审又慢又贵且标准难统一。
被忽视的「谁批钱」问题
第三个问题——「谁批准测试工具的预算」——看似不起眼,实则点出了一个组织层面的深层矛盾。
高质量的AI评估往往需要专门的工具链:评估平台、标注服务、监控系统、甚至付费的第三方裁判模型(LLM-as-a-judge)。这些都是实打实的成本。但在很多组织里,「测试」和「评估」被视为不产生直接价值的支出,审批链条长、优先级低。
研究者把预算审批权力纳入研究范围,说明他意识到:AI功能能否被严谨验收,不只是技术问题,更是资源分配和组织权力的问题。当没有人愿意为评估工具买单时,团队往往只能靠「感觉差不多了」来拍板上线——这正是风险的源头。
LLM-as-a-judge(以大语言模型作为评判者)是近年兴起的一种自动化评估方案:用一个能力更强或经过专门调校的语言模型,替代人工来对被测模型的输出进行打分或裁定。这种方法在扩展性上远优于人工评审,可以低成本地覆盖大批量样本,尤其适合开放式生成任务(如摘要、对话、代码解释)的质量判断。然而它也引入了新的风险:裁判模型自身的偏好、风格倾向和已知局限会渗透进评分结果,导致评估结论带有系统性偏差。此外,使用商业模型作为裁判还涉及数据隐私和额外API费用,这正是其预算审批常遭遇阻力的原因之一。
对从业者的启示
这项研究虽然还处于征集阶段,但它提出的框架值得每个做AI产品的团队自省。
如果你正在负责AI功能的交付,不妨用这三个问题做一次内部审视:我们是否有明确、量化、被各方认可的上线标准?我们的评估流程中最大的摩擦在哪里,有没有被系统性解决?我们是否有预算和机制去持续投入评估能力建设?
从「凭感觉上线」走向「有依据上线」,是AI工程化成熟度的重要标志。这位ASU研究生的问题,或许比它看起来要重要得多。
相关推荐
Opus 5.5 实战手册:Claude Code 长任务的优化与边界
Opus 5.5 在 Claude Code 中的实战手册:明确终点线、删除冗余提示词、将停止规则写入 CLAUDE.md。结合 130 条 Hacker News 评论,剖析 AI 编程长任务的优化方法与失效边界。
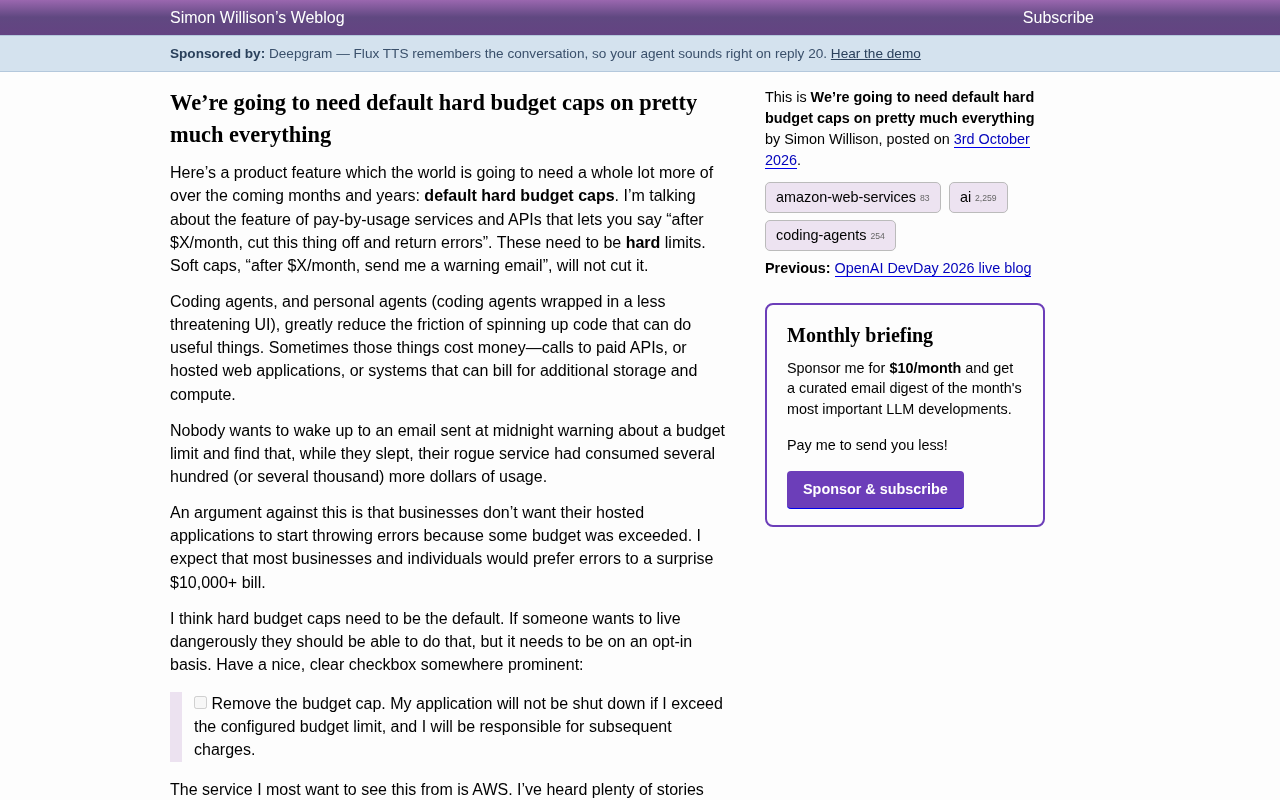
AI时代为何急需「默认硬性预算上限」?
AI编码智能体让部署付费服务变得简单,也放大了失控账单风险。本文解读为何按量计费服务应默认提供硬性预算上限,以及 AWS、Google Cloud 的最新跟进动作。

把 Tmux 当操作系统:一位开发者的理想终端 UI 构想
开发者 Mat Duggan 提出"把 Tmux 当操作系统"的大胆构想,主张以终端复用器为核心打造键盘优先的理想 OS 界面。本文解析这一理念的优势、现实挑战及其在技术社区引发的讨论。