AI偏见治理:合规勾选框还是全生命周期战略?
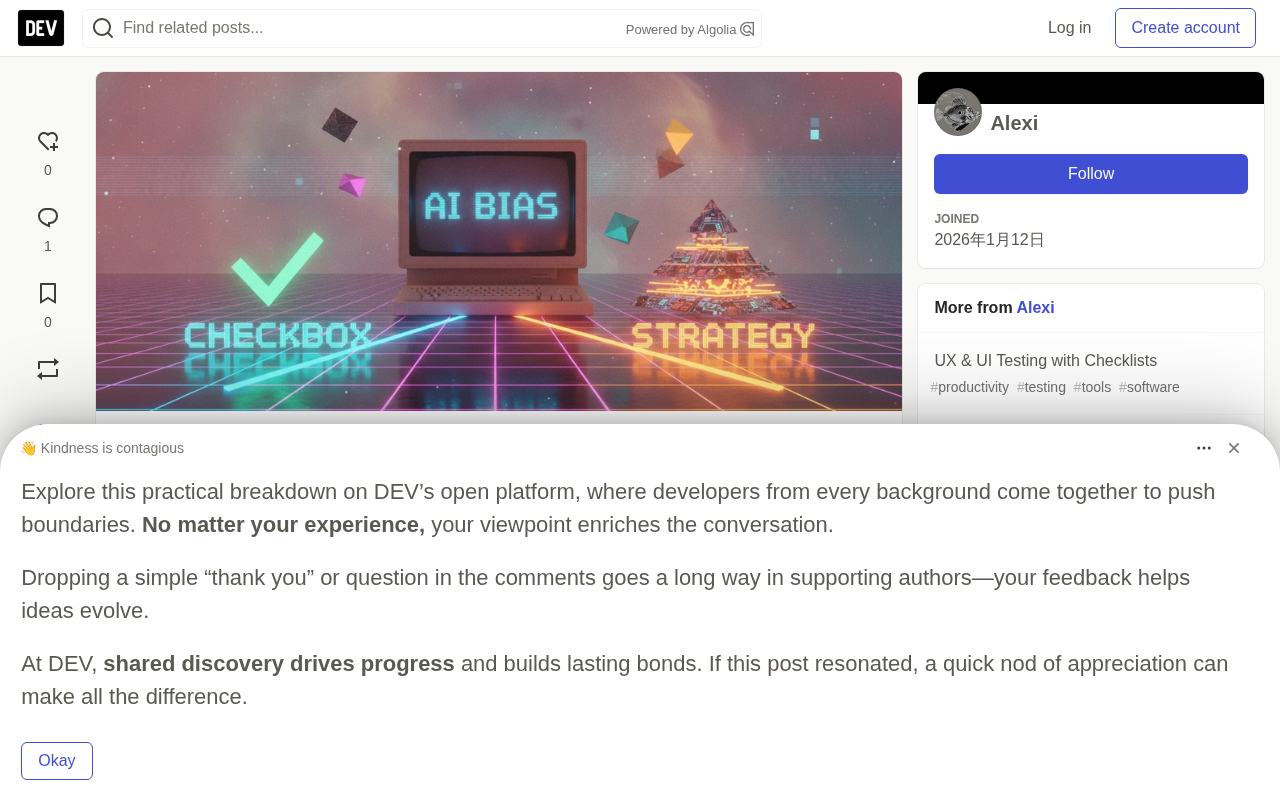
AI偏见治理的关键不是跑一次测试,而是把公平性嵌入AI全生命周期。
文章指出,当前AI公平性治理普遍陷入「合规勾选框」误区——跑一次偏见测试、归档报告便继续推进。真正区分领先者的问题是把公平性放在AI生命周期的哪个位置。文章通过三组对比拆解勾选框方法与战略方法的根本分歧:一次性测试对生命周期嵌入、纯技术指标对定量加利益相关者反馈、被动响应对主动设计。部署前测试应覆盖统计均等、机会均等与交叉性偏见评估,其中交叉性分析最易被忽略。上市后需建立实时指标追踪、阈值告警与反馈回路检测三大机制应对数据漂移。监管层面涉及EEOC与FTC的部门特定要求,合规是底线而非上限。从勾选框到战略的转变需要流程、激励、文化三个层面的组织变革。
「跑一次偏见测试,并不能让你的AI变得合乎伦理,它只是让你‘感觉’它合乎伦理。」
这句话点出了当前AI公平性治理中最普遍的误区。很多团队在模型上线前跑一遍公平性指标,生成一份报告存档,然后继续推进。这本质上是一种合规勾选框思维——把伦理当作一次性的验收动作,而非持续的产品能力。
真正区分领先者与落后者的问题不是「你有没有做偏见测试」,而是「你把公平性放在AI生命周期的哪个位置」。
勾选框方法与战略方法的根本分歧
原文列出了一组清晰的三重对比,值得逐条拆解。
一次性测试 vs 生命周期嵌入。 勾选框派的做法是:跑偏见测试 → 归档报告 → 继续下一个项目。战略派则把公平性嵌入从数据采集、特征工程、模型训练到部署监控的每个环节,让公平性成为流程的一部分,而不是流程之外的一道关卡。
纯技术指标 vs 定量+利益相关者反馈。 只盯着统计均等、机会均等等数学指标,容易遗漏指标之外的伤害。公平性指标体系是必要但不充分的——它需要与受影响群体的真实反馈结合,才能捕捉到用户实际感受到的歧视。
被动响应 vs 主动设计。 等到部署后出了问题再修补,代价远高于在设计阶段就把公平性约束写进模型架构。这本质上是「质量内建」思路在AI伦理领域的延伸。
上市前测试需要回答哪些问题
原文给出了三项关键的部署前评估维度:
跨人口群体的统计均等分析,用于检查不同群体在预测结果上的分布是否存在显著差异。这是最基础的筛查手段。
合格候选人的机会均等评估,关注的是在真正具备资格的个体中,模型是否对不同群体给予了同等机会——这比单纯的统计均等更接近实际公平诉求。
交叉性偏见评估,这一点经常被忽略。只按性别或只按种族做切片,可能掩盖「黑人女性」这类交叉群体承受的叠加歧视。单一特征分析很容易交出看起来干净的答卷,却在真实场景中持续造成伤害。
这些测试需要在部署前完成,但它们只是起点。
统计均等要求模型对受保护群体(如不同性别、种族)的正面预测比例大致相同,是数学上最容易定义的公平性准则,但它的盲点在于忽略了个体之间的资质差异——若两个群体的真实合格率本就不等,强行拉平预测比例反而可能造成逆向歧视。
机会均等则由 Hardt 等学者在 2016 年系统形式化:在真实标签为「合格」或「正例」的人群中,模型对各个群体的真阳性率应保持一致。它衡量的是「已经够格的人有没有被同等对待」,因此比统计均等更贴近就业、信贷等场景的实际公平诉求。
两者在数学上往往无法同时满足,实际部署时需要根据业务场景选择主指标,并明确记录取舍理由。
交叉性(intersectionality)概念由法学家 Kimberlé Crenshaw 于 1989 年提出,最初用于分析黑人女性在法律体系中同时遭受种族与性别双重边缘化的处境。在机器学习里,它意味着仅仅分别按性别、种族做公平性切片是不够的——算法可能在每个单一属性上看起来都很公平,却对「黑人女性」「残障移民」这类交叉群体系统性不利,因为这部分样本在训练数据中本就稀少,模型的误差会被平均化掩盖。
持续监控与法规合规
上市后进入监控阶段。原文强调三个机制:实时指标追踪、偏差超出阈值时自动告警、以及反馈回路的检测与缓解。没有这套机制,模型在数据漂移或用户行为变化后产生的偏见将无人察觉。
合规层面,原文点出了美国的具体监管框架:EEOC(平等就业机会委员会)和FTC(联邦贸易委员会)在各自领域有部门特定的要求。此外还有文档记录与透明度义务,以及利益相关者参与协议。
把合规当作底线而非上限,是战略方法与勾选框方法在监管维度上的分界线——勾选框方法以「通过审查」为目标,战略方法以「经得起持续审查」为目标。
EEOC(美国平等就业机会委员会) 负责执行《民权法案》第七章、《反就业年龄歧视法》等法律,在招聘、晋升、薪酬等雇佣场景中审查算法筛选工具是否构成差别影响(disparate impact)。2023 年以来,EEOC 多次明确其现有执法权限同样适用于自动化就业决策系统,雇主即使使用第三方AI工具也不能免除责任。
FTC(联邦贸易委员会) 的执法依据主要是《联邦贸易委员会法》第 5 条关于「不公平或欺骗性行为」的规定,关注的是算法是否存在欺骗性宣传、使用受保护数据训练、或通过不透明定价对特定群体造成损害。FTC 在 2021 年发布的 AI 使用指南中强调,声称「算法中立」却实际存在偏见,本身就可能构成欺骗。
两个机构的管辖范围不同——EEOC 聚焦雇佣领域,FTC 覆盖消费与商业行为——企业需要根据自身业务判断适用哪一套,而不能假设「通过其中一个审查」即可全面合规。
从勾选框到战略,组织需要改变什么
工具和技术只是表层,真正的转变发生在三个层面:
流程层面,需要把公平性检查点嵌入CI/CD流水线,而不是作为独立的、可跳过的审计环节。
激励层面,如果团队考核只关注准确率和交付速度,公平性就永远是负担。只有把公平性指标纳入核心KPI,战略方法才有落地动力。
文化层面,需要建立让受影响群体发声的渠道,并确保这些反馈能反过来驱动模型迭代。
AI偏见治理的难点从来不是「不知道要做什么」,而是「用什么方式做」——把它当作一份需要签字的合规文件,还是一套需要持续投入的产品能力。这个选择,决定了你的AI究竟是真正的负责任,还是只是看起来很负责任。
把公平性检查嵌入 CI/CD 流水线意味着在模型训练、评估、部署的自动化流程中设置门槛:当某次代码提交或数据更新导致公平性指标恶化超过预定阈值时,流水线自动阻断发布,与单元测试失败的处理方式一致。这要求团队预先定义好公平性指标、阈值容忍度以及触发后的处置流程,否则「嵌入」只会变成每轮发布前一次形式化的手动确认。
在激励层面,将公平性纳入 KPI 需要设计得当:如果只是把「公平性分数」作为又一个可以刷的指标,模型团队可能通过过采样或阈值调整在数字上达标,却未真正改善受影响群体的处境。较可取的实践是同时考核过程指标(如是否完成交叉性评估、是否记录取舍决策)和结果指标(如上线后监控中的群体差异),并把这些指标与晋升、奖金等长期激励挂钩,而非仅影响单次绩效评分。
相关推荐

Product Hunt 推出可视化发布编辑器,告别繁琐填写
Product Hunt 推出可视化发布编辑器,支持点击原位编辑名称、标语、画廊和 maker 信息,自动保存草稿,并用检查清单引导创作者完成发布。本文解析其编辑逻辑与对发布体验的影响。

泽连斯基亲述:俄军2000万人压境,我们如何守住基辅
泽连斯基访谈回顾俄乌战争初期:俄军200,000兵力直扑基辅,乌军主力却在东部。他讲述动员如何将军队从200,000扩张到800,000,以及基辅州、切尔尼戈夫州如何被收复。

Ovren Live Preview:用自然语言实时预览产品改动
Ovren Live Preview 是一款用自然语言描述改动、在真实页面上实时预览的 AI 开发工具。了解其核心功能、工作流、市场定位与潜在挑战。