AI热点争论:RAG已死?Skills取代MCP了吗?
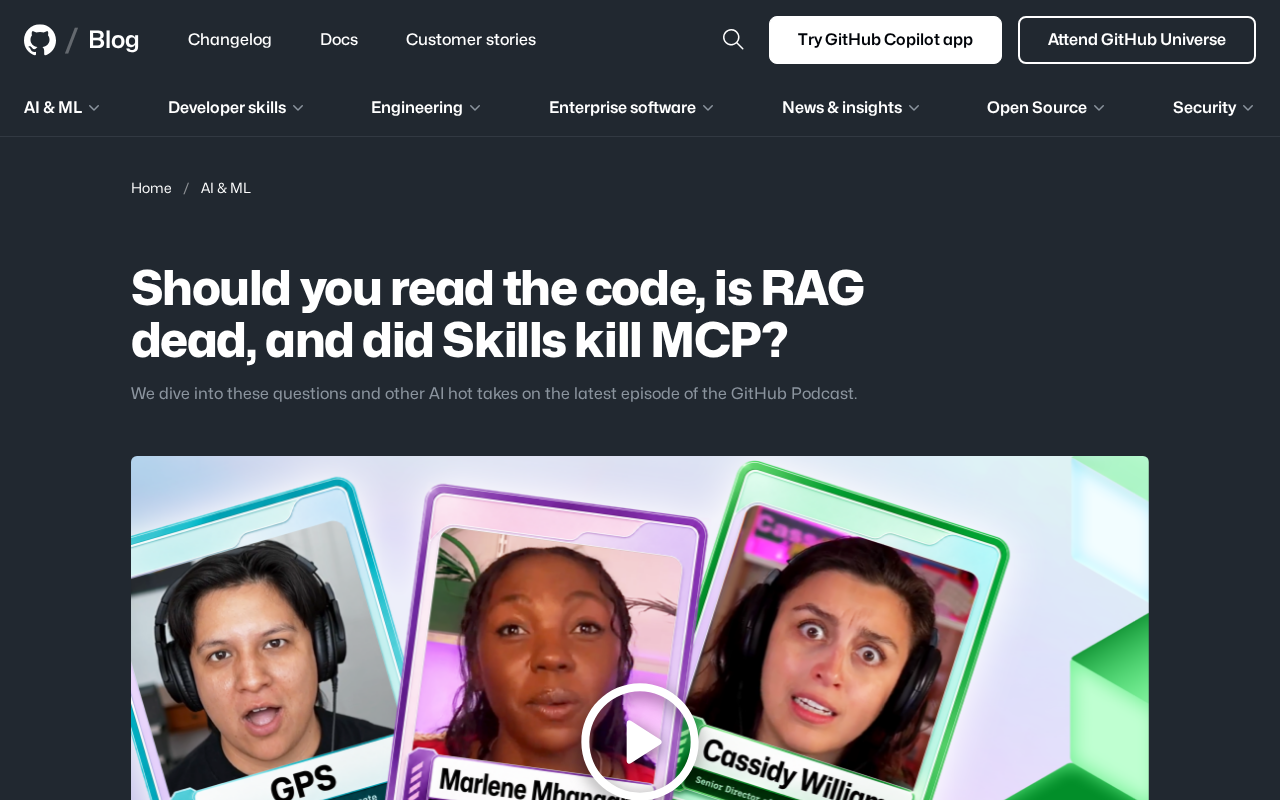
GitHub Podcast 聚焦三大AI工程争议:代码审查边界、RAG存亡与MCP对决Skills。
GitHub Podcast 最新一期围绕三个当下 AI 工程圈的热点争议展开:AI 生成代码是否还需逐行审阅、RAG 是否已被大上下文窗口淘汰、以及 Anthropic 的 Skills 是否会取代 MCP。文章逐一解析后给出结论:代码审查的重心正从「逐行正确性」向「行为可验证性」迁移,核心与安全代码仍需精读;RAG 并未消亡,而是从简单向量召回演化为融合重排序与 Agent 检索的复合架构;Skills 与 MCP 分别解决能力封装与通信协议两个不同层次的问题,前者可构建于后者之上。三个争议共同指向同一趋势:AI 工程正处于方法论快速重构期,应理解技术解决的根本问题,而非跟风「XX 已死」式的口号判断。
GitHub Podcast 最新一期节目抛出了几个当下 AI 工程圈热议的尖锐问题:AI 生成的代码到底还要不要逐行阅读?RAG(检索增强生成)是否已经过时?Anthropic 推出的 Skills 是否会终结 MCP(Model Context Protocol)?这些话题看似碎片,实则触及了当前大模型应用落地的几个核心痛点。
说明:本文基于 GitHub 官方博客发布的播客预告信息整理。由于原始素材仅提供了话题引子,以下内容结合行业背景对这几个问题进行延展解读,供读者判断参考。
AI 生成代码,到底该不该逐行读?
随着 Copilot、Claude Code 等工具让「代码由 AI 写、人来审核」成为常态,一个现实问题浮出水面:当 AI 一次生成成百上千行代码时,开发者是否还有必要像过去那样逐行审阅?
支持「必须读代码」的一方认为,代码最终由人负责,理解逻辑才能定位缺陷、承担维护责任,盲目信任生成结果会累积技术债。另一派则主张,随着测试覆盖、类型检查和运行时验证的完善,人类的注意力应该转向更高层的架构与行为验证,而非纠缠每一行实现细节。
这场争论的本质,是软件工程的信任边界正在从「代码正确性」向「行为可验证性」迁移。合理的折中或许是:核心业务逻辑与安全相关代码仍需精读,而样板代码、脚手架和测试可以更多依赖自动化把关。
RAG 真的死了吗?
「RAG 已死」是近期社区里颇具争议的判断。持此观点者的理由主要有两条:一是模型上下文窗口不断扩大,动辄数十万甚至百万 token,似乎可以「把所有资料直接塞进去」;二是 Agent 与工具调用的兴起,让模型可以主动检索而非依赖预先构建的向量库。
但把 RAG 判「死刑」显然过于草率。上下文窗口再大,也面临成本、延迟和「大海捞针」式的注意力衰减问题;把海量文档全量塞入不仅昂贵,效果也未必优于精准检索。RAG 的价值在于用相对低廉的成本,为模型提供及时、可溯源、可更新的外部知识。
更准确的说法是,RAG 并未消亡,而是在演化——从简单的「向量召回 + 拼接」走向混合检索、重排序、以及与 Agent 检索能力融合的复合架构。它正在从一个独立技术,变成智能体系统中的一个能力模块。
RAG(Retrieval-Augmented Generation,检索增强生成)的基本原理是:在向模型发送提示之前,先从外部知识库中检索与当前问题相关的文档片段,将其作为上下文一并输入,从而让模型能够回答超出其训练数据范围的问题。传统实现通常分为两个阶段:离线阶段将文档切片、向量化并存入向量数据库;在线阶段将用户查询同样向量化,通过近似最近邻搜索召回相关片段,再拼接进提示词。这种设计使知识库可以独立于模型进行更新,且每次检索都能提供可追溯的来源引用,这是纯粹依赖模型内部参数知识所无法做到的。当前的演进方向包括:将稠密向量检索与关键词检索结合的混合检索(Hybrid Search)、用交叉编码器对召回结果重新排序(Reranking),以及让 Agent 在推理过程中动态决定何时检索、检索什么的自适应 RAG 架构。
Skills 会杀死 MCP 吗?
第三个问题最具技术张力。MCP(Model Context Protocol)作为连接模型与外部工具、数据源的开放协议,一度被视为 AI 应用互操作的标准。而 Skills 概念的兴起——即让模型通过预定义的技能包扩展能力——让人担心两者是否是替代关系。
实际上,二者解决的问题层次不同。MCP 更像是一套通信与集成协议,规范模型如何访问外部资源;Skills 更偏向能力封装的组织形式,把特定任务的知识和操作打包供模型调用。理论上,Skills 完全可以构建在 MCP 之上,而非取而代之。
所谓「Skills 杀死 MCP」,更多反映的是社区对生态标准归属的焦虑——在快速迭代的 AI 工具链里,谁会成为事实标准仍未定论。与其说是谁取代谁,不如说是不同抽象层正在寻找各自的位置。
MCP(Model Context Protocol)是由 Anthropic 于 2024 年底提出的开放协议,旨在标准化 AI 模型与外部工具、数据源之间的交互方式。其设计类似于 USB-C 接口的理念——无论底层工具是文件系统、数据库还是 Web API,只要实现了 MCP 服务端,模型就可以通过统一的协议发现并调用这些能力,无需为每个工具单独开发适配层。协议定义了资源(Resources)、工具(Tools)和提示(Prompts)三类原语,并通过标准化的 JSON-RPC 消息格式进行通信。Skills 的概念则更贴近「高层封装」:将完成某一类任务所需的知识、操作步骤和工具调用组合打包,形成可被模型按需激活的能力单元。两者处于不同的抽象层次,MCP 负责解决「如何连接」,Skills 负责解决「连接之后能做什么」,因此技术上并不互斥。
这些争论说明了什么
把这三个问题放在一起看,会发现它们指向同一个趋势:AI 工程正处在方法论快速重构的阶段。工具、协议、最佳实践都在剧烈变动,昨天的共识今天就可能被挑战。
对开发者而言,与其追逐每一个「XX 已死」的标题党结论,不如理解每种技术解决的根本问题——代码审查关乎信任与责任,RAG 关乎知识供给的成本与时效,MCP 与 Skills 关乎系统的可扩展与互操作。理解了底层需求,就不容易被表面的口号带偏节奏。
小结
GitHub Podcast 抛出的这几个问题,本身没有标准答案,但它们精准捕捉了当前 AI 开发者最真实的困惑。技术演进从不是简单的替代,而是不同方案在不同场景下的动态平衡。保持对趋势的敏感,同时不盲从热点判断,才是在这个快速变化的领域里最稳妥的姿态。
相关推荐
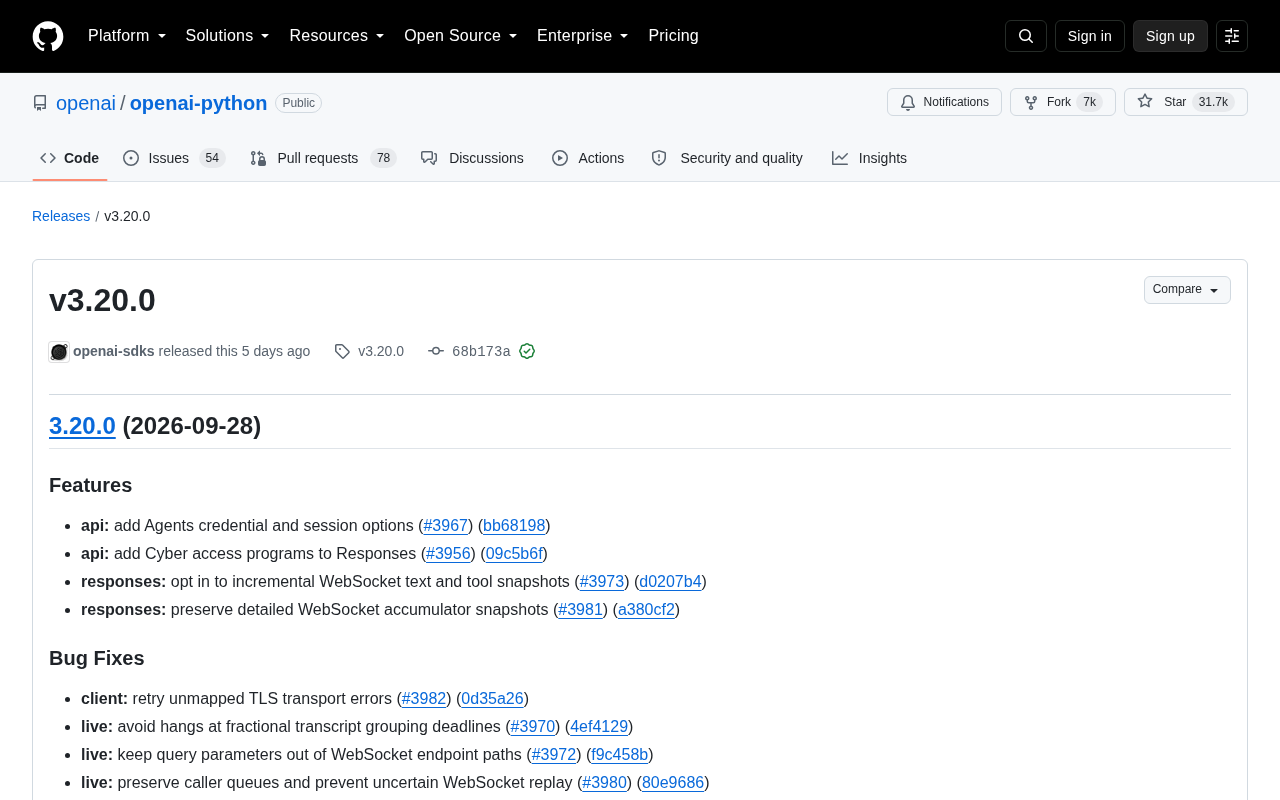
OpenAI Python SDK v3.20.0发布:Agents凭证与WebSocket增强
OpenAI 官方 Python SDK v3.20.0 正式发布,新增 Agents 凭证与会话选项、Responses WebSocket 增量快照,并集中修复实时连接稳定性问题,同时完善 API 错误响应文档。
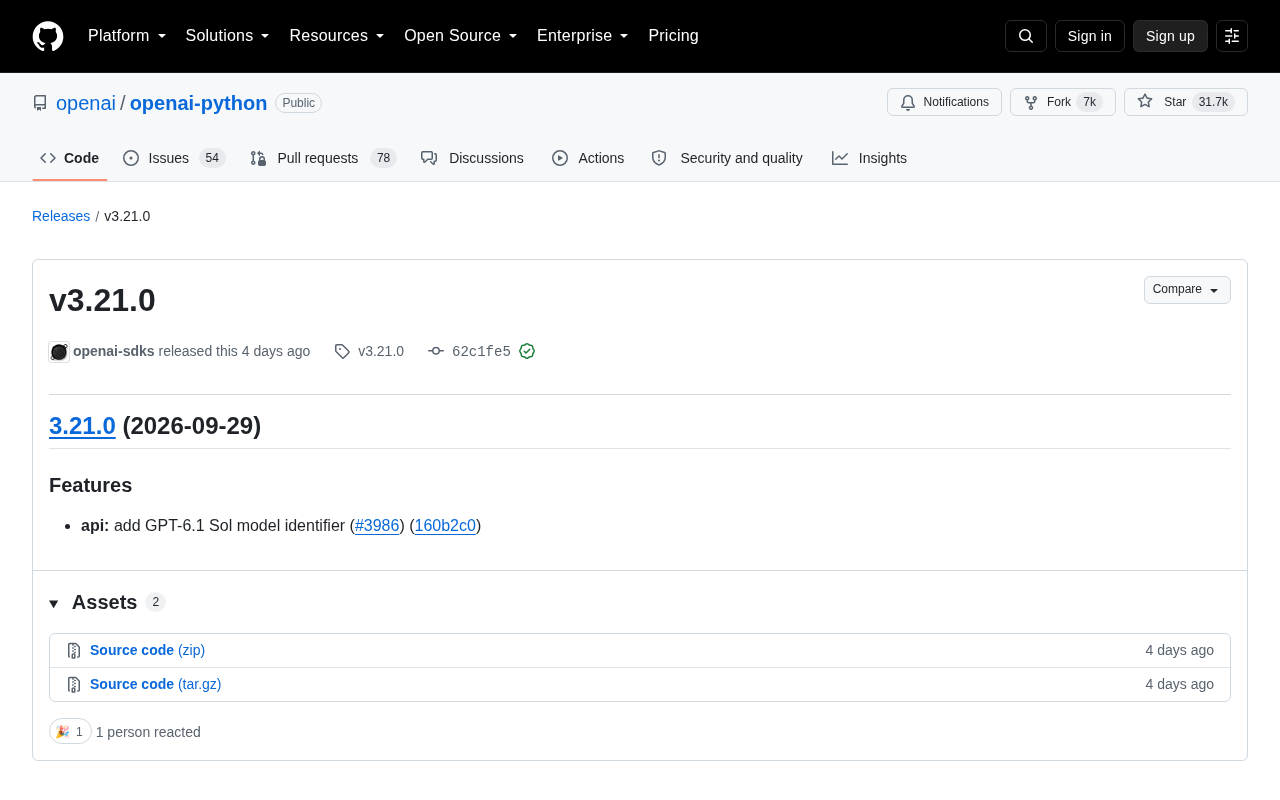
OpenAI Python SDK v3.21.0 发布:新增 GPT-6.1 Sol 模型标识
OpenAI Python SDK 发布 v3.21.0 版本,核心更新为新增 GPT-6.1 Sol 模型标识符。本文解析该更新内容、版本变化对开发者的实际影响,以及模型命名透露的信号。
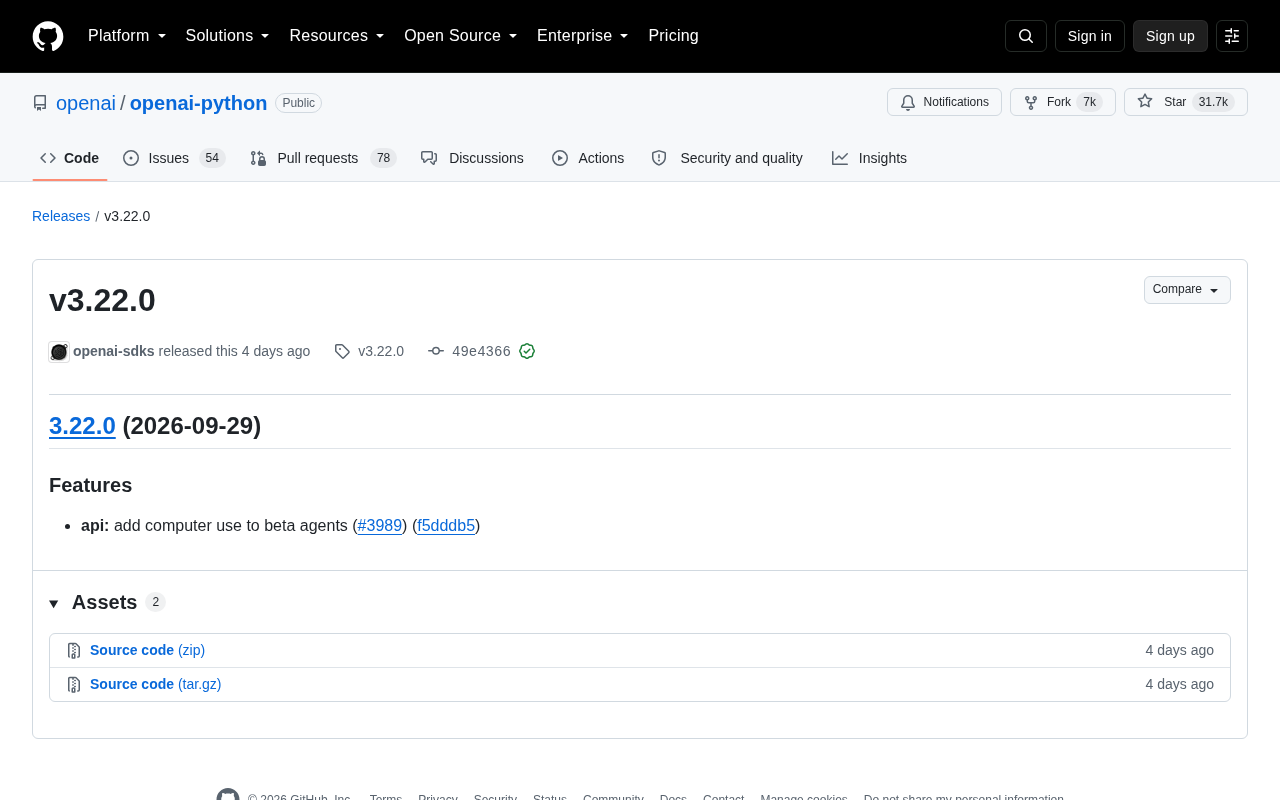
OpenAI Python SDK v3.22.0发布:Beta Agents新增计算机操作能力
OpenAI官方Python SDK发布v3.22.0版本,核心更新为beta agents新增computer use(计算机操作)能力,让AI智能体可直接操作图形界面完成复杂任务。本文解析更新内容及对开发者的影响。