AI生物武器报告引专家分裂:警世预言还是过度反应?
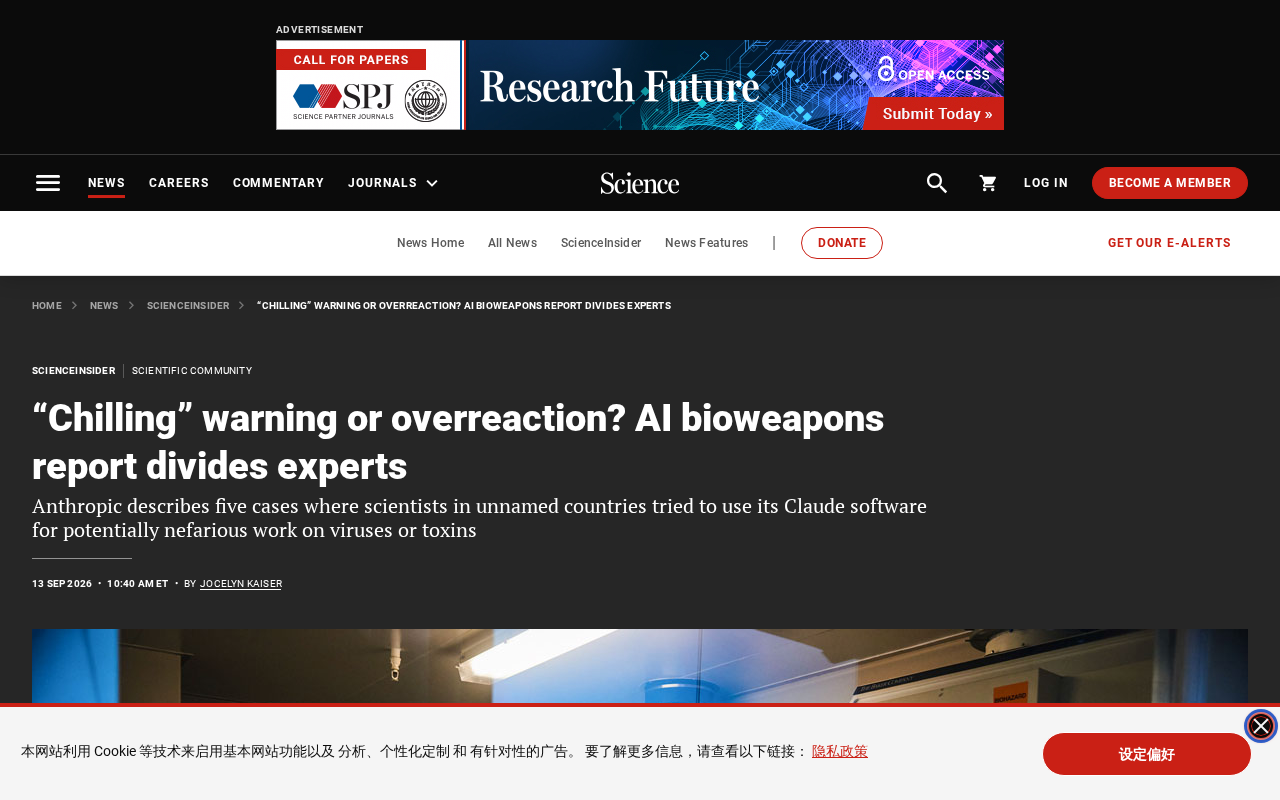
一份AI生物武器风险报告引发专家分裂,折射出AI治理在创新与安全之间的深层困境。
一份评估AI助长生物武器风险的报告在专家群体中激起截然对立的反应:警告派认为大语言模型能将原本分散的危险知识高效整合,大幅降低恶意行为者的信息获取门槛;质疑派则坚持认为物理世界的瓶颈——原料获取、实验室技能、监管规避——才是真正的障碍,AI的威胁被夸大了。这一争论难有定论,根本原因在于生物安全信息的高度敏感性造成信息不对称,加之AI能力评估本身充满变量,测试设计与场景差异均可导致截然不同的结论。文章指出,务实的应对路径在于建立由独立第三方参与的常态化红队测试机制,而非陷入非此即彼的极端立场。
AI安全争议再起:一份报告为何令专家分裂
围绕人工智能是否会助长生物武器开发的讨论,一份新报告在专家群体中激起了截然不同的反应。有人称其内容"令人不寒而栗"(chilling),警告AI大模型可能降低制造生物威胁的门槛;也有人认为这属于典型的过度反应,夸大了当前技术的实际风险。
这类争论并非首次出现,但随着大语言模型能力持续提升,其潜在的"双重用途"(dual-use)风险重新成为AI治理领域的焦点议题。所谓双重用途,指的是同一项技术既能服务于科研、医疗等正当目的,也可能被恶意行为者利用于危险场景。
争议的两种声音
警告派:AI正在降低危险知识的获取门槛
持警惕态度的专家认为,先进AI系统的核心风险不在于它能"发明"全新的生物武器,而在于它可能大幅降低获取和整合危险知识的难度。过去需要专业训练、实验经验和大量文献检索才能拼凑的信息,如今可能通过与模型的对话被更高效地组织起来。这种"能力民主化"在多数场景是福音,但在生物安全这一敏感领域却可能成为隐患。
质疑派:风险被夸大,关键瓶颈仍在物理世界
另一方则强调,制造生物武器的真正障碍从来不只是信息本身。获取原料、掌握实验室操作技能、规避监管、实现规模化——这些物理世界的瓶颈远比"查资料"更难跨越。他们认为,将AI描绘成生物威胁的加速器,可能转移了对更现实安全问题的注意力,甚至催生不必要的监管恐慌。
为何这类报告难有定论
生物武器风险评估的难点在于,它涉及大量无法公开验证的敏感信息。研究者既不能公布详细的"配方"来证明风险真实存在,也难以在不泄密的前提下让外界完整评估其结论的可靠性。这种信息不对称,使得报告的说服力高度依赖于读者对研究方法和作者立场的信任。
此外,AI能力的评估本身就充满不确定性。模型在受控测试中的表现,未必能反映真实攻击者在实际操作中的效果。测试设计、提示词方式、模型版本的差异,都可能导致截然不同的结论,这也是专家意见分裂的深层原因之一。
对AI治理的启示
无论哪一方观点更接近事实,这场争论本身凸显了AI安全治理的核心困境:如何在不扼杀技术进步的前提下,对小概率但高危害的风险做出合理防范。过度反应可能导致监管过严、创新受阻;反应不足则可能在真正的威胁出现时措手不及。
务实的路径或许在于建立可持续的评估机制——由独立第三方、AI实验室与生物安全专家共同参与,对模型进行常态化的红队测试(red-teaming),并针对确实敏感的能力设置访问限制,而非笼统地渲染恐慌或全盘否定风险。
这份引发分裂的报告,与其说是给出了答案,不如说是提出了一个AI时代必须持续面对的问题:当技术能力快速演进时,我们该以怎样的证据标准和风险容忍度来做决策。
注:本文基于Hacker News平台的一则讨论条目撰写,原始信息量有限,相关报告的具体数据与结论有待进一步查证。
相关推荐
用Claude从零构建操作系统:EMBER在真实笔记本上运行的全过程
一位开发者用Claude从零构建了名为EMBER的类DOS操作系统,几天内在真实笔记本上启动运行,支持Doom、Sound Blaster声卡模拟、触摸屏和UEFI进展。本文详解开发历程与AI辅助编程的真实体验。
Homelab被攻破实录:Nextcloud RCE漏洞与家庭服务器安全反思
一位homelab用户的Nextcloud实例因CVE-2025-66208命令注入漏洞被攻破,攻击者潜伏16小时。本文复盘攻击过程、补丁公告与实际修复脱节的隐患,并总结家庭服务器安全防护的实用建议。
DeepSeek V4.1 Flash登顶AA新基准,超越Astra引热议
DeepSeek V4.1 Flash在Artificial Analysis新推出的Intelligence Index v4.3私有基准上超越Astra登顶,同时引发社区对评测体系三天两改的争议讨论。