AI新手入门指南:从零搭建个人AI助手的三个阶段

一位商科学生的真实困惑
最近在 Reddit 上,一位商科专业的学生发布了一篇引发广泛共鸣的帖子。他坦言自己除了小时候玩过 Scratch 之外没有任何技术背景,但意识到 AI 的潜力远不止"更好用的搜索引擎",于是想打造一个能帮自己处理邮件、公告等杂务的"个人 AI 助手"。
Scratch 是由麻省理工学院媒体实验室(MIT Media Lab)于2007年推出的可视化编程语言,专为青少年设计,用户通过拖拽彩色积木块来组合程序逻辑,无需手写代码即可制作动画和互动故事,全球注册用户超过1亿。虽然 Scratch 与实际的软件开发和AI应用之间存在显著的技能跨越,但它所培养的基本逻辑思维能力——如条件判断、循环、变量等概念——对后续学习AI应用是有帮助的。
然而,当他开始研究时却陷入了信息过载的泥潭:"在碰 Claude 之前先用这 5 个仓库"、"DeepSeek广告 刚发布了新的 harness"、"有人越狱了 Qwen"……这里有必要解释这几个术语:DeepSeek 是中国AI初创公司深度求索开发的大语言模型系列,以极高的性价比和MoE(混合专家)架构引发行业关注。MoE架构是近年来大模型领域最重要的效率创新之一——传统的密集模型在每次推理时激活所有参数,而MoE将模型分成多个"专家"子网络,每次只激活其中一小部分来处理特定输入。DeepSeek-V3采用了671B总参数但每次只激活37B参数的设计,训练成本仅约557万美元,远低于同等性能的密集模型,这种架构正在改变AI行业的竞争格局。"harness"在AI语境中通常指评估框架或工具链,用于标准化测试模型性能;Qwen(通义千问广告)是阿里巴巴推出的大模型系列,"越狱"(jailbreak)指通过特殊提示词绕过模型的安全限制。这些话题虽然在技术社区中热度很高,但对于想用AI解决日常问题的普通用户来说,确实属于不必优先关注的领域。
这种信息过载现象实际上反映了AI领域一个更深层的结构性问题:技术社区(如Reddit的r/LocalLLaMA、r/MachineLearning等子版块)的讨论天然偏向前沿研究和技术细节,因为这些社区的核心用户是开发者和研究者。这造成了一种选择偏差——新手最容易接触到的内容恰恰是最不适合入门的内容。Gartner的技术成熟度曲线(Hype Cycle)理论可以帮助理解这一现象:AI工具正从"膨胀期望的峰值"向"生产力稳定期"过渡,在这个阶段,噪音信号比最高,新手最容易迷失方向。
更让他困惑的是,社交媒体上有人动辄购买三台英伟达 AI 超级计算机。他发出了许多 AI 新手共同的疑问:我到底该从哪里开始?
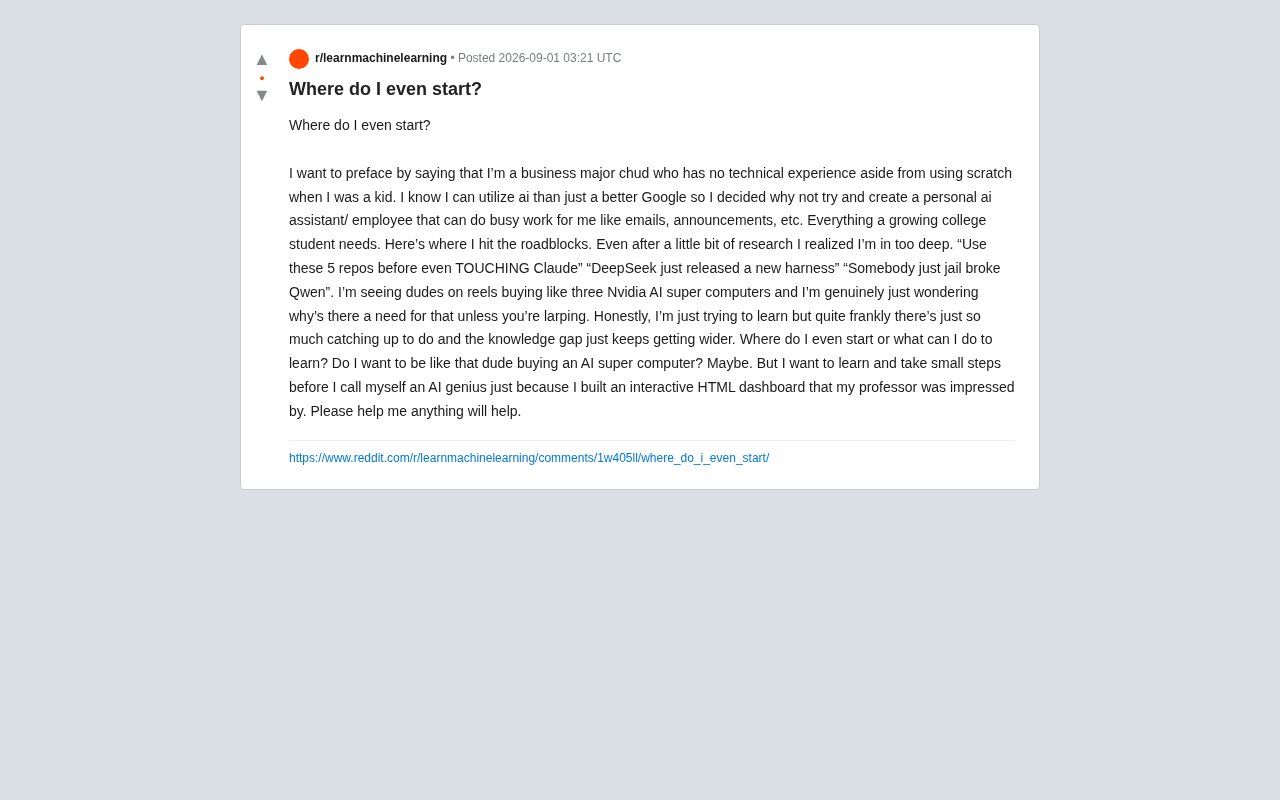
这个问题看似简单,却揭示了当下 AI 学习生态的一个核心痛点:技术迭代速度太快,知识鸿沟看起来越来越宽,导致新手在真正动手之前就被吓退了。
破除迷思:搭建AI助手不需要超级计算机
首先要澄清一个最大的误区。那位学生看到的"买三台英伟达超算"的场景,绝大多数属于两种情况:一是内容创作者的"表演"(正如他自己敏锐察觉到的"larping",即角色扮演式炫耀),二是需要在本地训练或微调大型模型的专业研究者。
英伟达(NVIDIA)推出的DGX系列AI超级计算机,单台售价从数十万到数百万美元不等,搭载H100或B200等顶级GPU芯片,专为大规模模型训练和推理设计。这些GPU之所以昂贵,是因为AI模型的训练本质上是大规模矩阵运算——需要在数十亿参数上反复执行前向传播和反向传播来优化模型权重,这种高度并行的计算任务正是GPU的强项。2025年英伟达还推出了面向个人开发者的Project DIGITS桌面级AI超算,售价约3000美元,搭载GB10 Grace Blackwell芯片。但即便是这类"平民化"产品,也主要面向需要本地运行超大模型或进行模型微调的专业用户。
对于"帮我写邮件、起草公告"这类日常需求,你需要的算力接近于零。原因很简单:
- 主流大模型都是云端服务。使用 ChatGPT、Claude、Gemini 等工具,所有计算都发生在服务商的数据中心,你只需要一台能上网的普通笔记本。当用户发送一条消息时,请求会通过互联网传输到服务商部署了数千块高性能GPU的数据中心,模型的所有推理计算在服务端完成,结果再返回给用户。这种"模型即服务"(Model-as-a-Service, MaaS)模式意味着终端设备只负责输入和显示,不承担任何AI计算负载。用户通常按免费额度或月度订阅费(如ChatGPT Plus和Claude Pro各每月20美元)使用服务,背后数百万美元的算力成本由服务商承担。这一模式与我们日常使用的流媒体服务(如Netflix)类似——视频的编解码和存储在云端完成,你的设备只负责播放。
- 本地部署也已平民化。即便你想在自己电脑上跑开源模型,通过 Ollama 这类工具,一台配备 16GB 内存的普通电脑就能运行 7B 到 14B 参数的模型,完全够用于日常任务。Ollama 是一款2023年发布的开源本地大语言模型运行工具,它将复杂的模型下载、量化、推理等步骤封装为简单的命令行操作——用户只需输入类似
ollama run llama3的命令即可运行。这里"7B到14B"中的B指十亿(Billion),7B模型约占4GB显存(4位量化后),14B模型约占8GB。量化(Quantization)是让普通电脑运行大模型的关键技术:模型的原始参数通常以16位浮点数存储,量化将这些参数压缩为更低位数的表示(如4位),从而将内存占用降低到原来的四分之一。现代量化方法(如GPTQ、AWQ、GGUF格式)通过智能的压缩策略,将精度损失控制在几乎不影响实际使用的范围内。这些规模的模型在文本生成、摘要、翻译等日常任务上表现已相当出色。与Ollama类似的工具还有LM Studio(提供图形界面)和llama.cpp(底层推理引擎),共同构成了本地AI部署的平民化生态。
那些超算是为了从头训练模型、进行大规模推理服务或前沿研究准备的。AI算力需求存在明显的层级分化:云端API调用几乎不需要本地算力,本地运行小型开源模型需要中等配置电脑,而从头训练或微调大型模型才需要专业级GPU集群。作为应用层的使用者,你和那些超算之间没有必然联系。
区分"使用者"与"研究者"两条AI学习路径
帖子中提到的"DeepSeek 新 harness"、"越狱 Qwen"这些内容,属于研究与开发层的话题。而这位学生想做的事情,属于应用层。这是两条完全不同的学习路径:
- 应用层:学会用现成的 AI 工具和 API 解决实际问题,几乎不需要深厚的技术背景。这条路径关注的是"如何用"——选择合适的模型、构建有效的提示词、设计自动化工作流、将AI能力集成到业务场景中。
- 研究层:涉及模型架构、训练技巧、对齐与安全,需要扎实的数学和编程功底。这条路径关注的是"如何造"——理解Transformer架构、损失函数优化、RLHF(基于人类反馈的强化学习)等底层技术。
对一个商科学生或零基础的AI新手来说,从应用层切入不仅门槛低,而且能最快看到成果。值得注意的是,应用层的能力在就业市场上同样价值巨大——企业对"能用AI解决业务问题的人"的需求远超对"能训练模型的研究员"的需求。
从零搭建个人AI助手的三阶段学习路线
阶段一:把AI当成"能对话的助手"来用
不要急着碰代码。第一步是深度使用现有的对话式 AI。选一款主流工具(ChatGPT 或 Claude 都可以),把你想让它做的事情——写邮件、拟公告、整理笔记——直接交给它试试。
这个阶段的核心技能是提示词工程(Prompt Engineering):学会如何清晰地描述任务、提供上下文、给出示例。提示词工程并非简单的"问问题",而是一种系统化的沟通技术。核心技巧包括:明确角色设定(如"你是一位专业的商务邮件撰写者")、提供具体的输出格式要求、给出少量示例(Few-shot Learning,即通过提供几个输入-输出范例让模型理解你的期望)、分步骤拆解复杂任务(Chain-of-Thought,链式思维推理)、以及设定约束条件(如字数、语气、目标受众)。研究表明,结构化的提示词可以将模型输出质量提升40%-60%。
值得一提的是,主流AI工具都支持"系统提示词"(System Prompt)或"自定义指令"(Custom Instructions)功能,允许你预设一段持久有效的背景指令。例如,你可以设定:"我是一名大三商科学生,经常需要撰写正式的英文邮件给教授和实习公司。请用专业但不过度正式的语气,注意使用商务邮件的标准格式。"这样每次对话时模型都会自动考虑这些上下文,无需重复说明。
你会发现,同样一个模型,提问方式不同,输出质量天差地别。这一步不需要任何编程知识,却是所有后续工作的基础。Google、OpenAI、Anthropic等公司都发布了官方的提示词工程指南,是非常好的免费学习资源。
阶段二:用无代码工具搭建AI自动化工作流
当你熟悉了对话式交互后,可以进阶到"让 AI 自动干活"。这里推荐从工作流自动化工具入手,比如 Zapier、Make,或者更 AI 原生的 n8n、Dify、Coze 等平台。
这些平台各有定位:Zapier和Make(原Integromat)是成熟的通用自动化平台,支持数千个应用集成,适合将AI作为工作流中的一个节点;n8n是开源的自托管自动化工具,灵活性更高且数据完全自主可控;Dify是一个开源的LLM应用开发平台,专注于让用户通过可视化界面编排AI能力,支持RAG(检索增强生成)、Agent工作流等高级功能;Coze(扣子)由字节跳动推出,提供中文友好的AI Bot搭建环境,支持插件调用和多轮对话设计。
RAG(检索增强生成)技术在搭建个人AI助手时特别值得关注。大语言模型的知识来自训练数据,存在知识截止日期且无法直接访问用户的私有信息。RAG通过在生成回答前先从外部知识库中检索相关文档片段,将这些上下文信息注入提示词中,使模型能基于最新、最相关的信息生成回答。对于商科学生的场景,这意味着你可以将公司邮件模板、学校公告格式、个人写作风格示例等导入知识库,让AI助手生成的内容高度贴合你的具体需求,而非泛泛的通用回复。Dify等平台已将RAG的技术实现(文档解析、文本分块、向量嵌入、相似度检索等步骤)封装为可视化操作,用户只需上传文档即可完成配置。
通过这些无代码工具,你可以搭建这样的流程:收到新邮件 → AI 自动分类并起草回复 → 发送到你的待办列表。整个过程通过拖拽节点完成,几乎不写代码,却能实现帖子作者真正想要的"个人 AI 员工"效果。
这里值得引入AI Agent(智能体)的概念:传统的AI对话是"一问一答"模式,而AI Agent能够自主规划任务、调用外部工具、执行多步操作并根据反馈调整策略。例如,一个邮件处理Agent不仅能起草回复,还能自主判断邮件优先级、查询日历确认时间安排、调用搜索引擎获取背景信息,最终交付一封完整的、考虑了全部上下文的回复。2024-2025年,Agent框架(如LangChain、AutoGen、CrewAI)和Agent产品快速发展,但大多数Agent应用仍处于早期阶段,可靠性和可控性是主要挑战。对于新手而言,理解Agent的概念有助于把握AI应用的发展方向,但实际操作仍建议从确定性更高的工作流自动化工具开始,待积累经验后再探索Agent的更多可能性。
阶段三:接触API与简单Python脚本
如果你愿意再深入一步,可以学习调用大模型的 API。API(Application Programming Interface,应用程序编程接口)是软件之间通信的标准化方式。在AI语境中,调用大模型API意味着通过编写几行代码,将你的请求发送给云端的AI模型并获取返回结果。
这时才真正需要一点点编程——Python 是最友好的选择。你不需要成为专业程序员,只要能看懂并修改示例代码即可。以OpenAI的API为例,核心步骤只有三步:注册获取API密钥、安装Python包(pip install openai)、编写调用代码(通常不超过10行)。API的计费方式通常按Token数量计算——Token是模型处理文本的基本单位,英文中大约每个单词对应1-2个Token,中文每个字约1-2个Token。以GPT-4o为例,每百万输入Token约2.5美元,一封普通邮件的处理成本可能不到0.01美元。
值得注意的是,目前几乎所有主流大模型都提供了兼容OpenAI格式的API接口(包括Claude、Gemini、DeepSeek、Qwen等),这意味着你学会了一种API调用方式,就可以几乎零成本地切换到其他模型。此外,AI编程助手(如GitHub Copilot、Cursor等)本身就能帮助零基础用户编写API调用代码——你可以用自然语言描述你想实现的功能,让AI帮你生成代码,然后运行并根据结果迭代修改,形成"用AI学AI"的正向循环。
那位学生提到自己"用 HTML 做了个让教授印象深刻的交互式仪表盘",这其实已经是很好的起点。把 AI 的 API 接入到这样的仪表盘里,就能做出一个真正属于你自己的智能应用。掌握API调用后,开发者就能将AI能力嵌入任何自定义应用中,实现高度个性化的智能功能。
给所有AI新手的心态建议
帖子作者的焦虑,本质上是"知识鸿沟恐惧"——总觉得别人已经跑得很远,自己永远追不上。但这里有一个反直觉的事实:
AI 领域没有人能真正"追上全部",包括那些看起来很厉害的人。 技术迭代太快,每个人都只能掌握其中一小块。你不需要知道 Qwen 是怎么被越狱的,就像你开车不需要懂发动机的燃烧原理一样。
这种现象在认知科学中被称为"能力错觉"(Illusion of Competence)——社交媒体上展示的技术成果经过了高度筛选和包装,一个人展示自己搭建了复杂AI系统的30秒视频,背后可能是数周的调试和无数次失败。而且AI领域的知识半衰期极短——2023年的最佳实践到2025年可能已经过时。这意味着"追赶"本身就是一个伪命题,真正重要的是建立持续学习和快速适应的能力。
几个实用的心态调整:
- 锚定目标,忽略噪音。你的目标是"帮我处理杂务",那么所有关于模型训练、越狱、超算的信息都可以直接跳过。可以用"这个信息在一周内能帮我做出东西吗"作为快速过滤标准。
- 做出来比看懂更重要。与其读一百篇教程,不如动手做一个能用的小工具。那个让教授印象深刻的仪表盘,价值远大于收藏夹里吃灰的"5 个必看仓库"。学习科学研究表明,"项目驱动学习"(Project-Based Learning)的知识留存率是被动阅读的5-10倍。
- 小步快跑,允许不完美。先做出一个只能写邮件的简陋助手,再慢慢加功能。AI 时代的学习,是螺旋上升而非线性追赶。软件开发中有一个经典概念叫MVP(最小可行产品),同样适用于AI学习:先做出能跑的最简版本,在使用中发现真正的需求,再有针对性地迭代。
结语:从今天开始,写好第一封AI辅助的邮件
这位商科学生的困惑,代表了千千万万想入门 AI 却被信息洪流淹没的普通人。答案其实很朴素:从解决你自己的真实问题开始,用最简单的工具,做出第一个能跑的东西。
你不需要英伟达超算,不需要读懂每一篇论文,更不需要在动手之前先"追平"整个行业。真正的 AI 素养,不是知道多少术语,而是能不能用它把自己的生活和工作变得更好。从今天写好一封 AI 辅助的邮件开始,你就已经上路了。
核心要点
核心要点
相关推荐

合理使用为何惠及所有人?OpenAI 发布多方案例解读
OpenAI 公开多份法院简报摘录,汇集创作者、学者、无障碍倡导者与法律专家的观点,解读合理使用如何支撑 AI 训练与创新,并分析其对开发者与内容从业者的实际影响。

AI公司联合声明:Some Thing is Happening 暗示行业变局
Hacker News热帖“Some Thing is Happening: A note from the AI companies”引发猜测。本文解析AI公司联合声明的潜在含义、行业背景及对开发者的影响。

为 NVIDIA Dynamo 构建经过验证的 Kubernetes 运行时
介绍如何为 NVIDIA Dynamo 分布式推理框架构建经过验证的 Kubernetes 运行时,涵盖驱动与容器运行时、调度配置、Dynamo 应用配置以及自动化验证等关键层次,帮助团队建立可重复的推理部署基线。