AI应用工程师面试指南:模型量化与推理部署核心考点

引言:一场典型的边缘AI岗位面试
近日,一位求职者在Reddit上分享了自己即将参加某半导体公司「AI应用工程师」(AI Application Engineer)面试的经历。这个岗位的核心要求聚焦在模型量化、推理优化以及在嵌入式系统上部署计算机视觉模型(检测、分割、BEV)。
这类岗位处于AI落地的关键环节——不是训练一个更大的模型,而是让已有模型在算力、内存、功耗都极其受限的边缘设备上高效运行。本文将围绕该职位描述(JD),系统梳理面试可能涉及的技术考点,帮助有志于进入端侧AI领域的工程师建立完整的知识框架。
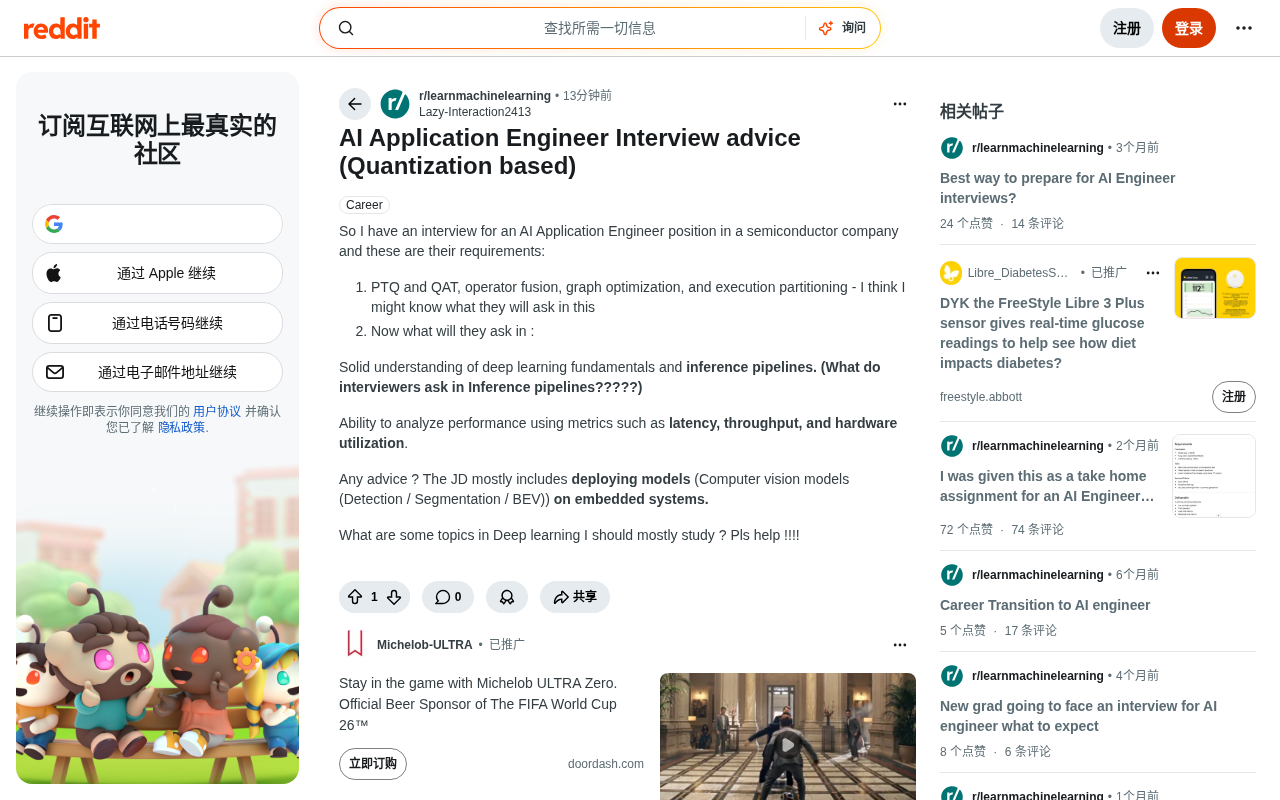
量化技术:PTQ 与 QAT 核心要点
量化(Quantization)是边缘部署的第一道关卡,也是这个岗位最核心的技能。它的本质是将模型的浮点权重和激活值(通常是FP32)映射到低位宽表示(如INT8、INT4),从而降低内存占用、提升推理速度并减少功耗。
量化技术的兴起有着深刻的硬件背景。现代神经网络动辄数亿参数,以FP32存储一个拥有1亿参数的模型需要约400MB内存,而典型的嵌入式设备往往只有几十到几百MB的可用RAM。更关键的是,整数运算单元(INT8 MAC)在芯片面积和功耗上相比浮点单元(FP32 FPU)有数量级的优势——以NVIDIA的A100为例,其INT8 Tensor Core峰值算力是FP32的8倍。这一硬件现实驱使业界将量化从「可选优化」变为「边缘部署的标配流程」。从数学本质看,INT8量化将一个浮点数 $x$ 映射为 $q = \text{round}(x / s) + z$,其中 $s$ 是缩放因子(scale),$z$ 是零点(zero point),反量化时再乘回缩放因子。这个简单的线性映射决定了量化误差的大小,也是后续所有量化方案设计的数学基础。
PTQ(训练后量化)
Post-Training Quantization 是最常用的量化方式,无需重新训练模型。面试中常见考点包括:
- 对称量化 vs 非对称量化的区别及适用场景;
- Per-tensor 与 Per-channel 量化的精度差异——卷积层的权重通常采用 per-channel 以保留精度;
- **校准(Calibration)**过程:如何用一小批有代表性的数据统计激活值分布,常见方法有 MinMax、Entropy(KL散度)、Percentile 等;
- PTQ 的精度损失来源,以及哪些层对量化敏感(如首尾层通常保留高精度)。
值得深入理解的是,PTQ校准中的KL散度方法(由NVIDIA TensorRT推广)并非单纯压缩范围,而是在信息论意义上寻找一个最优的量化分桶数,使得量化前后的概率分布差异最小化。具体而言,KL散度校准将激活值直方图截断到不同阈值 $T$,计算截断后分布与量化后分布之间的KL散度 $D_{KL}(P | Q)$,选取使散度最小的阈值作为量化范围。这在激活值分布存在长尾(如ReLU后某些通道的大离群值)时,比简单MinMax方法能取得显著更好的精度——因为MinMax会让少量离群值「撑大」整个量化范围,导致正常值的量化精度严重下降,而KL散度方法则会牺牲这些极端离群值的精度,换取绝大多数激活值更精细的量化表示。
QAT(量化感知训练)
Quantization-Aware Training 在训练过程中插入伪量化节点(fake quantization),让模型「感知」量化误差并通过反向传播进行补偿。面试重点在于:
- QAT 相比 PTQ 的精度优势与成本代价;
- **STE(Straight-Through Estimator)**如何解决量化操作不可导的问题:量化的 round 函数梯度几乎处处为零,STE 的核心思想是在前向传播中执行截断取整,但在反向传播时将梯度「直通」(即近似梯度为1),绕过了不可导的问题。这个看似简单粗暴的近似在实践中效果惊人地好,其理论合理性在于:量化噪声本质上是有界的小扰动,在参数更新步长足够小时,这种近似引入的偏差是可接受的。STE是QAT能够工作的理论基石,也是Bengio等人2013年论文正式系统化的重要贡献;
- 何时该选择 QAT——当 PTQ 精度掉点无法接受(如 INT4 或对精度极敏感的检测任务)时。值得注意的是,QAT通常需要在原始训练数据上微调10%~20%的epoch,且对学习率调度敏感,在数据受限的场景下,数据感知量化(Data-Free Quantization)等无数据方案也在快速发展。
图优化与算子融合:推理引擎层面的提速手段
JD 中提到的 operator fusion(算子融合)、graph optimization(图优化)和 execution partitioning(执行分区)都属于推理引擎层面的优化。理解这些优化手段,需要先建立对推理引擎生态的整体认知。
当前主流的推理框架各有侧重:TensorRT(NVIDIA)深度绑定CUDA生态,提供最激进的自动图优化和kernel自动调优,是车载GPU平台的首选;TVM是Apache基金会的开源深度学习编译器,通过Relay IR描述计算图,并借助AutoTVM/Ansor自动搜索最优的算子实现,具备出色的跨平台可移植性;ONNX Runtime以ONNX格式为中介,通过可插拔的Execution Provider支持CPU、CUDA、TensorRT、CoreML等多种后端,适合需要在多硬件平台间迁移的场景。理解各框架的图优化Pass(优化遍)是面试加分项,例如TensorRT的Layer Fusion会在算子图上执行模式匹配,将识别出的可融合子图替换为高效的融合Kernel。这些框架在底层都将计算图表示为有向无环图(DAG),其中节点代表算子,边代表张量数据流,图优化本质上是在这个DAG上执行等价变换以提升执行效率。
算子融合
算子融合将多个连续算子合并为一个,减少内存读写和 kernel 启动开销。最经典的例子是 Conv + BatchNorm + ReLU 融合:BN 在推理时可以直接折叠进卷积的权重和偏置中,ReLU 则作为激活直接附加。面试可能要求手推 BN 折叠的数学推导过程。
以BN折叠为例推导:设BN的参数为 $\gamma, \beta, \mu, \sigma^2$,卷积权重为 $W$,偏置为 $b$。折叠后新权重 $W' = \gamma W / \sqrt{\sigma^2 + \epsilon}$,新偏置 $b' = \gamma(b - \mu)/\sqrt{\sigma^2 + \epsilon} + \beta$。这一折叠不仅消除了推理时BN的均值减法和方差归一化运算,还消除了卷积输出到BN输入之间的中间内存读写,在内存带宽受限的边缘设备上收益显著。除Conv-BN-ReLU外,常见的融合模式还包括:Multi-Head Attention中的QKV投影融合、Transformer中的Add-LayerNorm融合,以及Element-wise算子的垂直融合(将多个逐元素操作合并为一个kernel以减少内存往返次数)。
图优化
图优化涵盖常量折叠(Constant Folding)、死节点消除(Dead Code Elimination)、算子替换、内存复用等。理解 ONNX 图结构,以及 TensorRT/TVM 等编译器如何进行图级别改写,是面试中的加分项。常量折叠会在编译期预先计算所有输入为常量的子图,例如预处理中固定的归一化参数(均值/标准差)与输入的运算可以部分折叠;内存复用(Memory Reuse)则通过分析张量的生命周期,让不同时刻存活的中间张量共享同一块物理内存,可显著降低峰值内存占用,这在RAM极其有限的MCU级设备上往往是能否部署的关键。
执行分区
执行分区指的是将计算图划分到不同的硬件单元(CPU、GPU、NPU、DSP)上异构执行。在嵌入式 SoC 中,这一步决定了整体吞吐与能效,需要理解各硬件后端支持的算子集合,以及数据在不同设备间搬运的开销。
执行分区的难点在于「算子支持度碎片化」问题:NPU通常只加速有限的标准算子集(如标准卷积、深度可分离卷积),而一旦遇到不支持的算子(如某些自定义激活函数或动态shape操作),框架会自动将该子图回退到CPU执行,这种回退会引入数据从NPU到CPU内存的搬运延迟,严重时可抵消NPU加速的全部收益。解决这一问题的工程实践包括:在模型设计阶段对齐目标硬件的算子白名单、将自定义算子替换为等价的标准算子组合、或通过厂商SDK提供的自定义算子扩展接口在NPU上注册新算子。因此,模型架构设计阶段就需要与目标硬件的算子支持列表对齐,这正是AI应用工程师需要深度参与的环节。
推理管线(Inference Pipeline)全流程拆解
这是很多候选人容易忽视的部分——推理管线并不只是模型 forward 那一步,而是指从原始输入到最终输出的完整数据流。
以计算机视觉部署为例,一个完整管线包括:
- 预处理:图像解码、缩放、归一化、色彩空间转换——这些操作在边缘设备上往往成为瓶颈,可借助 GPU 或专用硬件加速;
- 模型推理:加载量化后的模型,执行 forward;
- 后处理:如检测任务的 NMS(非极大值抑制)、分割的上采样、BEV 的坐标变换;
- 零拷贝与流水线并行:让预处理、推理、后处理三阶段流水线化,以隐藏端到端延迟。
零拷贝(Zero-Copy)技术在嵌入式平台上尤为重要。以高通Snapdragon为例,CPU、GPU和Hexagon DSP共享同一物理内存池,通过ION内存分配器可以让不同处理单元直接访问同一块物理内存,避免跨设备内存拷贝。在实际工程中,一帧1080P图像的原始数据约为6MB,若每次推理都执行CPU到NPU的内存拷贝,在30FPS的场景下每秒额外内存带宽消耗高达180MB/s,这在内存带宽本就紧张的嵌入式SoC上是不可忽视的开销。流水线并行(Pipeline Parallelism)则通过将第N帧的推理与第N+1帧的预处理重叠执行,将端到端延迟从「预处理+推理+后处理」的串行叠加,优化为接近单阶段瓶颈延迟的理想情况——这需要多线程或异步队列的工程支撑,是区分初级和资深部署工程师的重要技能点。
面试官通常想确认你是否清楚端到端延迟不等于模型推理延迟,以及如何准确定位管线中的瓶颈环节。
性能指标:延迟、吞吐与硬件利用率
JD 明确要求「使用延迟、吞吐、硬件利用率等指标分析性能」,这是端侧工程师区别于纯算法工程师的关键能力。
- 延迟(Latency):单次推理耗时,通常关注 P50/P99 分位;
- 吞吐(Throughput):单位时间处理的样本数(FPS 或 QPS),可通过 batching 提升,但会牺牲延迟;
- 硬件利用率:NPU/GPU 的算力利用率、内存带宽利用率,判断是计算受限(compute-bound)还是内存受限(memory-bound);
- Roofline 模型:理解算术强度(Arithmetic Intensity)与硬件峰值性能的关系,是分析瓶颈的理论工具。
Roofline模型是由Williams等人于2009年提出的性能分析框架,其核心洞察是:任何计算任务的实际性能上界由两条「屋脊线」决定——计算峰值(如NPU的TOPS)和内存带宽峰值(如LPDDR5的带宽上限)。算术强度(Arithmetic Intensity)定义为每字节内存访问对应的浮点运算量(FLOPs/Byte)。当一个算子的算术强度高于硬件的「屋脊点」(计算峰值/带宽峰值),该算子是计算受限的,优化方向是提升并行度或使用更高效的数学算法(如Winograd卷积可将3x3卷积的乘法次数减少约2.25倍);反之则是内存受限的,优化方向是减少内存访问(如算子融合、更激进的量化、权重共享)。以典型的1x1卷积为例,其算术强度通常在4-8 FLOPs/Byte之间,而多数嵌入式NPU的屋脊点在50-100 FLOPs/Byte,因此1x1卷积几乎总是内存受限的——这正是为什么MobileNet等轻量网络在实际部署中的加速比往往不如理论算力比所预期的那样高。掌握Roofline分析能力,意味着在拿到一个模型时,不需要实际运行就能通过统计各算子的FLOPs和访存量,预判整体性能瓶颈所在。
此外,还应熟悉常用的 profiling 工具,如 NVIDIA Nsight、TensorRT Profiler,以及各家 SoC 厂商提供的性能分析套件。
计算机视觉模型的边缘部署:检测、分割与BEV
该岗位主要部署检测、分割和 BEV(鸟瞰图)模型,这些是自动驾驶与机器人感知的核心。
BEV(Bird's Eye View,鸟瞰图)感知范式的兴起是自动驾驶感知技术的重要演进节点。传统的多传感器感知方案在各相机图像的透视视角(Perspective View)下独立完成检测,再通过几何投影将结果融合到3D空间,这种「后融合」方式在遮挡和视角不一致时存在明显局限。以特斯拉2021年发布的HydraNet和学术界的BEVFormer、LSS(Lift-Splat-Shoot)为代表的BEV方案,则直接在3D鸟瞰空间中进行特征融合和目标预测。LSS的核心思想是「提升-展开-射击」:为每个像素预测其深度分布,将2D图像特征「提升」到3D体素空间,再经过BEV池化「压缩」为俯视特征图。BEVFormer则借助Transformer的交叉注意力机制,以BEV网格点为Query,向各相机特征图做可变形注意力采样。这些模型对量化精度的要求极高——视角变换中的双线性插值和空间注意力权重对数值精度敏感,激活值分布往往存在明显的长尾,给INT8量化带来额外挑战。在实际部署中,BEV模型的视角变换(View Transformer)模块往往需要保留FP16或混合精度,而非全量INT8量化,这种「分层量化策略」是面试中值得展开讨论的工程细节。
建议重点复习以下内容:
- 检测模型:YOLO 系列、SSD 的结构,anchor 机制,以及 NMS 后处理如何在硬件上加速;
- 分割模型:编解码结构、上采样算子(转置卷积、双线性插值)的量化难点;
- BEV 模型:如 BEVFormer、LSS 等,涉及视角变换与多相机融合,其算子对量化精度和硬件支持往往提出更高挑战。
深度学习基础:扎实根基不可或缺
除了工程能力,深度学习基础理论同样是重点考察方向。建议系统复习:
- 卷积、池化、归一化、激活函数的原理与计算方式;
- 反向传播与梯度流动机制;
- 常见网络结构(ResNet、Transformer)的设计动机;
- 过拟合、正则化、损失函数设计等经典概念。
在边缘部署语境下,这些基础知识需要与硬件约束结合理解。例如,Group Normalization相比Batch Normalization在小批量推理时更稳定(BN在batch size=1时统计量方差极大),而Layer Normalization在Transformer中广泛使用但对量化更不友好——因为其归一化是在通道维度而非batch维度进行,导致每个样本的缩放因子不同,无法在推理阶段像BN那样折叠进卷积权重。RMSNorm(均方根归一化)作为LLaMA等大模型中LayerNorm的简化替代,省去了均值减法步骤,在保持训练稳定性的同时对量化略更友好,也逐渐出现在端侧视觉Transformer的设计中。理解这些细节,是回答「为什么这个模型量化后掉点严重」类问题的关键,也体现了候选人将算法设计与硬件约束贯通理解的能力。
嵌入式SoC与NPU:理解目标硬件平台
深入理解目标硬件是AI应用工程师区别于普通算法工程师的核心竞争力。当前车规和消费电子领域的主流边缘AI芯片各具特色:高通Snapdragon系列(如Snapdragon 8 Gen系列、车规SA8295)集成了Hexagon NPU,提供Hexagon SDK和SNPE/QNN框架,支持INT8/INT4量化;英伟达Jetson Orin系列面向机器人和自动驾驶,提供与桌面GPU一致的CUDA/TensorRT开发体验,是学术落地的热门平台;地平线征程系列是国内自研车规AI芯片的代表,提供BPU(Brain Processing Unit)架构和天工开物(OpenExplorer)工具链;瑞芯微RK3588则广泛应用于AIoT场景,其NPU通过RKNN-Toolkit提供一站式量化部署工具。
不同NPU的架构设计理念直接影响部署策略:脉动阵列(Systolic Array)架构(如Google TPU)对矩阵乘法极度友好但不擅长不规则访存;VLIW(超长指令字)架构(如高通Hexagon DSP)在软件流水调度上要求更精细的编译器支持。了解目标平台的算子白名单、量化约束(如某些NPU只支持per-tensor量化或不支持动态shape)和内存层级结构,是做出正确部署决策的前提。值得特别关注的是各平台的内存层级:片上SRAM(通常几百KB到几MB)、片外DRAM(通常GB级)以及各级缓存之间的带宽差异往往在10倍以上,算子调度的核心目标之一就是最大化片上SRAM的数据复用,减少对片外DRAM的访问次数——这一原则与Roofline模型的内存受限分析一脉相承。
结语:从算法到落地的工程思维
这个岗位的核心,是在精度、速度、功耗的三角约束下做工程权衡。相比追求 SOTA 精度的研究岗,AI 应用工程师更需要深入理解硬件特性、编译优化和系统级性能分析。
建议围绕「一个 CV 模型如何从 PyTorch 训练结果,一步步量化、优化、部署到嵌入式 NPU 并达到目标 FPS」这条主线来准备面试。能把整个流程讲清楚,并指出每一步的关键决策点和常见坑,就已经具备了通过面试的核心竞争力。
核心要点
核心要点
相关推荐

Agent时代科研人的AI工具边界与自动化实践
从webcoding到科研自动化,Agent工具正在改变科研工作流。本文梳理对话机器人与编程Agent的核心区别,分析多Agent分工与工具分类,并探讨AI在科研中的能力边界——科研人仍需掌握问题提出、实验设计与结果判断的核心能力。

WorkBuddy实战:桌面AI智能体自动化办公与购物全解析
深度解析腾讯WorkBuddy桌面AI智能体的核心能力:打通微信、飞书、钉钉、百度网盘,实现文件整理、周报生成、PDF数据提取与浏览器自动购物。结合B站256集实战教程,分析标准任务与审美任务的执行边界,以及OpenCLI桥接、登录态复用等落地细节。

Copilot使用指标升级:自定义技能与代理可命名追踪
GitHub Copilot使用指标更新:自定义技能、代理、MCP服务器和插件现在可按名称追踪,每个列表容量从5提升至25,帮助管理员精确评估内部AI工具的采用率与投入产出。