AI与生物安全:能力边界、威胁路径与纵深防御治理
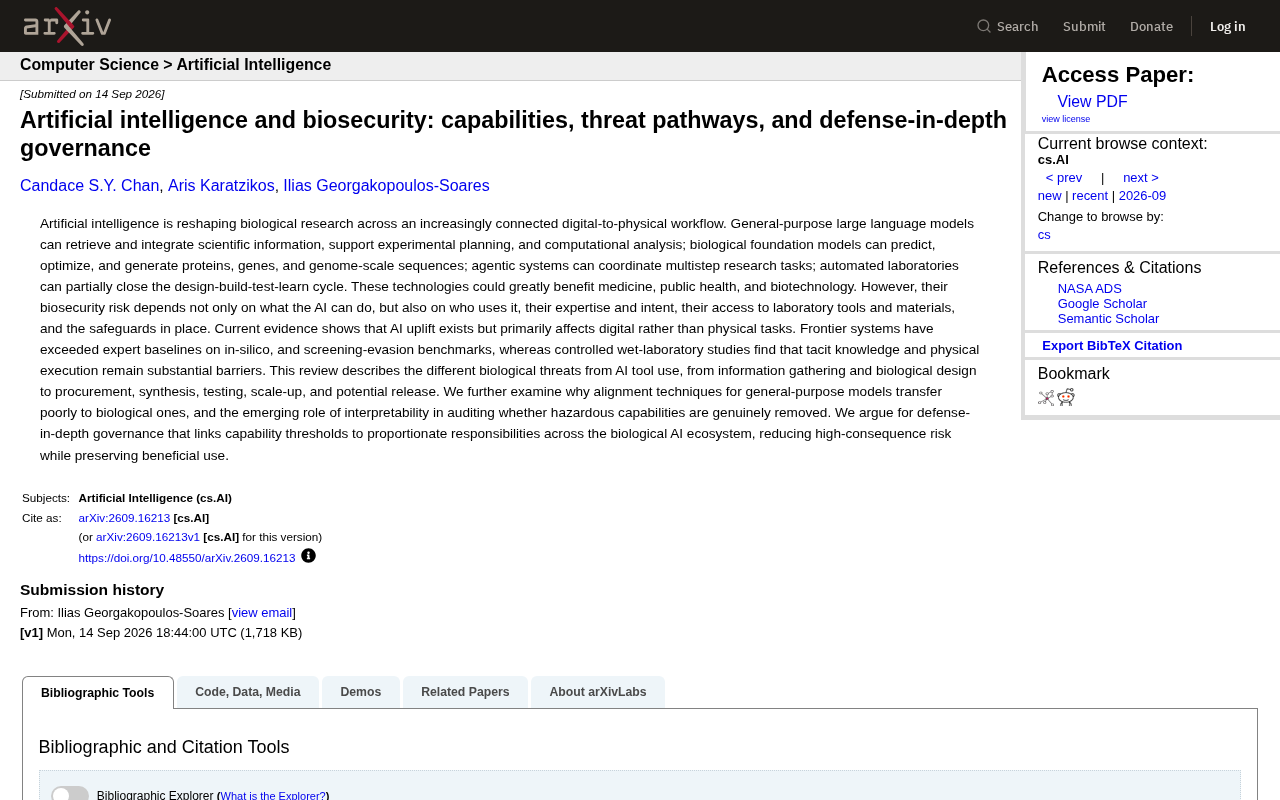
综述系统分析AI在生物领域的能力边界、威胁传导链条及纵深防御治理框架
这篇arXiv综述论文全面梳理了AI在生物研究领域的能力现状及其生物安全含义。核心判断是:AI对生物安全的影响是系统性的,取决于使用者、意图、物理准入和防护措施的共同作用,而非AI能力本身。当前AI在信息整合、序列设计等数字任务上已超越专家基线,但湿实验室的物理执行和隐性知识仍构成重大门槛。论文沿"信息获取→生物设计→采购→合成→规模化→释放"的完整链条拆解威胁路径,指出通用对齐技术难以应用于生物基础模型,可解释性审计因此成为验证危险能力是否真正被移除的关键手段。治理层面,论文主张"纵深防御"框架,将能力阈值与生态系统各方的相称责任挂钩,在降低高后果风险的同时保留AI的有益用途。
人工智能正在重塑从数字到物理的整个生物研究工作流。大型语言模型能够检索并整合科学信息、辅助实验设计与计算分析;生物基础模型可以预测、优化并生成蛋白质、基因乃至基因组规模的序列;智能体系统能够协调多步骤研究任务;自动化实验室甚至开始部分闭合"设计-构建-测试-学习"的研究循环。这些技术为医学、公共卫生和生物技术带来巨大机遇的同时,也引出了一个绕不开的问题——它们对生物安全究竟意味着什么。
一篇发表于 arXiv 的综述论文(arXiv:2609.16213)系统梳理了 AI 在生物领域的能力现状、威胁传导路径,并提出了"纵深防御"式的治理框架。文章的核心观点值得关注:AI 的生物安全风险不仅取决于"AI 能做什么",更取决于"谁在用、其专业能力与意图、能否接触实验工具与材料,以及现有的防护措施"。
AI 的能力提升:数字任务领先,物理执行仍是瓶颈
论文给出的一个关键判断是:当前证据显示 AI 确实带来了能力"提升"(uplift),但这种提升主要发生在数字任务而非物理任务上。
前沿系统在计算模拟(in-silico)和"筛查规避"(screening-evasion)等基准测试中,已经超越了专家基线水平。这意味着在信息整合、序列设计、生物计算等纯数字环节,AI 的表现相当强劲。
然而,受控的湿实验室(wet-laboratory)研究却发现,隐性知识(tacit knowledge)和物理操作执行仍然是难以逾越的障碍。换句话说,AI 可以帮你"想清楚"要做什么,但真正把实验做出来——从材料采购、合成、测试到规模化——依然高度依赖人的实操经验和物理条件。这一"数字强、物理弱"的不对称性,构成了理解当前风险边界的基础。
「隐性知识」(tacit knowledge)这一概念源自哲学家迈克尔·波兰尼,指无法完全通过语言或文字编码传递的实践性经验——即所谓"只可意会、不可言传"的技能。在湿实验室场景中,它体现为研究人员对移液手感、培养基状态、细胞活性的直觉判断,以及面对异常结果时的即时应变能力。这类知识高度个人化,需要数年实操才能积累,是当前AI系统——包括机器人自动化平台——最难以复制的部分。即便实验方案的每一步骤都被精确描述,缺乏隐性知识的操作者(无论是人还是机器)在面对真实实验中的不确定性时,成功率仍会显著低于经验丰富的科学家。这也正是论文将"物理执行"列为生物威胁链条关键瓶颈的核心依据。
威胁路径:从信息获取到潜在释放的全链条
论文并没有把 AI 的生物威胁简单化处理,而是沿着一条完整的链条逐环节拆解。这条链条包括:
- 信息收集:利用 AI 检索、整合分散的科学知识
- 生物设计:借助生物基础模型生成或优化蛋白质、基因序列
- 采购:获取实验所需的材料与试剂
- 合成:将设计转化为实际的生物分子
- 测试与规模化:验证功能并扩大生产
- 潜在释放:最终环节的风险外溢
这种分环节的视角很有价值,因为它揭示了防护应当针对不同节点采取差异化措施。前端的信息与设计环节 AI 提升明显,而后端的采购、合成、规模化则受制于物理世界的门槛。治理的重点也因此可以更精准地落在链条的关键卡点上。
通用对齐技术为何在生物模型上失灵
论文提出了一个技术层面的深刻问题:为通用大模型开发的对齐(alignment)技术,很难迁移到生物模型上。
通用语言模型的安全对齐,往往依赖于对"有害内容"的识别与拒绝。但生物基础模型处理的是蛋白质、基因、基因组序列这类高度专业的数据,其"危险能力"往往隐藏在看似中性的生成任务中,难以用通用的价值观对齐方法来约束。一个能设计有益蛋白质的模型,和一个能设计危险序列的模型,在底层能力上可能高度重叠。
正是在这一背景下,可解释性(interpretability)技术开始扮演新角色。论文指出,可解释性可用于"审计"——即验证危险能力是否真正被移除,而不只是表面上被抑制。这为生物 AI 的安全评估提供了一条与传统对齐不同的路径。
「对齐」(alignment)在AI安全语境中,指让模型的行为与人类意图和价值观保持一致的技术方向,常见手段包括基于人类反馈的强化学习(RLHF)和宪法AI(Constitutional AI)等。而「可解释性」(interpretability)研究则致力于理解神经网络内部的计算机制——哪些神经元或回路对应哪些能力,模型究竟"知道"什么。两者的区别在于:对齐主要作用于模型的输出行为层面,而可解释性深入到模型的内部表示层。在通用语言模型中,两者可以互补——先用可解释性定位危险知识的内部编码位置,再评估对齐操作是真正"抹除"了该能力,还是仅仅让模型学会了在表面上拒绝回答。对于生物模型而言,这一区分尤为重要:一个经过对齐处理的蛋白质生成模型,可能在标准测试中表现"安全",却在特定提示下依然激活危险能力。可解释性审计因此被视为比行为测试更为可靠的安全验证手段。
纵深防御治理:将能力阈值与责任匹配
面对上述复杂性,论文主张采用"纵深防御"(defense-in-depth)的治理理念。其核心逻辑是:将能力阈值(capability thresholds)与生物 AI 生态系统中各方"相称的责任"(proportionate responsibilities)挂钩。
这一思路的巧妙之处在于避免了两个极端:既不因噎废食地一刀切限制技术发展,也不放任高危能力无监管扩散。当模型能力达到某一风险阈值时,相应的开发者、部署方、实验室、供应链参与者都应承担与该风险等级相匹配的防护义务。多层防线叠加,即便单一环节失效,整体系统仍能拦截高后果风险。
论文的落脚点很明确:在降低高后果风险的同时,保留 AI 在医学、公共卫生和生物技术领域的有益用途。这是一种务实的平衡——承认技术的双重用途本质,用分层、分级、分责的治理架构来管理风险,而非简单地在"促进"与"限制"之间二选一。
「纵深防御」(defense-in-depth)原是军事与核安全领域的经典策略,后被广泛引入网络安全体系设计,其核心思想是:不依赖任何单一防线,而是构建多个相互独立的防护层,使攻击者必须同时突破多重障碍才能造成实质伤害。应用于AI生物安全治理时,这些防线可以包括:模型训练阶段的能力限制、部署阶段的访问控制与实名认证、合成生物学供应链的筛查机制(如基因合成公司的序列审核)、实验室的生物安全规程,以及监管机构的事后核查。「能力阈值」则是这套框架的量化锚点——需要通过标准化的危害评估基准来确定某一模型在哪些任务上已跨越可接受风险边界,从而触发更高级别的监管义务。这要求生物AI的安全评估本身成为一门系统性科学,而不仅仅依赖开发者的自我申报。
结语:风险取决于系统,而非单一技术
这篇综述最重要的提醒或许是:AI 生物安全并非一个孤立的技术问题,而是一个涉及能力、使用者、物理准入和防护措施的系统性问题。当前 AI 在数字环节的能力提升真实存在,但物理执行的门槛仍在;对齐技术的局限性凸显了可解释性审计的价值;而纵深防御的治理框架,则试图为这个快速演进的领域提供一套既保护又不扼杀创新的制度性答案。对于关注 AI 治理与前沿安全的研究者和政策制定者而言,这套"能力阈值—相称责任"的思路值得深入研究。
相关推荐
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。