AI语音分析自动评估运动神经元病患者语言流畅指数

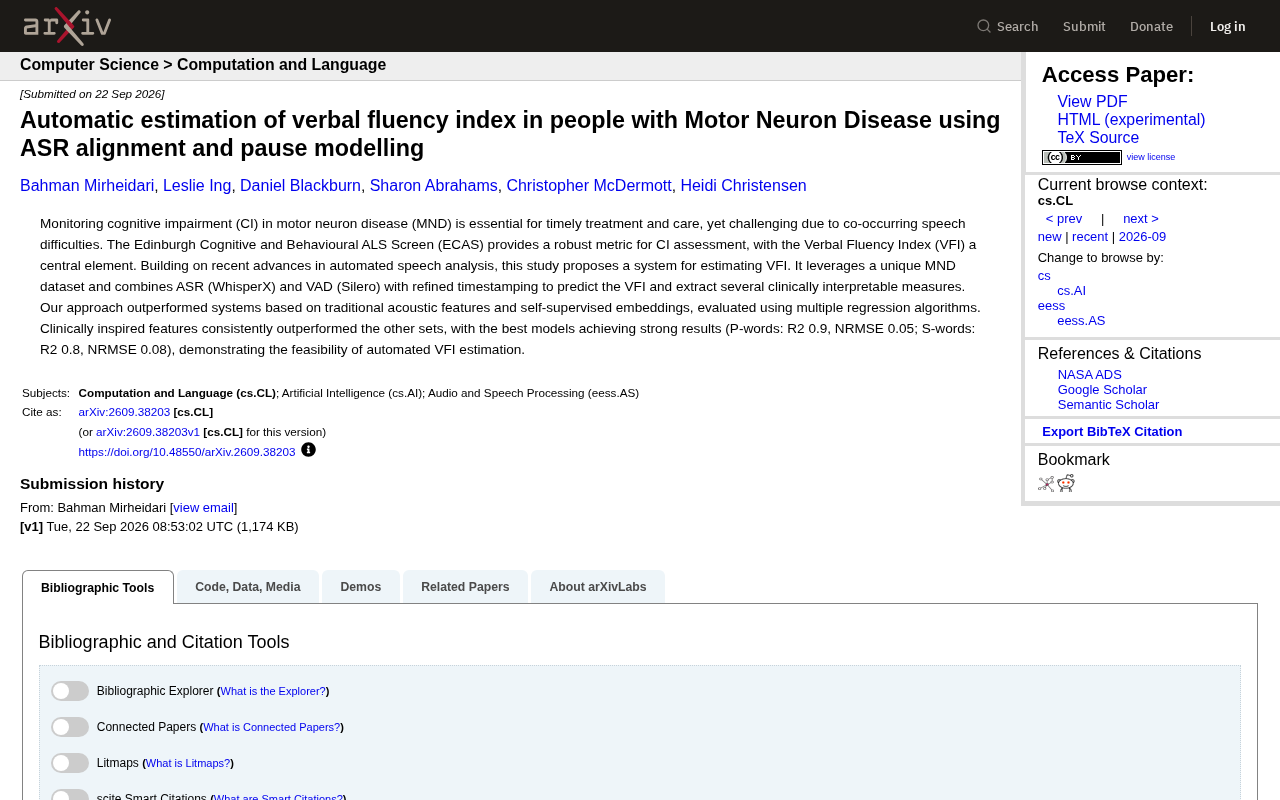
ASR对齐技术结合临床启发特征,可自动估算MND患者语言流畅指数,R²最高达0.9。
这项研究针对运动神经元病(MND)患者因言语障碍难以完成传统认知评估的痛点,提出了一套基于自动语音识别的语言流畅指数(VFI)自动估算系统。系统以WhisperX完成词级时间对齐,以Silero VAD精确检测停顿边界,进而提取停顿频率、时长等临床可解释特征。实验结果表明,临床启发特征的表现明显优于传统声学特征和自监督嵌入,P-words任务R²达0.9、NRMSE仅0.05,S-words任务R²达0.8,证明自动化评估在技术上切实可行。该研究展示了语音AI在神经退行性疾病认知监测中的应用潜力,同时也揭示了领域知识驱动的特征工程在医疗场景下兼具性能与可解释性的优势。
研究背景:为什么要监测MND患者的认知障碍
运动神经元病(Motor Neuron Disease, MND)患者在疾病进展过程中常伴随认知障碍(Cognitive Impairment, CI),及时监测这一变化对于制定治疗与护理方案至关重要。然而,由于MND患者普遍存在言语障碍,传统的认知评估手段往往难以准确执行——患者的发音困难、语速变化会干扰评估结果。
爱丁堡认知与行为ALS筛查量表(Edinburgh Cognitive and Behavioural ALS Screen, ECAS)是目前评估MND患者认知障碍的权威工具,其中**语言流畅指数(Verbal Fluency Index, VFI)**是核心指标之一。VFI通过测量患者在限定时间内生成特定词汇的能力,间接反映认知与执行功能状态。这项研究正是围绕如何实现VFI的自动化估算展开。
ECAS量表的设计初衷正是为了应对MND患者的特殊评估需求。与阿尔茨海默病常用的MMSE或MoCA量表不同,ECAS专门规避了高度依赖肢体运动或长时间口语表达的测试项目,并将认知域划分为"ALS特异性"(包括执行功能、语言、流畅性)和"ALS非特异性"(包括记忆、视空间能力)两大类。其中语言流畅指数VFI对应的是音素流畅性任务(phonemic fluency)——要求患者在60秒内尽量多地说出以某个字母开头的单词。这一任务对额叶执行功能高度敏感,约30%-50%的MND患者在此类任务中表现出明显下降,部分患者甚至最终进展为ALS合并额颞叶痴呆(ALS-FTD)。正因该指标对认知退化具有早期预警价值,实现其自动化估算才具有重要的临床意义。
技术方案:ASR对齐与停顿建模
该研究提出了一套自动估算VFI的系统,核心思路是把现代自动语音识别(ASR)技术与语音活动检测(VAD)结合起来,并辅以精细化的时间戳处理。
具体而言,系统采用了 WhisperX 作为语音识别引擎,负责将患者的语音转写为文本并提供词级时间对齐;同时引入 Silero 作为语音活动检测模块,用于精确捕捉语音段与停顿段的边界。通过对时间戳的精细化处理,系统能够识别出患者说话过程中的停顿模式(pause modelling),这些停顿信息在言语流畅性评估中具有重要的临床意义——停顿的频率与时长往往与认知负荷和词汇检索困难直接相关。
在这套框架下,研究团队不仅能够预测VFI数值,还能够提取出多个临床可解释的度量指标,这使得评估结果不再是一个黑箱输出,而是能够与临床医生的判断相互印证。
WhisperX是基于OpenAI Whisper模型的增强版本,其核心改进在于引入了强制对齐(forced alignment)机制,能够将转写文本中的每一个词精确对齐到音频时间轴上,精度可达毫秒级。这对于流畅性任务的自动评分至关重要,因为计数有效词汇不仅需要识别词语本身,还需要确认其是否在规定时间窗口内产出。Silero VAD则是一个轻量级的神经网络语音活动检测模型,能够区分语音帧与非语音帧(静音、呼吸声、背景噪声等),其优势在于对低信噪比和病理性语音的鲁棒性较好。将两者结合后,系统可以同时获得"说了什么词"和"何时说、何时停"两个维度的信息,为提取停顿频率、停顿时长、词间间隔等临床相关特征提供了基础。
实验结果:临床启发特征胜出
研究基于一个独特的MND语音数据集进行评估,并对比了多种特征提取方案与回归算法。
结果显示,该方法明显优于基于传统声学特征和自监督嵌入(self-supervised embeddings)的系统。在所有特征集中,受临床启发设计的特征(clinically inspired features)表现最为稳定和出色。具体的量化结果颇为亮眼:
- P-words(以P开头的词汇任务):R² 达到 0.9,归一化均方根误差(NRMSE)低至 0.05;
- S-words(以S开头的词汇任务):R² 达到 0.8,NRMSE 为 0.08。
这些指标意味着模型预测值与真实临床评分之间具有很强的相关性和较低的误差,证明了自动化VFI估算在技术上的可行性。
自监督嵌入(self-supervised embeddings)在这里指的是通过大规模无标注语音数据预训练得到的语音表征,典型代表包括wav2vec 2.0、HuBERT等模型输出的高维特征向量。这类嵌入能够捕捉语音的丰富声学与语言学信息,在健康人群的多项语音任务中往往表现优异。然而本研究中它们的表现不及临床启发特征,原因可能在于:MND病理语音的声学特性与预训练数据分布差异较大,导致嵌入的泛化能力受限;此外,这类高维嵌入缺乏临床可解释性,模型预测的依据难以与医生的判断相对应。R²(决定系数)衡量模型预测值对真实值方差的解释比例,0.9意味着90%的评分变异可由模型预测捕捉;NRMSE(归一化均方根误差)0.05则表示平均预测误差仅为评分范围的5%,这两项指标共同说明模型的预测精度已接近临床实用水平。
这项研究的意义与局限
从应用角度看,这项工作展示了语音AI在神经退行性疾病监测中的潜力。对于MND这类言语能力逐渐退化的疾病,一套能够自动、客观评估认知状态的系统,可以减轻临床人力负担,并实现更频繁、更一致的随访监测。
临床可解释特征的优异表现也传递出一个值得关注的信号:在医疗AI场景下,领域知识驱动的特征工程未必落后于通用的深度学习嵌入,反而在可解释性与性能上可能更胜一筹。这对于需要医生信任与临床审查的应用尤为重要。
当然,作为一项早期研究(arXiv预印本,尚未经过同行评审),它也存在局限。研究依赖于单一的MND数据集,样本规模与多样性是否足以支撑泛化能力仍有待验证;同时,P-words与S-words任务之间的性能差异(R² 0.9 vs 0.8)也提示不同任务类型对模型提出了不同挑战。未来若能在更大规模、多中心的数据上复现,这套方法才更有望走向实际临床部署。
相关推荐

支撑阻力七步法:一套可复制的交易策略拆解
一位七年经验操盘手公开其支撑阻力七步交易法:从4小时图标注高低点、设置提醒,到1分钟图寻找突破入场,固定2:1盈亏比。本文完整拆解策略流程并还原55%胜率、2.4盈亏比的真实数据,并理性分析其适用边界。

看懂n8n工作流只需四要素:触发、数据、逻辑、动作
学n8n自动化不要只会抄模板。掌握触发、数据、逻辑、动作四个核心要素,你就能看懂任何工作流、独立搭建并在出错时快速调试,从模板搬运工进阶为真正的自动化构建者。
混合RAG检索实战:Dense+BM25+RRF与重排序完整解析
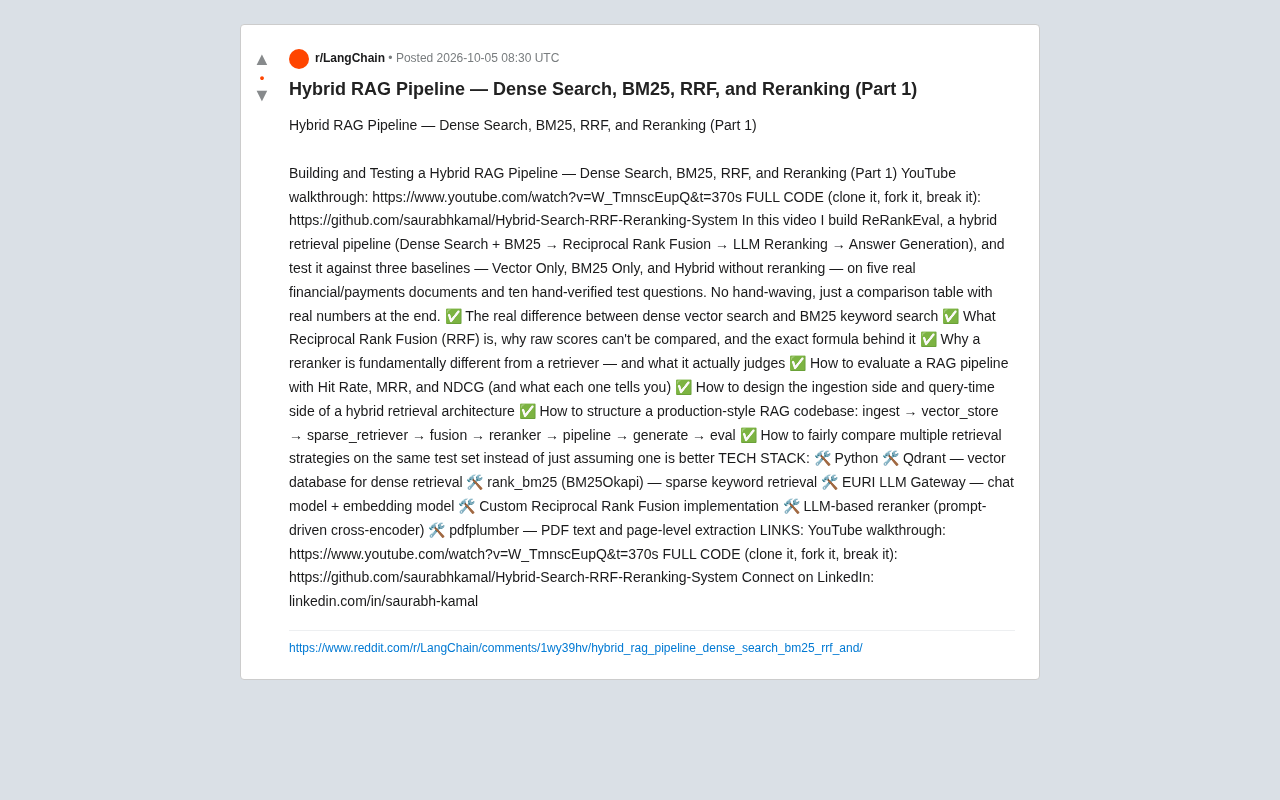
深入解析开源项目 ReRankEval 混合 RAG 检索管线:稠密向量搜索、BM25、RRF 倒数排名融合与 LLM 重排序如何协同,以及用 Hit Rate、MRR、NDCG 科学评测检索质量的完整方法。