#医疗AI
共 26 篇相关文章

MambaXray-PRB:CheXpert Plus上的X光报告生成新基准
arXiv论文提出MambaXray-PRB框架,在CheXpert Plus数据集上构建X光报告生成标准化基准,通过多阶段大模型预训练与多模态思维链推理提升性能与可解释性,并已开源代码。

HyperNSDE:用神经随机微分方程生成个性化临床数据
HyperNSDE 是一种基于神经随机微分方程(Neural SDE)与超网络的连续时间生成模型,可联合生成静态协变量、纵向轨迹与观测时刻的个性化临床数据,有效缓解医疗AI的数据稀缺与隐私难题。

RadOnc-Agent:用大模型编排放疗全流程AI工作流
arXiv论文提出RadOnc-Agent,一个由大语言模型编排的放射治疗AI智能体框架。它将放疗流程形式化为四个阶段、26个可调用函数,在单函数选择、跨阶段协同和真实病例工作流中均达96%以上完成率,验证了LLM编排架构协调异构放疗能力的技术可行性。

数字病理AI的数据集质量困局:如何区分标注不一致与域偏移
数字病理AI项目中如何区分标注不一致、域偏移与模型误差?本文结合一个真实的HER2乳腺组织肿瘤细胞检测案例,探讨计算机视觉数据集质量治理、标注者间一致性评估与标注指南设计的实用方法。

AI多阶段方案评估雄激素性脱发:从头皮图像到临床决策
一项 arXiv 最新研究提出基于 AI 的多阶段方案,用于从低倍率头皮图像评估雄激素性脱发(AGA)。系统结合 YOLOv8m 毛囊定位与 EfficientNet-B5 计数,mAP 达 0.920,为皮肤科量化诊断提供辅助决策支持。

SCOPE-4D:内窥镜4D几何基础模型如何破解手术导航难题
SCOPE-4D 是一个面向内窥镜场景的 4D 几何基础模型,可从单目视频同时预测相机参数、稠密几何与三维组织轨迹。文章解析其 SCOPE-5K 数据集、CRM 运动约束机制及在手术导航中的应用价值。
当算法决定你能住院多久:UnitedHealth 的 NHPredict 争议
美国节目《上周今夜秀》揭露 UnitedHealth 旗下公司依赖 NHPredict 算法决定患者护理保险时长,案例经理被要求偏差不超过1%,否则面临解雇。本文剖析算法治理中人类监督名存实亡的风险。

AI语音分析自动评估运动神经元病患者语言流畅指数
一项arXiv研究提出利用WhisperX语音识别与Silero停顿建模自动估算运动神经元病患者的语言流畅指数(VFI),临床启发特征表现优异,P-words任务R²达0.9,展示医疗语音AI的应用潜力。
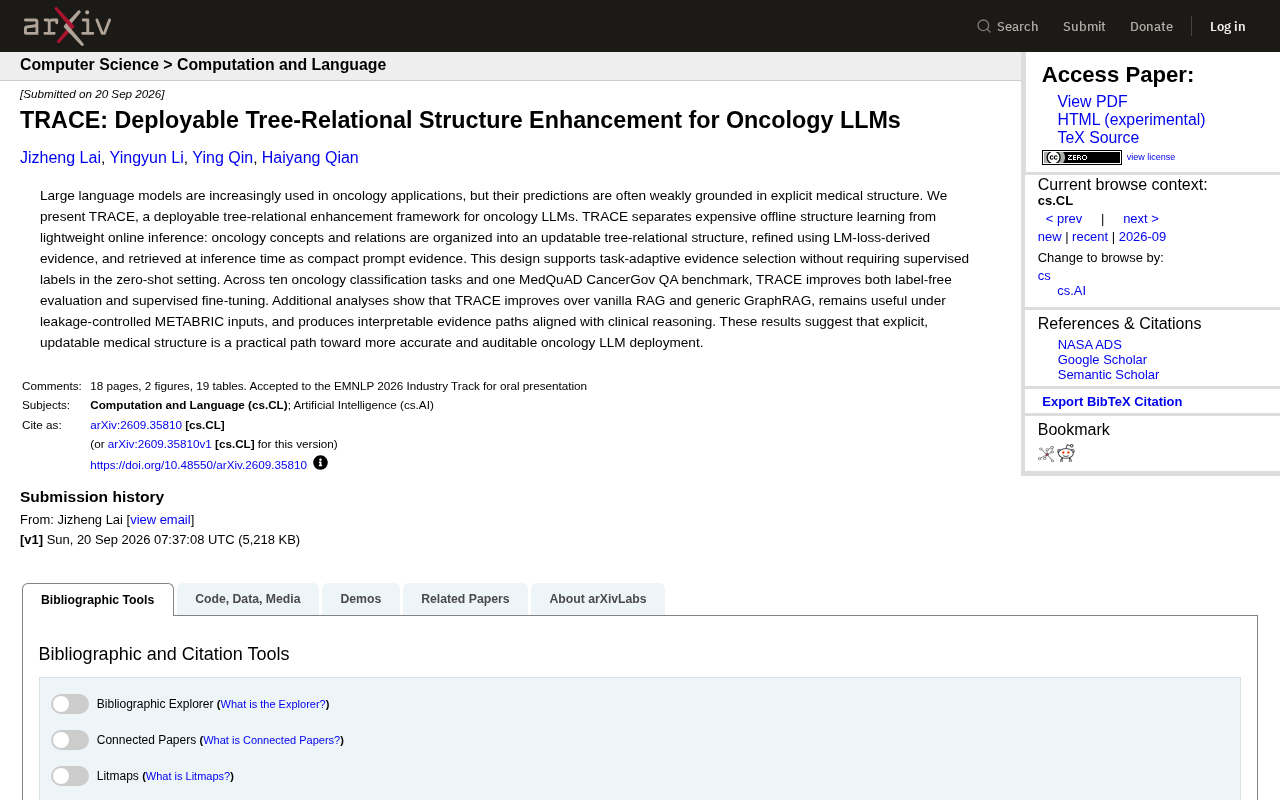
TRACE框架:用树状关系结构增强肿瘤学大模型
TRACE是一个面向肿瘤学大模型的树状关系结构增强框架,通过离线学习医学结构、在线轻量推理,在十项分类任务与问答基准上超越RAG和GraphRAG,并产出可解释的临床证据路径,为医疗LLM的可审计部署提供新思路。
临床AI治理难题:Concurrence如何用Unity Gateway管控万亿Token规模
临床AI几乎没有容错空间。本文解析 Concurrence 如何借助 Unity Gateway 在万亿Token规模下治理医疗AI,实现访问控制、合规审计与可观测性的统一,探讨医疗AI规模化落地的治理路径。

教材还是病例?数据类型如何塑造医疗大模型能力
一项 arXiv 新研究通过 token 对齐的对照实验,揭示教材数据与临床病历数据如何差异化塑造医疗大模型能力:临床数据迁移更广,教材数据偏重知识记忆,且存在知行鸿沟。医疗 LLM 数据策展应以应用为导向。

DischargeBench:让LLM学会向病人讲清出院医嘱
arXiv最新研究提出DischargeBench,一个以病人理解为核心的LLM出院教育评测框架。通过人格锚定的虚拟病人模拟和四维评分,揭示大模型在困难病人场景下的覆盖失败与理解鸿沟。
HERMES:用知识图谱从临床文本预测患者结局
arXiv 新论文提出 HERMES 框架,完全基于临床文本构建个性化知识图谱,通过对比逻辑建模与图注意力网络进行患者结局预测。在 MIMIC-III/IV 上的院内死亡率与再入院预测任务中持续超越纯文本基线。
xvr技术:AI让微创手术导航更精准安全
新型AI技术xvr通过病人特异性方法优化X射线手术导航,有望让骨科、神经外科等微创手术更安全、更精准。本文解析其原理与应用前景。

阿里巴巴开源医疗AI模型:可检测癌症及近150种疾病
阿里巴巴开源一款医疗AI模型,据报道可检测癌症及近150种健康状况。本文解析该模型的检测范围、开源策略背后的行业逻辑,以及医疗AI落地面临的临床验证与监管挑战。

谷歌AlphaGenome Atlas:预测90亿种DNA变化,破解罕见病基因之谜
谷歌DeepMind发布AlphaGenome Atlas,预测人类基因组90亿种DNA单碱基变化的分子效应,并推出AVI变异影响评分。已助力破解罕见癫痫病例的遗传学解释,为罕见病与人群研究提供强大新工具。
大模型对决中医师:真实临床案例评测揭示AI潜力与风险
一项覆盖62家医院349份真实门诊病例的研究,对比16个大语言模型与60位执业中医师的诊疗表现。结果显示顶尖大模型在治疗原则等维度评分超过医师,但在处方用药、剂量上存在偏差并暴露幻觉风险,凸显医师监督与安全约束的必要性。
LLM挖掘临床笔记特征,提升拔管失败预测精度
华盛顿大学团队提出利用大语言模型(LLM)从呼吸治疗临床笔记提取特征,结合逻辑回归提升拔管失败(EF)预测精度,并揭示了既往研究因人群和定义差异导致的泛化难题。