AI智能体开发全流程:从技术搭建到合规上线
教培AI智能体落地分三阶段:技术开发2-3个月、合规审批2-4个月、部署运维长期,合规与开发可并行以压缩周期。
文章基于北京木奇科技的多个教培垂直智能体落地经验,提出三阶段标准化流程。第一阶段用2-3个月完成底层架构与四大教学功能模块开发,核心是将苏格拉底提问法、分级纠错等教学范式工程化,并结构化导入领域知识库、优化语音多模态延迟。第二阶段用2-4个月完成深度合成算法备案、大模型上线备案等四项合规工作,且可与开发并行以缩短总周期。第三阶段为部署上线与长期运维,涵盖高并发架构、内容安全过滤与日志驱动的持续迭代。文章强调壁垒在于教学范式植入与知识库质量,合规划期应从项目首日规划。
开发一个面向教培场景的AI智能体,远不只是接入一个大模型API那么简单。从底层架构、教学功能模块,到合规备案、高并发部署,每个环节都有明确的工程要求和时间成本。北京木奇科技(原文亦写作"木极科技")基于多个教培垂直领域智能体从零到一的落地经验,给出了一套三阶段标准化流程,整体项目周期在并行推进下可控制在数月量级。
第一阶段:产品研发与技术开发(2-3个月)
这一阶段决定智能体的核心能力上限,分为底层架构搭建和教学功能模块开发两个层级推进。
底层架构:教学范式而非通用输出
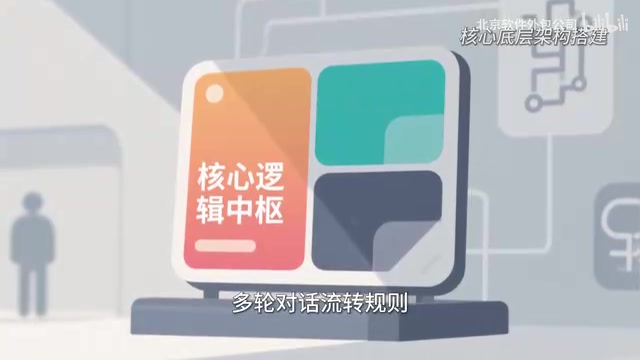
智能体的核心逻辑中枢需要定制化编排多轮对话流转规则,并处理跨教学场景的切换逻辑——例如从陪练模式切换到纠错模式时,对话上下文如何延续、教学策略如何调整。
更关键的一步,是把苏格拉底提问法、分级纠错机制等成熟教学范式深度植入系统,让智能体输出符合教学规律的引导,而不是通用大模型那种无差别的内容回答。这本质上是"教学法工程化"——把优秀教师的隐性经验转化为可执行的对话策略。
知识库层面,需要完成分级词库、语法规则、标准化教学剧本、正版授权教材的结构化导入,搭建专属领域知识库。这一步从技术层面规避了智能体输出事实性教学错误的风险,也是教育类产品与通用聊天机器人拉开差距的地方。多模态链路方面,集成工业级语音识别与合成,优化音频流实时传输路径,将端侧交互延迟压缩到用户无感知的区间。
苏格拉底提问法是一种以追问代替直接讲授的教学方法:教师不给出答案,而是通过连续、递进的问题引导学生自己发现矛盾、修正理解,最终得出正确结论。其工程化难点在于,智能体需要根据学生的回答动态判断其认知状态,再生成下一层问题,而非套用固定话术。分级纠错机制则按错误严重程度分层处理——轻微口误可忽略以保持流畅,语法硬伤才明确提示,从而在纠错与保护表达意愿之间取得平衡。
四大教学功能模块
- 精进陪练模块:支持自定义教学人设,实时双向互动,用户可随时打断且无延迟响应,目标是还原线下真实对话场景。
- 低感知实时纠错模块:识别语法、时态、搭配类偏差,生成非侵入式的隐性修正提示,不打断用户表达节奏,降低开口练习的尴尬感。
- 跟读发音评估模块:从音准、语调韵律、表达流利度等维度做量化评分。原文称其覆盖维度优于多数线下人工教学场景——这一判断缺乏第三方评测数据支撑,更适合作为产品设计目标而非定论。
- 智能助教模块:一键生成定制化习题、自动批改作业、输出个性化学情报告,压缩教培从业者的重复性劳动。
跟读发音评估的量化评分通常依赖语音识别与发音评测模型,从音素级准确度、重音与语调模式、语速与停顿等维度打分,再映射到可理解度或接近母语者的等级。需要注意,机器评分与真人教师评价的相关性取决于评测模型与语料的匹配度,不同口音、不同年龄段的学习者表现差异较大,因此评分结果更适合作为练习反馈的参考,而非绝对的能力判定。
第二阶段:合规准备与上线审批(2-4个月)
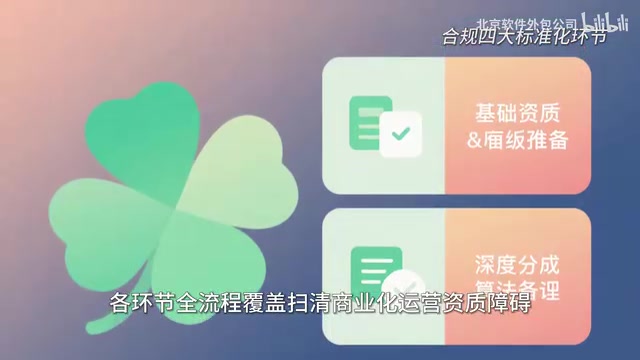
这是国内AI应用落地最容易被低估的环节。智能体要进入各大应用商店、微信小程序和网页端,需要完成一系列资质与备案工作:基础资质与备案筹备、深度合成算法备案、大模型上线备案、平台上线审核。四个环节全流程覆盖,才能扫清商业化运营的资质障碍。
你可能没注意到,合规阶段与开发阶段可以并行推进,这是压缩整体项目周期的关键。如果串行执行,两个阶段叠加可能接近半年以上;并行则能显著缩短上线时间。对计划进入教培赛道的团队来说,合规排期应当从项目第一天就纳入规划,而不是等产品做完再补。
深度合成算法备案:依据《互联网信息服务深度合成管理规定》,提供具有生成或显著改变信息内容功能的服务的,应当履行算法备案手续,在指定系统填报算法信息、应用场景等。大模型上线备案:生成式人工智能服务面向公众提供前,需按《生成式人工智能服务管理暂行办法》完成安全评估与备案,提交模型语料来源、安全措施等材料。这两项备案是教培智能体进入应用商店、小程序的前置门槛,材料准备与审核反馈通常需要数月,因此宜在开发早期并行启动。
第三阶段:部署上线与长期运维
产品上线只是开始。部署侧采用负载均衡加分布式高并发架构,将语音流处理与文本计算做分层结合,支撑千人级并发场景下的稳定运行。安全侧搭建前置敏感词过滤体系与专属安全防火墙,全链路拦截不合规的输入输出内容。
运营侧则需要持续采集真实用户行为日志,迭代优化提示词指令,定期更新知识库内容与教学语料,让智能体的教学能力持续贴合用户学习需求。这一阶段的投入往往被低估——智能体的效果衰减是真实存在的,没有持续运营,前两个阶段的工程投入会快速贬值。
几个值得关注的工程判断
从这套流程里可以提炼出几点对从业者有参考价值的判断。其一,教培智能体的壁垒不在模型本身,而在教学范式的植入深度和领域知识库的结构化质量。其二,语音交互的延迟是体验分水岭,工程上必须把端侧延迟压到用户无感知。其三,合规不是产品完成后的收尾动作,而是与开发并行的独立工程线,排期失误直接决定能否按时上线。其四,上线后的日志驱动迭代是智能体保持效果的唯一路径。
需要说明的是,本文流程描述来自服务商的单方项目经验总结,具体周期和效果指标在不同项目间可能存在差异,读者可结合自身场景评估。
相关推荐
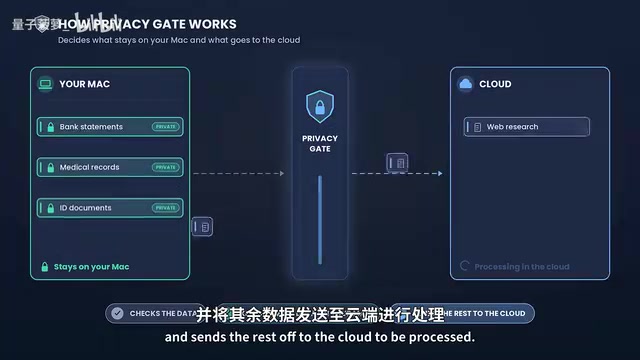
Perplexity混合计算实测:隐私数据不出Mac
Perplexity Hybrid Compute 实测:PrivacyGate 如何拦截敏感数据、本地模型与云端模型如何分工、16GB 与 32GB Mac 的模型差异,以及银行流水、医疗记录等真实场景下的隐私保护表现。
大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
B站UP主大肥鱼锐评国内外主流大模型:豆包凭情绪价值登顶,DeepSeek以开源性价比并列第一,文心、海螺、元宝、Kimi、Qwen、可灵、Claude、Gemini、Grok各被贴上鲜明人设标签。本文梳理这份「最不客观」榜单背后的产品逻辑与选型启示。
AI Agent上生产前如何真测?一套可落地的测试与监控框架
BotGage创始人Pramin Pradeep分享AI Agent上生产前的测试方法:Agent注册可见性、红队测试、生产环境可观测性三步框架,附QA成本从18万美元降至8万美元的真实案例,以及IT角色向Agent监督者转型的分析。