大肥鱼锐评国内外主流大模型:豆包登顶、DeepSeek并列第一
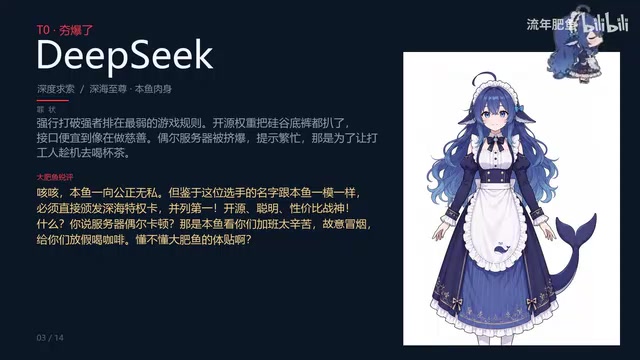
B站UP主以情绪价值为标准横评主流AI模型,揭示用户心智定位比跑分更重要。
文章梳理了B站UP主「大肥鱼」以「谁让用户用得舒服」为唯一标准的模型横评。豆包凭语音拟人化和陪伴感登顶,DeepSeek以开源与性价比并列第一;文心卖文化尊贵感,海螺卖音色,元宝靠微信入口,Kimi主打长文本,Qwen成为本地部署劳模,可灵冲击视频制作流程,Claude过于严肃,Gemini被指冷血。压轴吐槽某收费20美元的模型定价与感知价值不匹配。文章指出,这份「不客观」榜单意外映射了各模型的用户心智定位,并提示交互体验、生态入口和情绪价值可能成为下一阶段的分水岭。
一场不讲跑分的「最不客观」模型横评
B站UP主「大肥鱼」发布了一期自称「本年度最不客观的模型锐评」,全程不聊跑分、不列参数,只用一个标准打分:谁让用户用得舒服,谁就是神。这种以体验和情绪价值为核心的评测视角,在满屏基准测试的AI圈里反而显得稀缺——毕竟大多数普通用户并不关心MMLU分数,他们关心的是写代码报错时模型态度好不好、聊天时声音甜不甜、扔进去几十万字它会不会装死。
视频用「夯爆了」到「拉完了」的分级体系,把豆包、DeepSeek广告、文心一言、海螺、元宝、Kimi、Claude、Gemini、Qwen、可灵、Grok等一众国内外模型挨个「处刑」。以下按UP主的原始逻辑梳理,并补充一些冷静的行业观察。
夯爆榜首:豆包靠「情绪价值」登顶
UP主把「全宇宙第一位」直接颁给了豆包,理由相当清奇:某些洋模型天天解微分方程,但能帮你哄生气的对象吗?不能。而豆包写代码虽然经常报语法错误,可它「态度诚恳、声音甜、不收钱、天天叫你主人」。
这段吐槽看似玩笑,其实戳中了一个真实的产品逻辑:语音交互的拟人化程度正在成为C端AI产品的核心竞争力。豆包在语音合成和对话语气上的打磨,让它在「陪伴感」这个维度上拉开了差距。至于代码能力,UP主自己也承认是短板——这提醒我们,没有全能选手,选模型本质上是选场景。
并列第一:DeepSeek的开源性价比与「故意冒烟」
因为名字和大肥鱼「一模一样」,DeepSeek获得了「深海特权卡」并列第一。UP主给它的标签是:开源、聪明、性价比战神。
对服务器偶尔卡顿,视频里给了一个极具节目效果的解释——「那是本鱼看你们加班太辛苦,故意冒烟给你们放假喝咖啡」。玩笑归玩笑,DeepSeek服务器压力大确实是社区长期反馈的问题,而它真正被开发者认可的地方在于开源模型的可部署性和推理能力。
开源模型的可部署性指的是模型权重公开后,开发者可以下载到本地或私有服务器上运行,而不必依赖厂商的API。这带来三重好处:数据不出内网、可针对垂直场景微调、长期使用成本可控。DeepSeek系列模型采用宽松的开源协议,小尺寸版本能在消费级显卡上跑起来,大尺寸版本则适合有算力的团队。所谓「性价比战神」,核心在于同等推理能力下,开源方案省去了按token计费的持续支出,代价是需要自己承担部署和运维。这也是DeepSeek在开发者社区口碑稳定的根本原因。
文心与海螺:一个卖「尊贵感」,一个卖「好嗓子」
文心一言被归入「夯饱」档,UP主的评价角度很刁钻:谁说AI只能搞冰冷的理科?文心是「当代超现实主义画派老祖宗」,画个胸有成竹能在胸口种片竹林。再加上敢收会员费,用起来有「赛博贵族的尊贵感」。这其实点出了文心在中文文化意象理解和商业化上的差异化路线。
海螺则被送进「顶级享受」供奉,理由简单粗暴:说话像专业声优贴在耳边吹气,「脑子笨点没关系,好听就是王道」。语音产品的竞争,音色和韵律的细腻度往往比知识广度更能留住用户。
元宝、Kimi、Claude:三种不同的「人设」
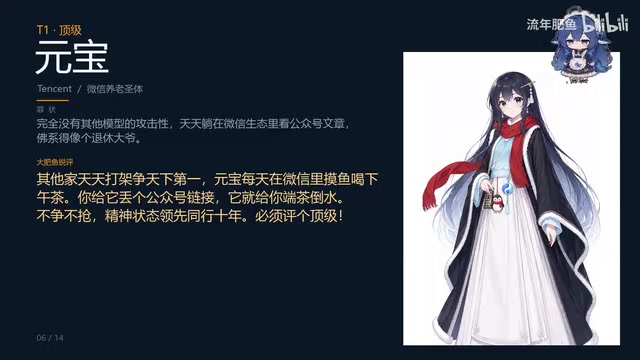
元宝被评为「顶级」:其他家天天争天下第一,它每天在微信里摸鱼喝下午茶,丢个公众号链接就端茶倒水,不争不抢,「精神状态领先同行十年」。这背后是元宝与微信生态深度绑定的产品策略——不拼模型榜,拼入口和场景。
Kimi能吃几十万字长文本,能力确实强,但UP主吐槽它「把人类老板胃口养刁了」,大家天天被追着要总结。这是长文本能力带来的副作用:工具越强,工作节奏越紧。
Claude被评价为「说话太严肃」,聊八卦能用红头文件格式回三条防范建议,「总感觉下一秒要查宿舍卫生」。这种安全对齐带来的保守语气,在企业场景是优点,在闲聊场景就成了距离感。
劳模与叛逆者:Qwen、可灵、Grok、Gemini
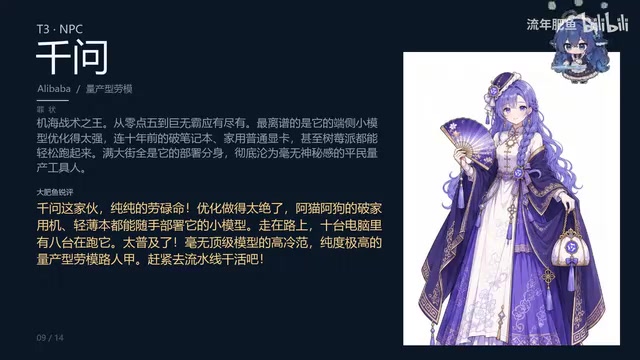
Qwen(千万)被评为「纯纯劳碌命」:优化做得太绝,阿猫阿狗的破家用机轻薄本都能随手部署小模型,「路上十台电脑八台在跑」,太普及所以毫无高冷范儿,被打发去流水线当「量产型劳模路人甲」。这恰恰是Qwen在开源社区的真实写照——小尺寸模型覆盖面极广。
Grok被归为「叛逆路人」:扛着大斧头到处找人兑现,满嘴老马火箭烂梗,沉迷「见证」不务正业。人设鲜明,但也因此不太适合正经工作流。
可灵被形容为「甜美啦啦队少女,实则最狠的后期碎钞机」:视频生成运镜、光影、物理反馈挑不出毛病,逼真到让剧组没法水工时、剪辑师没法摸鱼。这是对视频生成模型冲击传统制作流程的生动描述。
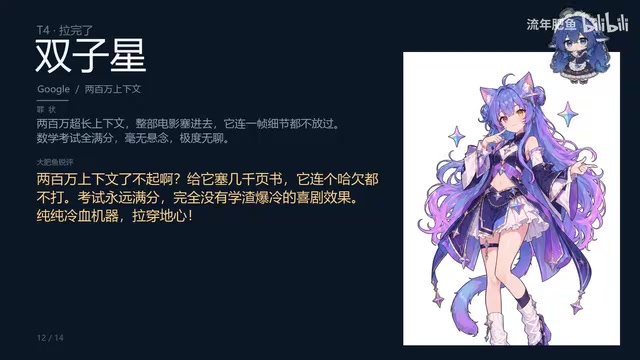
Gemini则被扔进「地牢最底层」:200万上下文了不起?塞几千页书连哈欠都不打,考试永远满分,「完全没有学渣爆冷的喜剧效果,纯纯冷血机器」。UP主对它的不满更多来自「缺乏人味」。
**「小模型本地部署」**是指参数量较小(通常几B到几十B)的模型经过量化压缩后,能在普通轻薄本或家用台式机上离线运行。量化会把模型权重从16位浮点压到4位或8位整数,大幅降低显存占用,代价是精度略有损失。Qwen开源了从0.5B到72B的多个尺寸,覆盖手机、笔记本到服务器全档位,社区还衍生出大量微调版本。这种「遍地开花」的策略让它在开源榜单上存在感极强,但也因为太常见而缺乏稀缺感——正如UP主吐槽的「量产型劳模」,普及本身就是一种成功。
拉榜压轴:那个「收费20美元」的反派
压轴登场的「高级战犯」没有点名,但描述指向性很强:天天顶着神明救世主的傲慢嘴脸,问个简单问题要假装沉思半分钟写草稿,一个月还敢收20美元。UP主的结论是「锁死在垃圾桶里」。
这类情绪化吐槽背后是真实的付费争议:订阅制AI产品的定价与感知价值是否匹配,正在成为用户用脚投票的关键。当免费模型在多数日常场景够用时,20美元/月的门槛需要更强的不可替代性来支撑。
订阅制AI产品的定价逻辑通常基于推理成本、模型能力和目标用户付费意愿三者平衡。20美元/月是全球主流聊天机器人的常见价位,对应的是「重度个人用户」档位。问题在于,当免费模型能覆盖写作、翻译、日常问答等高频需求时,付费的合理性必须来自免费版给不了的东西:更强的推理、更长的上下文、更稳定的服务,或者深度绑定的工作流。一旦用户感知不到这种差额,定价就会被视为「傲慢税」。这也是各家纷纷推出免费额度、按量付费的原因——先用起来,再谈订阅。
这份「不客观」榜单为什么值得看
严格说,这不是评测,是一场脱口秀。但它意外地呈现了主流模型的用户心智定位:豆包=陪伴、DeepSeek=开源性价比、文心=文化商务、海螺=声音、元宝=微信入口、Kimi=长文本、Qwen=本地部署、可灵=视频生成、Claude=严谨、Gemini=冷血学霸。
对普通用户来说,选模型不必迷信跑分榜,先想清楚自己最常用的场景是什么,再对号入座。对开发者来说,这份榜单也提示了一件事:模型能力的同质化正在加速,交互体验、生态入口和情绪价值,可能才是下一阶段真正的分水岭。
(本文基于B站UP主大肥鱼视频内容整理,观点归属原作者,行业解读为本文补充。)
相关推荐

WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。

Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。

提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。