AI职业进阶指南:资深数据科学家的硬核建议
三位AI从业者拆解入行误区:数学两周够用,项目比证书重要,适应力才是核心竞争力。
这篇文章整理自一档播客对话,三位数据科学领域一线从业者从实战角度回答了入门者最常见的困惑。核心观点包括:数据分析、数据科学、机器学习、深度学习是层层递进的台阶而非同义词;学习数学不必先啃三到六个月,直接进入机器学习、遇到瓶颈再回头补,整个数学基础两周可以搞定;深度学习是不可跳过的底层原理,但生产环境因可解释性、延迟和成本倾向于少用它;简历上只有能"辩护"的真实项目才有价值,技能堆砌反而是红灯;提示工程不是消亡而是普及化;面对AI热点应保持冷静,真正无法被替代的是创造力、问题解决能力和持续快速学习的适应力。
数据分析、数据科学、机器学习、深度学习、AI——这些词汇如今无处不在,但对想进入这个领域的人来说,它们带来的困惑往往多于兴奋。从哪里开始?要学多少?证书够用吗?在AI飞速发展的当下,你是不是已经落后了?
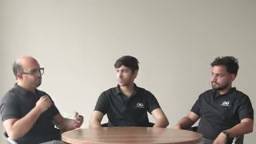
Geeks for Geeks的一档播客邀请了三位一线从业者——拥有11年AI经验、现任数据科学总监的Sampoon Ratan Jain,数据科学家兼导师Jain,以及深耕机器学习课程五年的Ashish——从实战角度拆解了这些问题。以下是这场对话中最值得记住的观点。
这些名词不是同义词,而是台阶
很多人把数据分析、数据科学、机器学习混为一谈。三位嘉宾的共识是:它们是层层递进的台阶,而非可互换的概念。
Sampoon把终极目标称为"全栈数据科学家"——一个人应当能搭建仪表盘、做探索性数据分析、构建机器学习模型、写提示词、实现RAG方案,甚至设计agentic AI系统。"要学的东西确实很多,但数据科学家确实需要全部掌握,只是不同岗位在各项上的深度要求不同。"
Ashish补充了一个实用的分流建议:当有人说"我想进入AI"时,他会先问对方是想转行做AI还是想把AI融入现有工作流。如果你已经是设计师或剪辑师,那就直接用市面上的AI工具让自己效率提升10倍、20倍;如果是想从零起步做AI职业,那就从基础打起,同时并行学习Gen AI方向的项目——因为在Gen AI这条路上更容易建立职业起点。
学得越多≠越有竞争力
一个反直觉的观点贯穿全场:技能堆砌是陷阱。
很多学习者觉得自己Python、SQL、统计、ML、深度学习、云、MLOps什么都懂,但Jain指出,如果不能把这些技能应用到有意义的项目中去解决实际问题,学习就永远没有尽头。"与其学一万种技能,不如学好几个能成为项目基石的东西,然后真正做出一个能放进简历、也能证明你所学的项目。"
Sampoon用自己2015年入行时的经历作类比:"当年我也觉得要学的东西太多,11年过去了,2026年的人还是这么觉得,10年后依然如此。"他点破了一个教育的本质——你最终只会用到所学的10%,但没人能提前知道是哪10%,所以学校才把什么都教给你。动手做项目,是发现自己那关键10%的最快方式。
数学没那么可怕,两周足够
针对初学者对机器学习数学的恐惧,Sampoon给出了一个大胆判断:数据科学所需的全部数学,两周就能搞定。
他解释说,机器学习分为代码和数学两部分。代码部分如今极其简单,一个算法就四五行;难的仍然是数据清洗。而数学部分被很多人当成"大灰狼",其实只需要"挑重点"——你不需要背矩阵乘法、点积的所有复杂公式,只需要理解"把这个输入丢进点积,会得到什么输出"这种概念层面的认知。
具体需要学什么?统计基础、概率、矩阵乘法基础,以及微积分中的微分、链式法则和偏导数。"面试官不会让你写出PCA或SVM的公式,他们关心的是你理解不理解这个方程为什么被用、输入是什么、输出该如何解读。"
Ashish给出了正确的学习顺序:不要先花三到六个月啃完数学再进机器学习,而应直接进入机器学习,遇到需要深挖的数学概念再回头补。这样整条路径能在两周内走完,否则轻则三个月、重则一年。
深度学习不能跳过,但生产环境在"少用"它
关于是否必须学深度学习,嘉宾们态度一致:不能跳过。
Jain用工具箱作比喻——自行车能做卡车做不到的事,卡车也能做自行车做不到的事,深度学习只是工具箱里的另一件工具。Sampoon则点明了更深的逻辑链:所有生成式AI模型本质都是深度学习模型。不懂深度学习,就不知道如何定制Gen AI模型;不懂CNN就处理不了图像;不懂RNN就理解不了为什么Transformer成为主流。
但他也观察到一个有趣的行业趋势:生产环境在"尽可能少用"深度学习。原因有三——可解释性(银行反欺诈仍用机器学习算法,因为需要解释性)、延迟(机器学习响应是毫秒级,深度学习和Gen AI要好几秒,想象一下UPI支付要等10秒)、以及成本(大型深度学习模型即便做推理也需要GPU)。所以大量生产模型要么是机器学习,要么是Gen AI,但深度学习作为底层原理,人人都得懂。
Transformer与RNN的历史脉络值得单独说明。RNN(循环神经网络)是处理序列数据的早期架构,通过"记忆"前序信息来理解上下文,但存在长距离依赖难以捕捉、训练速度慢等缺陷。2017年Google发布的论文《Attention Is All You Need》提出了Transformer架构,完全基于自注意力机制(Self-Attention),彻底抛弃了RNN的递归结构,既解决了长距离依赖问题,又天然支持并行计算。如今几乎所有主流大语言模型(GPT、Claude、Gemini等)都以Transformer为骨架。理解RNN的局限性,正是理解Transformer为何能成为主流的前提——这正是文中所说"不懂RNN就理解不了Transformer"的含义。
提示工程已死?它只是变成了人人都会的技能
Jain复盘了提示工程的兴衰:2022年人人都想当提示工程师,公司也开出高薪;到2024年这个岗位几乎消失。
他的解读很到位:提示工程从未消失,只是从一项独立技能变成了人人都掌握的通用能力。当医生、律师这些领域专家都开始用LLM时,一个懂本行框架的医生显然能为医疗模型写出比外行更好的提示词。所以提示工程"悄然失去了作为独立职业的意义"——不是没用了,而是太普及了。
**"上下文工程"(Context Engineering)**是2025年前后兴起的新概念,由Andrej Karpathy等人推广,被部分从业者视为提示工程的进化版。其核心主张是:真正决定LLM输出质量的,不只是提示词的措辞,而是你为模型精心构建的整个上下文——包括系统提示、检索到的文档、工具调用结果、历史对话、少样本示例等所有信息的组织方式与优先级。文中嘉宾将"上下文工程"与"提示工程"并列作为热词来调侃,正是因为这类新概念在实践落地前往往经历一段炒作高峰,随后要么融入常规工程实践、要么悄然消退——这也是他建议"等一等看一看"的依据。
简历上,只有"作品"和"可辩护性"重要
谈到招聘,Sampoon的态度斩钉截铁:只看项目。
"我不在乎你叫数据科学家、数据工程师还是ML工程师,甚至Excel工程师。只有项目重要,是能证明你真实能力的作品。"而且这个作品你要能在面试中"defend"(辩护)——为什么选这个模型?为什么用这个特征工程?为什么这个提示词?部署在哪里?所有的"为什么"你都答得上来,才算你真懂。
最大的简历红灯是什么?技能堆太多。HTML、Excel、邮件写作这类被默认具备的技能不该出现,Sampoon甚至见过有人把"电脑"写进技能栏。他建议花整整一周打磨简历,并做到机器可读。
至于证书,共识是作品优先于证书。但有实操、有作业、有真实项目支撑的结构化证书仍有价值,Jain用"驾照"作比:会开车是能力,但要让别人信任你上车,你需要一张驾照来建立可信度。同时嘉宾也调侃,证书的分量更多取决于发证机构的信誉——毕竟"你可以让Gemini生成一张证书"(当然带水印)。
别追热点,追"可迁移的底层能力"
面对"AI每天都有新工具,是不是要全学"的焦虑,Sampoon给出了一个身处AI行业却反常识的建议:主动回避AI新闻。
"AI炒作太多了。提示工程岗位来了半年就消失,上下文工程来了半年也没人提了。你不需要学所有东西,等一等看一看,真正好的工具会熬过炒作期,那时你再去适应它。适应力(adaptability)才是每个技术人的核心能力。"
Ashish则给出了一个可操作的项目选题方法:去你想应聘的公司的JD里找最高频的10个关键词,围绕共性关键词做项目。如果RAG是热词,就想清楚哪个行业最适合RAG、有哪些数据集、用什么分块技术,然后深挖每种技术的差异。"库和数据库都一样,变的只是场景。而且如今建项目不难,难的是部署——每加一个功能就部署一次,发到LinkedIn上获取免费的自然流量和反馈,快速构建、更快失败。"
Jain的收尾观点最有分量:真正无法被AI替代的,不是某个工具或语言,而是创造力、解决问题的能力、公众表达和沟通能力。"往内看,而不是往外看。有了这些,无论去哪个领域,AI也好、竞争也好,都替代不了你。"
**RAG(检索增强生成)**是当前企业落地大语言模型最主流的技术方案之一。其核心思路是:不对LLM本身进行昂贵的微调,而是在推理时动态检索外部知识库中的相关文档片段,将其作为上下文一并输入模型,从而让模型能回答训练数据之外的私有或实时信息。典型流程包括文档分块(Chunking)、向量化(Embedding)、存入向量数据库、用户提问时相似度检索、拼接上下文后生成回答。文中提到的"分块技术"正是RAG工程化中的关键细节——不同的分块策略(固定长度、语义分块、递归分块)会显著影响检索质量和最终回答的准确性。
结语:闭嘴,去做
当被问到"AI跑得太快,别人都比我早开始,我是不是已经太迟了"时,Sampoon的回答简单粗暴:"Shut up and do it(闭嘴,去做)。担心做这件事不等于做这件事,计划做不等于做,想着做也不等于做——做,才是做。"
他提醒,AI研究自1954年就已存在,中间经历了近40年的"AI寒冬",如今只是"AI之春"。真正该学的唯一一件事,正如Ashish所说,是"保持快速学习"——因为技术变化太快,没人能看清5年、10年后的样子,能持续适应的人才会成为top 1%。
主持人Nishita的总结点破了核心焦虑:AI就是"互联网2.0",它不会抢走你的工作,但会用AI的人会抢走你的工作。10个人的活将由5个用AI的人完成。保持相关性,靠的不是追逐agentic AI这类热词,而是扎实的基础加上持续的适应。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。