Albert Gu 宣布「It works.」:Mamba 架构迎来关键验证

Albert Gu 的「It works.」推文被视为 Mamba 路线工程可行的信号,但尚缺技术细节。
Reddit 上一则极简帖文引用了 Mamba 核心作者 Albert Gu 的推文「It works.」,引发社区关注。Mamba 用选择性状态空间模型替代 Transformer 的自注意力,将序列建模复杂度从平方级降至线性,理论上能大幅降低长上下文应用的成本。然而,从论文到工程可用之间存在训练稳定性、并行效率等障碍,这条推文被解读为某个关键环节已内部验证通过。文章指出,该信号对长文档理解、代码检索等场景意义较大,但 Transformer 的成熟工具链仍是新架构落地的主要变量,短期更可能出现混合方案。单条推文不构成技术结论,仍需等待公开细节与第三方复现。
一条推文,为何值得被认真对待
Reddit 上流传的一条极简帖文,正文只有一句「It works.」,附带的是一条指向 Albert Gu 的 X(原 Twitter)推文的链接。信息量看起来近乎为零,但放在当下的技术语境里,这句话的分量并不轻。
Albert Gu 是 Mamba 系列工作的核心作者之一。Mamba 试图用选择性状态空间模型替代 Transformer 中的自注意力机制,把序列建模的复杂度从随长度平方增长降到线性。过去一段时间,这套架构在语言建模等任务上展示出竞争力,但「能不能真正大规模跑起来、效果能不能站得住」始终是外界追问的焦点。「It works.」这个表述,指向的正是这类从「论文里可行」到「工程上成立」的跨越。
由于原帖没有展开任何技术细节,本文不做超出素材的推断,只围绕这条信号本身,讨论 Mamba 路线当前的处境与它可能带来的影响。
Mamba 想解决的到底是什么问题
自注意力的代价
Transformer 的核心是自注意力:序列中每个位置都要与其他位置计算关联权重。这让模型具备强大的全局建模能力,代价是计算与显存开销随序列长度呈平方级增长。上下文窗口越拉越长,这个代价就越难承受。
业界为此投入了大量工程手段——稀疏注意力、分块计算、各类近似方法——本质上都是在「保留注意力好处」和「压低长序列成本」之间找平衡。
状态空间模型的思路
Mamba 走的是另一条路。它借用了控制论中的状态空间模型,用一个隐状态在时间步上递推,让每个新 token 只需与压缩后的状态交互,而不是回看全部历史。这样复杂度对序列长度是线性的。
难点在于「选择性」:模型需要学会判断哪些信息该写入状态、哪些该遗忘。Mamba 的关键贡献就是让这些参数随输入动态变化,从而在保持线性复杂度的同时具备一定的内容感知能力。
状态空间模型(SSM)源自控制论,经典形式用一组一阶微分方程描述系统状态如何随时间演化,并通过观测方程把隐状态映射为输出。在序列建模中,它被离散化为递推形式:每个时间步根据当前输入更新隐状态,再读出输出。这种递推结构天然适合处理长序列,因为计算量随长度线性增长,且推理时可保持恒定大小的状态。早期的 SSM 在语言任务上表现有限,主要受限于状态更新方式与输入无关,难以像注意力那样灵活地选择性关注信息。Mamba 通过让状态转移参数依赖输入,弥补了这一缺陷,使 SSM 在保持线性复杂度的同时获得内容感知能力。
「It works」背后的信号价值
从论文到可用之间有一道坎
学术论文里的架构创新,和能稳定训练、能复现、能在真实负载下不崩,是两回事。很多看起来优雅的模型结构,最终倒在训练稳定性、并行效率或长程依赖退化上。
一条来自核心作者、语气笃定的短推文,通常意味着某个此前存疑的环节已经被打通——可能是大规模训练的稳定性,可能是推理效率,也可能是下游任务上的表现。素材没有说明具体是哪一项,因此更稳妥的理解是:这是一次内部验证通过的对外释放。
在深度学习架构的演进中,「可扩展性」通常指模型能否在增加参数量、数据量和计算量时,保持训练稳定、性能可预测提升,并且工程实现上能高效利用现有硬件。许多理论上优雅的架构在放大规模后会出现梯度爆炸、收敛困难或并行效率骤降等问题。对于 Mamba 这类基于递推的模型,大规模训练还涉及如何在时间维度上并行扫描(parallel scan)以充分利用 GPU,以及如何设计高效的核函数。这些工程细节往往决定一个架构能否从论文走向实际部署,也是「It works」这类信号背后可能隐含的验证内容。
社区为何如此关注
Mamba 从提出起就被视为少数有可能在通用序列建模上与 Transformer 正面竞争的路线之一。围绕它的讨论长期集中在两点:一是理论上的效率优势能否转化为实际吞吐,二是长上下文任务中是否会因为状态压缩而丢失信息。
任何来自作者侧的进展信号,都会被社区放大解读,因为这条路线一旦被证实可规模化,意味着长上下文应用的成本结构可能被改写。
对开发者与产业的可能影响
长上下文应用的成本想象
如果线性复杂度真的能在工程上兑现,直接受益的是那些被长序列成本卡住的场景:长文档理解、代码库级检索、长时对话记忆、音频与基因序列处理等。这些场景的共同痛点不是模型不够聪明,而是「上下文一长就贵得离谱」。
需要说明的是,素材并未给出任何性能数字,本文也不做量化推测。方向上,这是一条可能改变成本曲线的路线。
生态与工具链仍是变量
一个架构能否真正落地,不只取决于模型本身。围绕 Transformer 已经积累了极其成熟的推理框架、算子库、硬件适配和调优经验。新架构要获得同等程度的工程支持,需要时间。
因此即便验证通过,短期内更可能出现的是混合方案——在特定环节引入状态空间层,而非全盘替换。这种渐进路径在历史上更常见。
推理框架与算子库的成熟度直接决定新架构的落地成本。以 Transformer 为例,其自注意力机制已被深度优化为 FlashAttention 等高效算子,并广泛集成到 PyTorch、TensorRT-LLM、vLLM 等主流框架中,硬件厂商也针对注意力计算做了专门优化。新架构若想获得同等支持,需要框架开发者实现定制算子、硬件厂商提供适配,并经过大量实际负载调优。这一过程通常以年为单位,且需要社区形成足够规模的使用者基础。因此,架构创新与工程生态之间存在明显的时间差,这也是渐进式混合方案更现实的原因。
保持审慎:一句话不等于全部结论
把这条信号放到合理的位置上很重要。一条推文不是论文,不是基准测试报告,也不是可复现的实验记录。它证明不了架构在所有任务上优于 Transformer,也说明不了落地时间表。
更合理的态度是:把它当作一个值得跟踪的节点,等待后续的技术披露与第三方复现。Mamba 这条路线过去几次引发关注,都伴随着实际评测数据的公开;这一次同样需要等数据说话。
对关注序列建模方向的开发者来说,现在可以做的事是关注官方后续发布、留意开源实现的更新,并在自己的长序列场景中小规模验证可行性,而不是据此立刻调整技术栈。
常见问题
Mamba 会取代 Transformer 吗? 素材没有给出任何此类结论。从工程生态的成熟度看,短期内更可能是并存与混合,而非替代。
这条推文具体验证了什么? 原帖只有「It works.」一句,未说明验证对象。任何具体结论都缺乏素材支撑。
普通开发者现在该做什么? 保持关注即可。等有公开的技术细节和可复现结果后,再评估是否在自己的场景中试用。
相关推荐
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。
老派分类器仍胜Jev:嵌入+sklearn误差降37%
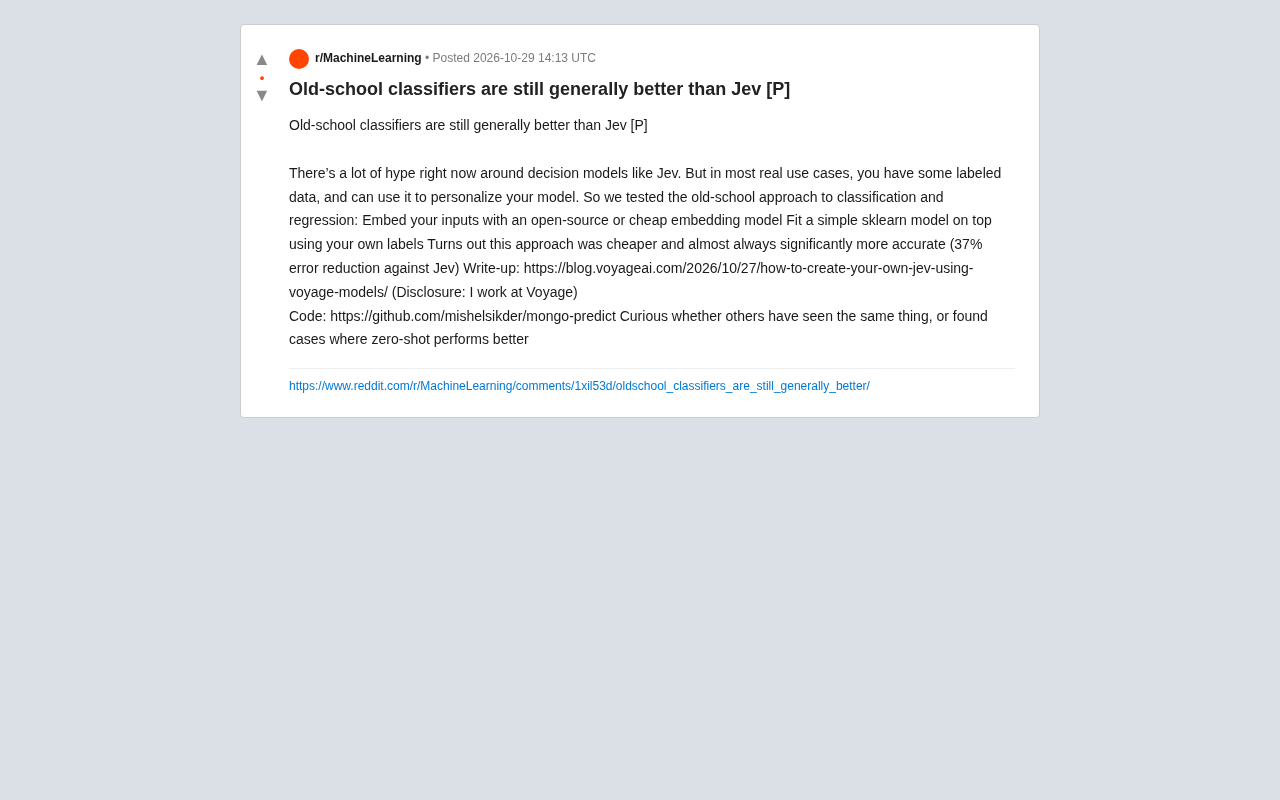
Voyage AI工程师测试发现,用开源嵌入模型加sklearn分类器的老派方案,比当红决策模型Jev更便宜且错误率降低37%。讨论有标注数据时传统方法是否被低估,以及零样本与有监督学习的适用边界。