AMD 7900XTX 实测 Strata 跑 Qwen3:IQ3 量化 60-80 t/s
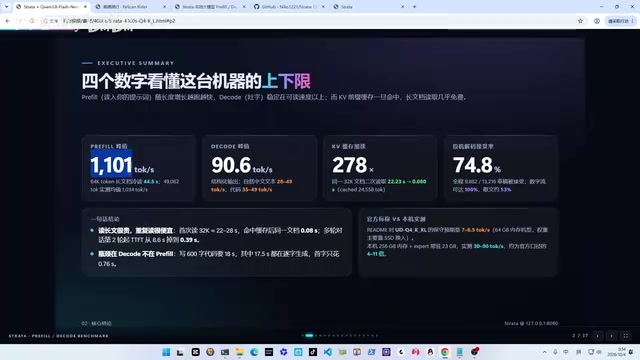
开源项目Strata让AMD 7900XTX在Windows上跑通Qwen3,输出可用但Prompt处理性能明显弱于同级N卡。
长期被NVIDIA垄断的本地大模型推理市场迎来一个新变量:开源项目Strata让AMD Radeon RX 7900XTX得以在Windows 11上顺畅运行Qwen3。实测显示,IQ3_XSS量化版本的输出速度稳定在60-80 t/s,日常使用完全够用;但Prompt预处理阶段仅有400-479 t/s,与RTX 4080S的1000+ t/s差距悬殊,首字延迟偏高是最大短板,256K上下文下单次生成耗时甚至达到743秒。安装体验则是亮点——Strata自动打包了编译好的llama.cpp与ROCm内核,仅需AMD驱动即可运行,无需手动配置繁琐的ROCm环境。对于已持有AMD高端显卡的用户,这是目前本地推理最可行的路线之一,随着Windows端优化推进,差距有望缩小。
A卡终于能跑:Strata 项目实测体验
长期以来,本地大模型推理几乎是 NVIDIA 显卡的专属舞台,llama.cpp 等主流方案对 AMD 显卡的支持要么缺失、要么跑不起来。最近火起来的开源项目 Strata 带来了转机——这位 B站 UP 主用 AMD Radeon RX 7900XTX 在 Windows 11 上实测跑通了 Qwen3,整体体验用他的话说「还是挺爽的」。
本文整理这次实测的关键数据与安装经验,供同样手握 A 卡、想在本地跑大模型的玩家参考。
实测数据:输出能用,但 Prompt 处理偏慢
测试平台是一套典型的「洋垃圾」配置:Intel Xeon E5-2686 V4、256GB DDR3-1866 内存,搭配 7900XTX 显卡。模型方面跑的是 Qwen3 的 IQ3_XSS 量化版本。
实测结果中,生成速度(输出 token)稳定在 60-80 t/s,平均约 68 token/s,这个数字对日常使用完全够用。但问题出在 Prompt 处理阶段(preview):7900XTX 在 Windows 下只有约 400-479 t/s,而作为对照的 RTX 4080S(Q4 量化)preview 能跑到 1000 以上,接近千亿级别的处理吞吐。
按理说 7900XTX 与 4080S 的性能应该相当,但目前这个差距明显偏大。UP 主推测可能是 Windows 11 下的优化尚不到位,因为同样的项目在 Linux 上 preview 数值要高得多。
实际使用中最直观的痛点就是响应慢:输入提示词后往往要等 10 秒甚至更久才开始输出,开到 256K 上下文时一次生成耗时达到 743 秒。换句话说,输出流畅,但「首字延迟」体验较差。好在真正开始吐字后速度可用,拿来做些对话、文本生成任务问题不大。
这里涉及大模型推理的两个核心性能指标,值得区分清楚。Prefill(预填充/Prompt处理)阶段是指模型读入并处理用户输入的提示词,生成 KV Cache 的过程;Decode(解码/生成)阶段则是逐个 token 地输出回答。两者的计算特性截然不同:Prefill 属于计算密集型(Compute-bound),依赖GPU的矩阵并行计算能力;Decode 属于内存带宽密集型(Memory-bound),更多取决于显存带宽。7900XTX 的理论显存带宽(960 GB/s)与 RTX 4080S(736 GB/s)相比并不落后,这也是为什么 Decode 速度(60-80 t/s)相对正常,而 Prefill 差距更可能源于 ROCm 在 Windows 下的软件层优化尚未成熟,而非硬件本身的问题。
安装与配置:几乎全自动的开箱体验
Strata 的安装流程相当友好,这也是它值得推荐的一大原因。下载源文件包后,直接运行启动脚本即可,大量步骤都是全自动完成:
- 程序会自动下载编译好的 llama.cpp 与 ROCm 内核,无需用户手动安装 HIP 工具链;
- 只要系统装有 AMD 显卡驱动就能运行,省去了配置 ROCm 环境的繁琐;
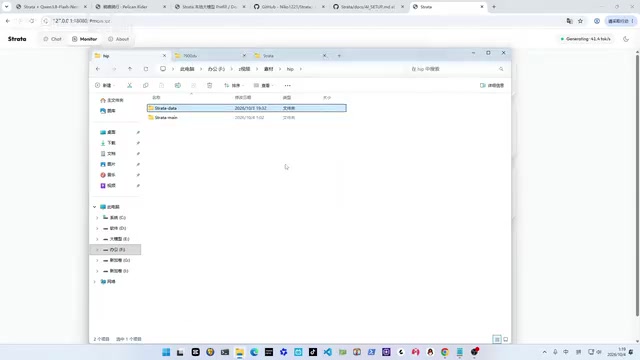
- 还会额外下载一个约 6GB 多的 data 目录,里面包含 MTP(多 token 预测)相关内容。
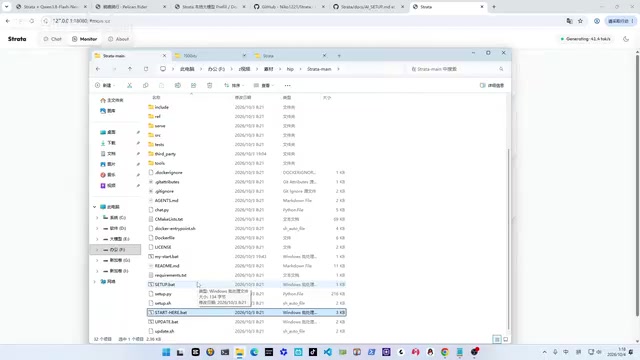
指定本地模型目录的技巧
默认情况下,Strata 会让你在界面里选择模型并自动下载,但它不能直接指定本地已有的模型目录。如果你本地已经下好了 GGUF 模型,想避免重复下载,可以借助以下方式:
- 使用带目录指定功能的启动参数(UP 主提到用
gguf-dl可以指定模型目录及加载范围); - 手动在
C:\用户\<用户名>\AppData\Roaming\strata下的配置文件中新建对应的 JSON,指定模型路径,程序便会直接加载而不再联网下载,速度更快。
多卡配置
如果你有两张显卡,需要额外使用相应的分配参数(涉及 HIP 相关设置)来做多卡并行。配置方式与单卡类似,UP 主已将参数截图一并分享。
ROCm(Radeon Open Compute)是 AMD 推出的开源并行计算平台,定位类似于 NVIDIA 的 CUDA,为 GPU 通用计算提供编译器、运行时和数学库支持。然而 ROCm 长期以来在 Windows 上几乎没有官方支持,AMD 官方主要维护 Linux 版本,这也是 A 卡在本地推理生态中长期处于劣势的根本原因。Strata 的关键突破在于它预先编译好了针对 Windows 的 ROCm 内核二进制文件,用户无需自行搭建完整的 ROCm 开发环境,绕过了 Windows 下 ROCm 工具链难以安装的痛点。这种「预编译打包分发」的思路大幅降低了 A 卡用户的上手门槛。
实际应用:加速、暂停与速度调节都可用
除了纯文本生成,UP 主还用它跑了一个实际任务(提壶/图像相关生成),表示效果「还行」,并且支持加速、暂停、黑白天切换以及两倍速等功能,整体可用性达到了日常使用的门槛。
需要注意的是,目前该项目似乎只支持单一算法路径,功能还在迭代中。但对 AMD 显卡用户来说,这已经是一个难得的突破——在 llama.cpp、各类 Llama API 方案普遍无法在 A 卡上顺畅运行的当下,Strata 提供了一条可行的本地推理路线。
小结:A 卡本地推理值得一试
这次实测说明了几点现实:7900XTX 在 Strata 上跑 Qwen3 的输出速度已经完全可用,安装部署也足够省心;但 Windows 下的 prompt 处理性能与同级 N 卡仍有明显差距,首字延迟偏高是当前最大短板。
对于已经持有 AMD 高端显卡、又不想为了跑模型额外购置 N 卡的用户,Strata 是一个值得关注的开源方案。随着 Windows 端优化的推进,A 卡本地大模型推理的体验有望进一步追平。
相关推荐

OneSignal MCP Agent:用模型上下文协议实现推送通知自动化
OneSignal MCP Agent基于模型上下文协议(MCP)实现推送通知自动化,采用类型化JSON Schema与两阶段干运行保障安全,并提出用固定提示面板监测AI时代的品牌可见性,超越传统SERP虚荣排名。
三大AI决策模型对决Polymarket:谁更能预测未来?
开发者用开源项目让 OpenAI Decisions API、TypeSafe Jev 和 Cloudflare Clef 三大决策模型同场预测未来,并与 Polymarket 实时赔率对比。实验揭示模型会复读市场价格,以及三者截然不同的推理风格。
ESP32-S3打造桌面机器人Pamk:自定义唤醒词+Gemini替代便利贴
法国学生用 ESP32-S3 打造桌面机器人 Pamk,通过自定义唤醒词与 Gemini 实现纯语音任务管理,替代便利贴。本文解析其硬件架构、唤醒词训练与开源计划。