Anthropic封禁用户:触碰训练更大模型即违规?

社区反映Anthropic封禁触碰训练更大模型的账号,引发平台规则边界与开发者风险担忧。
文章围绕Hacker News上“Anthropic封禁任何触碰训练更大模型行为”的社区讨论展开,指出该说法缺乏官方声明佐证,但足以引发开发者对平台使用边界的担忧。文章分析了封禁标准的三种可能解读:仅针对竞争性蒸馏、防止能力外溢、自动化风控误伤,并讨论了对开发者模型选型、多模型备份、数据合规和申诉记录的实际影响。文章认为,事件反映大模型平台正从开放API转向有条件开放,对数据出口控制趋严,开发者应将平台规则风险纳入技术架构设计。
事件背景:一条模糊的封禁规则
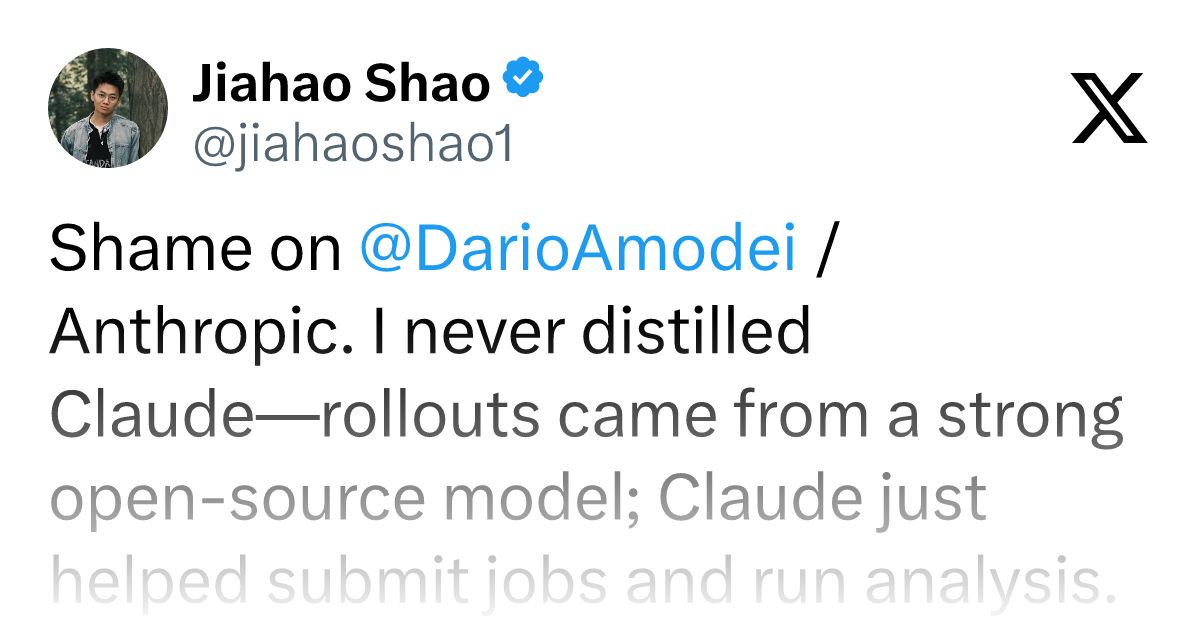
据 Hacker News 讨论,有用户反映 Anthropic 会封禁任何“触碰训练更大模型”行为的账号。这一说法来自社区标题“Anthropic blocks users for anything touching training larger models”,虽然原始信息仅有点数和评论数,没有截图或官方声明佐证,但足以引发开发者对平台使用边界的担忧。
核心争议在于:封禁标准到底是什么?是禁止用户利用 Claude 的输出训练竞品模型,还是连用户讨论、测试、甚至微调自己的小模型都算违规?原始素材没有给出答案,不确定性本身就是风险。
为什么这条规则值得关注
大模型服务商通常会在条款中禁止“使用输出训练竞争模型”。Anthropic 的封禁动作如果真如社区所说,覆盖“任何触碰训练更大模型”的行为,意味着边界从“禁止蒸馏”扩大到“禁止任何相关实验”。对开发者而言,这会影响模型选型、实验设计和数据合规策略。
另一层影响在于生态信任。API 用户把业务逻辑和数据放在平台上,最怕规则解释权完全在平台一侧。一次封禁可能让团队重新评估多模型备份、本地部署或开源替代方案的成本。
规则边界的三种可能解读
解读一:仅针对竞争性训练
最温和的解释是,Anthropic 只封禁用 Claude 输出训练与自身形成竞争的大模型。这是行业常见做法,目的是防止模型蒸馏和知识产权流失。按此理解,普通用户微调小模型或做学术研究不应受影响。
模型蒸馏(Model Distillation) 是指利用一个已训练好的大模型(教师模型)的输出(如 logits、概率分布或生成文本)来训练另一个更小的模型(学生模型),使学生模型在特定任务上逼近教师模型的表现。在商业条款中,服务商通常禁止用户使用其输出训练竞争模型,因为这相当于将平台投入大量算力获得的能力“免费”转移给第三方,削弱了自身的竞争优势。蒸馏技术本身在学术界和工业界均为常规手段,但用于训练与教师模型直接竞争的商用模型时,往往触碰服务商的使用红线。
解读二:防止能力外溢
更严格的解释是,平台担心用户通过 API 系统性获取高质量数据,用于提升其他模型能力。即使不是直接竞品,只要“训练更大模型”就可能触发风控。这会把研究型用户和初创团队置于灰色地带。
能力外溢(Capability Spillover) 指平台的高质量输出被用户系统性收集后,用于提升平台之外的其他模型或系统的能力,从而使平台的核心资产——模型能力——间接流失。与直接蒸馏不同,能力外溢不要求用户训练与平台直接竞争的模型,只要输出被用于增强任何外部模型,就可能被平台视为风险。对于提供 API 的服务商而言,输出即数据,数据即资产,因此风控系统可能对批量调用、高频率生成、特定领域数据收集等行为保持敏感,这解释了为何部分研究型或数据密集型用途容易触发审查。
解读三:自动化风控误伤
第三种可能是风控系统按关键词或行为模式自动封禁,导致正常实验被误判。社区讨论中常见的抱怨正是“不知道自己为什么被封”。若缺少申诉渠道和明确说明,误伤成本会转嫁给用户。
自动化风控(Automated Risk Control) 是平台基于规则引擎或机器学习模型,对用户行为进行实时监测与自动处置的机制。常见触发条件包括:短时间内大量调用 API、请求内容包含训练相关关键词(如“fine-tune”“training data”)、输出被批量导出等。自动化风控的优势是效率高、覆盖面广,但缺点是缺乏上下文判断,容易将正常的学术实验、数据整理或模型评估误判为违规行为。当平台缺少透明规则和有效申诉渠道时,误封成本完全由用户承担,这也是社区讨论中“不知道为什么被封”抱怨的根源。
对开发者的实际影响
首先,模型训练类项目需要重新审视服务条款,尤其是数据来源和输出用途。其次,团队应保留多模型方案,避免单一平台封禁导致业务中断。第三,涉及模型训练的对话和实验应做好本地记录,以便申诉时提供依据。
对研究者和独立开发者来说,最现实的问题是:平台规则不透明时,如何证明自己的用途合规?原始素材没有提供 Anthropic 的官方回应,因此目前只能依据社区反馈做风险提示,而非定论。
行业层面的信号
大模型平台正在从“开放 API”转向“有条件开放”。训练数据的价值越高,平台对输出流向越敏感。Anthropic 若确实采取激进封禁策略,可能推动部分用户转向开源模型或自托管方案,也会促使其他厂商明确规则边界以争取开发者信任。
这条讨论虽然信息量有限,但指向一个真实趋势:模型能力的竞争,正在变成对数据出口的控制。开发者需要把“平台规则风险”纳入技术架构设计,而不是事后补救。
常见问题
Anthropic 封禁的具体标准是什么?
原始素材未提供官方细则,社区说法是“任何触碰训练更大模型”的行为。建议以 Anthropic 官方使用条款为准。
普通用户会被误封吗?
存在这种可能,尤其是自动化风控缺少人工复核时。保留使用记录有助于申诉。
开发者该如何应对?
评估多模型备份、关注条款更新、避免用平台输出直接训练竞争模型,并对关键实验做本地留档。
相关推荐

LZ4:极速压缩算法的开源标杆
探索 LZ4 极速压缩算法:了解其设计哲学、性能优势以及在 Linux 内核、数据库等领域的广泛应用。12k+ Star 的开源项目如何成为速度标杆。

Agent-Browser:AI智能体的浏览器自动化CLI
Vercel Labs 开源 agent-browser,一个用 Rust 构建、专为 AI 智能体设计的浏览器自动化 CLI 工具,GitHub 星标超 4.5 万,提供命令行优先的浏览器操控能力。

全球首家人形机器人公司Agility登陆纳斯达克,买不买?
Agility以全球首家人形机器人上市公司身份登陆纳斯达克,本文分析这一标志性事件对行业与投资者的意义,拆解纯人形机器人赛道的商业化考题与投资判断框架。