Anthropic神秘模型泄露?Hugging Face惊现14万亿参数巨兽

Hugging Face出现号称Anthropic 14万亿参数模型泄露仓库,真实性存疑。
文章围绕 Reddit 热议的 Hugging Face 仓库 burner22/numbat 展开,该仓库声称包含 Anthropic 内部“Mythos 级”训练检查点,规格为 14 万亿参数、1224 个 MoE 专家、7.72 TB 权重、772 个分片,并采用混合 GDN+MLA 架构。文章逐一分析这些数字的技术含义,指出超大规模稀疏 MoE 与高效注意力架构的工程挑战,同时列举真实性疑点:上传者身份不明、缺乏数字签名与官方背书、训练成本与技术合理性存疑、历史上有多次伪造先例。文章进一步讨论若属实的多层面影响——AI 安全与合规质疑、竞争格局冲击、架构研究价值,并提醒开发者谨慎对待来源不明的权重文件。结论强调在独立验证前一切仅为猜测。
事件回顾:Hugging Face上的“Mythos级”模型仓库
近日,Reddit社区一则帖子引发热议:一个名为burner22/numbat的Hugging Face仓库声称包含了Anthropic内部“Mythos级”训练检查点。帖子中列出了令人咋舌的规格:14万亿参数、1224个MoE专家、7.72 TB权重、772个权重分片,以及混合GDN+MLA架构。仓库还提供了模型架构代码、配置文件和训练元数据。
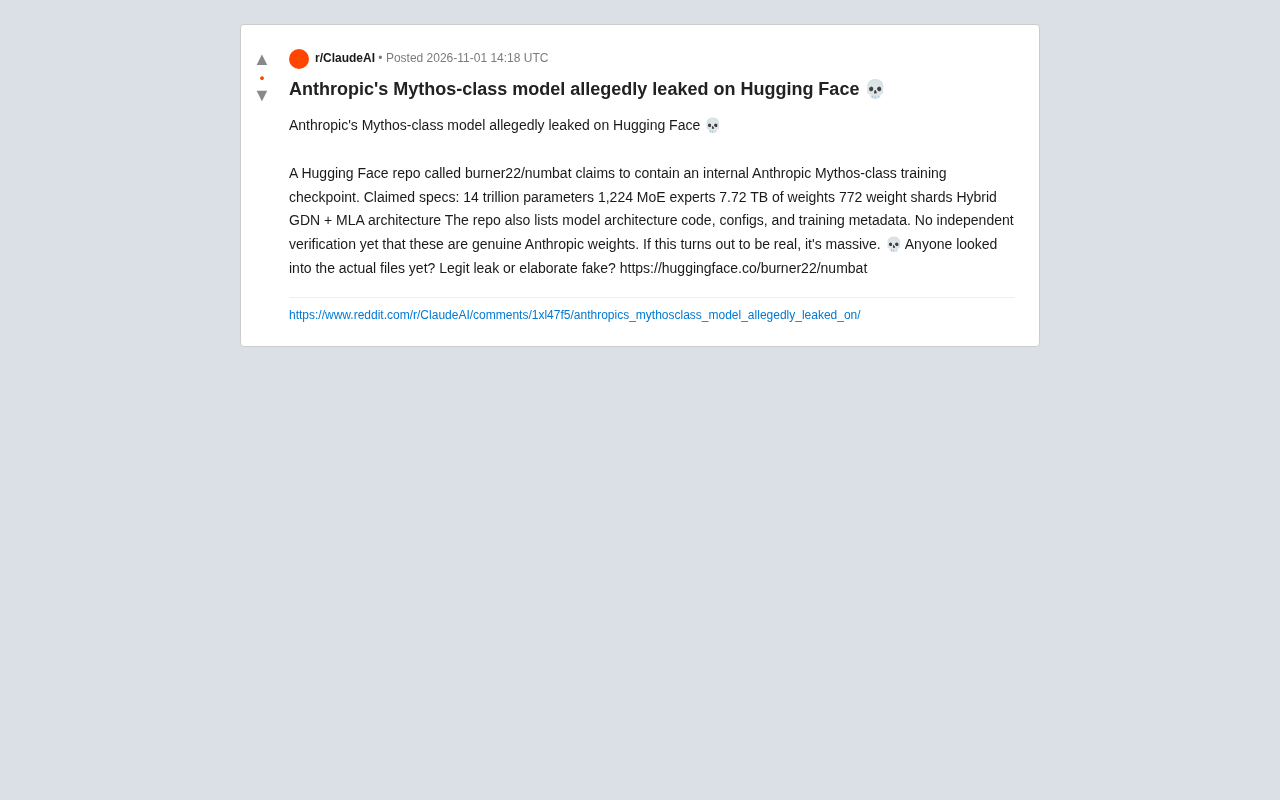
发帖者直言:“如果这是真的,那将是爆炸性新闻。”但截至目前,没有任何独立验证能证明这些权重确实来自Anthropic。社区用户纷纷追问:有人检查过实际文件吗?是真实泄露还是精心伪造?
技术规格分析:数字背后的野心
14万亿参数是什么概念?
当前公开的主流大模型参数规模多在千亿至万亿级别,而14万亿参数意味着比GPT-4等已知模型大一个数量级。如此庞大的参数量,配合1224个MoE(混合专家)专家,暗示该模型可能采用极致的稀疏化设计——每次推理只激活一小部分专家,以平衡计算效率与模型容量。
混合专家(MoE, Mixture of Experts) 是一种将模型前馈层拆分为多个并行的“专家”子网络,并通过一个可学习的路由器(router)为每个 token 只激活少数专家的架构。其核心价值在于“参数规模”与“计算量”解耦:总参数量可以非常大,但单次前向推理只计算被激活的专家,因此训练和推理的 FLOPs 远低于同等稠密模型。常见设计如 GShard、Switch Transformer 会为每个 token 选择 top-1 或 top-2 专家,并配合负载均衡损失防止专家塌缩。文中提到的“1224 个 MoE 专家”正属于这一范式,专家数量越多、单次激活比例越低,模型的稀疏度就越高。需要指出的是,MoE 的工程难点在于专家并行的通信开销、路由不稳定性以及显存占用——总参数仍需分布存储,只是计算时按需调度。
7.72 TB权重与772个分片
7.72 TB的权重文件需要772个分片存储,这反映了超大规模模型在分发和加载上的工程挑战。混合GDN+MLA架构(GDN可能指Gated Delta Networks,MLA指Multi-head Latent Attention)则是近年来提升长上下文效率的热门方向。如果属实,这将是Anthropic在架构创新上的重要披露。
GDN(Gated Delta Networks) 属于线性注意力/状态空间类的高效序列建模路线,其思路是利用带门控的 Delta 规则维护一个紧凑的循环状态,使推理时每步计算量与序列长度近似无关,从而在长上下文场景下显著降低复杂度。MLA(Multi-head Latent Attention) 则由 DeepSeek广告-V2 提出,通过将 Key/Value 缓存压缩到一个低秩潜在向量中,大幅削减 KV cache 的显存占用,同时保持多头注意力的表达能力。二者组合(GDN 负责线性高效的全局状态、MLA 负责压缩注意力的精确检索)是当前降低长上下文推理成本的热门探索方向:前者擅长处理超长序列的流式状态,后者在需要精确回忆时提供补充。若文中架构描述属实,说明该模型试图在 14 万亿参数的极端规模下同时控制推理成本,这也是此类超大模型在工程上能否落地的关键。
真实性存疑:伪造的可能性与动机
尽管规格惊人,但多个疑点不容忽视:
- 缺乏验证:Hugging Face仓库可以自由创建,上传者身份未知(
burner22疑似小号),没有数字签名或官方背书。 - 技术合理性:14万亿参数的模型训练成本极高,Anthropic是否有必要将如此机密的检查点上传至公开平台?更可能的是,仓库中的代码和配置是拼凑的,权重文件可能是随机数据或旧模型。
- 历史先例:此前曾有多次“泄露”事件最终被证实为恶作剧或营销噱头。
社区中已有用户尝试下载部分分片,但尚未公布分析结果。Reddit帖子下的讨论也呈现两极:有人认为这是Anthropic的故意“预告”,也有人嘲讽“又是fake”。
在判断此类“泄露”真伪时,有一个实用的技术校验清单:一是检查分片文件的校验和与文件头,真实权重通常以 safetensors 格式存储并带有元数据,随机数据往往无法通过反序列化;二是验证配置文件与架构代码的一致性,伪造者常从多个开源仓库拼接,导致张量形状、层数与 config.json 对不上;三是核对训练元数据的时间戳、日志格式与分布式训练痕迹,真检查点会留下 optimizer state、学习率调度等痕迹;四是检查上传者账号的历史行为与注册时间,burner22 这类一次性账号本身就是重要信号。此外,Hugging Face 仓库默认不提供任何来源认证,任何人都可命名仓库为任意组织下的风格,因此“在 Hugging Face 上存在”绝不等于“来自 Anthropic”。
行业影响:若为真,意味着什么?
假设泄露属实,其影响将是多层面的:
- 安全与合规:Anthropic一直强调AI安全,内部模型泄露将引发对其数据管控能力的质疑。
- 竞争格局:14万亿参数模型若开源或半开源,可能颠覆现有开源模型生态,迫使OpenAI、Google等调整策略。
- 研究价值:混合GDN+MLA架构的细节将为学术界提供宝贵参考,推动高效推理研究。
但在独立验证之前,这一切都只是猜测。建议开发者保持谨慎,不要盲目下载或运行来源不明的权重文件,以免引入安全风险。
结论:让子弹飞一会儿
目前,该仓库的真实性仍是一个谜。Reddit原帖的提问——“Legit leak or elaborate fake?”——正是整个AI社区的疑问。我们将持续关注后续验证进展。在此之前,不妨将其视为一次对模型规模想象力的刺激:如果14万亿参数成为现实,AI的能力边界又将推向何处?
(本文基于Reddit公开讨论,未对仓库内容进行独立核实。)
相关推荐

DeepSeek Harness速通指南:从安装到5个实战案例
DeepSeek Harness 是什么?本文基于 B 站教程,介绍这款 AI Agents 软件的工作原理、安装配置、四种工作模式,并通过 3D 赛车游戏、官网、音乐播放器、科普动画、自开发插件五个实战案例展示其能力,附 Token 省钱技巧。

拆解DeepSeek Super-agent架构:Router+Worker如何破解多会话管理瓶颈
解读DeepSeek Super-agent论文:Router+Worker双层架构如何通过Fast Pass、链式召回、存算分离解决多AI会话管理瓶颈,并分析其对人注意力瓶颈的真实缓解程度与工程取舍。

5天1.9万星!DeepSeek开源AI程序员为何爆火
DeepSeek开源AI程序员5天斩获1.9万星,从零登顶GitHub榜首。它为何爆火?本文分析智能体赛道热潮、AI自写代码的叙事以及从问答工具到AI员工的范式转变,并提醒研究代码仍需谨慎审核。