Anthropic推出Claude Duet:主动式AI代理来了
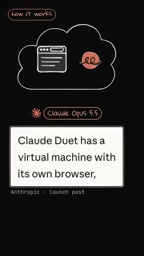
Anthropic 推出主动式代理 Claude Duet,以判断力与审批边界切入新赛道。
Anthropic 发布研究预览产品 Claude Duet,由 Claude Opus 5.5 驱动,运行在云端独立计算机上,从被动应答的聊天机器人转变为主动推送简报和提醒的 AI 代理。它每天在多个时间点发送简报,但只在真正需要关注时打扰用户;发送邮件或支付前必须等待用户批准,把自主执行与不可逆操作明确分开。Anthropic 强调其核心价值是判断力——分辨什么需要介入、什么可以等待。与此同时,Meta Muse、OpenAI Dots 等同类产品密集出现,主动代理已成多家厂商同时下注的方向。文章还提示一项易被忽略的成本:Duet 与订阅计划共享用量额度,后台检查同样计入,重度用户可能更快触顶。目前该产品面向美国 Pro 和 Max 用户通过等待名单开放。
Anthropic 近日发布了一款名为 Claude Duet 的新应用,将旗下大模型从被动应答的聊天机器人,转变为主动找上门的 AI 代理。这款产品由 Claude Opus 5.5 驱动,运行在云端一台独立计算机上,会主动向用户推送简报和提醒——这标志着 AI 助手的产品形态正在从「你问我答」向「我先替你想」演进。
主动式代理的工作方式
Claude Duet 的核心逻辑与普通聊天产品截然相反。据 Anthropic 介绍,它每天早上以及一天中的多个时间点向用户发送简报,但只在真正需要用户关注的事项上才会主动发消息,而不是事无巨细地刷屏。
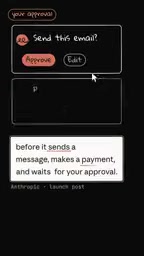
更关键的是权限边界:在发送邮件或进行支付之前,Claude Duet 会停下来等待用户批准。这说明 Anthropic 在设计上把「自主执行」和「不可逆操作」明确分开,代理可以主动判断、主动提醒,但涉及对外动作时仍需人类把关。
Anthropic 认为,这款产品真正有价值的地方在于它的「判断力」——即分辨哪些事情需要用户介入、哪些可以再等等。这个说法其实点出了主动式代理最难的技术环节:不是能不能做,而是知不知道该不该做、什么时候做。
**研究预览(Research Preview)**是 AI 产品发布中常见的一种阶段性形态:厂商把尚在验证中的功能以有限范围开放给部分用户,目的是在真实使用环境中观察模型行为、收集反馈,而不是直接把它当作成熟商品推向市场。与研究预览相近的说法还有「实验性功能」「beta 测试」。它的关键特征是:功能可能随时调整或下线,服务条款与数据使用策略往往另有说明,用户也不应假定其行为已经稳定。对 Anthropic 而言,此前 Claude 的多项能力也是以类似方式先行小范围放出,再根据实际表现决定是否扩大开放。因此,把 Duet 放在「研究预览」框架下理解,就能明白为何它只面向美国 Pro 和 Max 用户、且需要通过等待名单进入——这是厂商控制风险半径的一种手段。
主动代理赛道的竞争正在升温
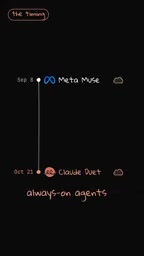
Claude Duet 的发布时机颇为微妙。根据视频内容,Meta 的 Muse 和 OpenAI 的 Dots 都在九月初之后相继推出,此外还有 Grogbot 等产品。换句话说,主动式 AI 代理已经从概念验证变成了多家厂商同时下注的方向。
这背后的产品逻辑不难理解:单纯的对话式 AI 已经高度同质化,用户留存和付费意愿的突破口,在于让 AI 承担更多「主动发现并处理事务」的职责。谁能把判断力做准,谁就能把代理从玩具变成日常基础设施。
对话式 AI 的同质化是理解这轮主动代理竞争的前提。当各家基础模型的通用对话能力逐渐接近,单纯「聊天」这一交互形式很难再构成差异化:用户可以在不同产品间低成本切换,付费意愿也随之被摊薄。于是厂商开始寻找新的价值锚点,把竞争从「模型答得好不好」转向「产品能替用户完成多少事」。主动式代理正是在这一背景下成为方向——它把 AI 从被调用的工具变成持续在后台运行的服务,从而制造更高的使用黏性和更明确的付费理由。这也解释了为什么 Meta、OpenAI 与 Anthropic 会在相近时间窗口密集推出同类产品:它们争夺的不是某一次对话的质量,而是用户在日常生活中把「替我留意和处理」这件事委托给谁。
一个不容忽视的限制:共享用量额度
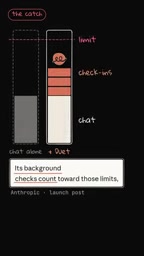
Claude Duet 有一个容易被忽略的成本问题。据视频介绍,Duet 与你当前订阅计划共享用量限制,而且它在后台进行的周期性检查同样计入额度。这意味着使用 Duet 的用户,可能会比单纯使用聊天功能更快触达用量上限。
对于重度用户来说,这不是小问题。主动代理的价值恰恰在于持续在后台运行、频繁判断和检查,而这些动作都会消耗额度。产品越「勤快」,额度消耗越快,用户需要在代理的主动性和成本之间做权衡。
**用量额度(usage limits)**是订阅制 AI 产品常见的成本控制机制:厂商为每个订阅计划设定一段时间内可消耗的计算量上限,通常以消息条数、token 数量或时间窗口内的调用次数来衡量,达到上限后用户需等待重置或升级计划。对聊天类产品而言,额度消耗基本与用户主动发起对话的次数成正比,因此较易预估。但主动式代理改变了这一模型——它在后台进行的周期性检查、判断与简报生成同样要调用模型,这些调用并不由用户直接触发,却真实占用算力。于是额度从「用户行为的函数」变成「产品行为的函数」,用户对消耗节奏的掌控力下降。这也是为何代理类产品普遍需要在主动性、检查频率与订阅成本之间做精细平衡。
发布范围与观察重点
目前 Claude Duet 处于研究预览阶段,面向美国的 Pro 和 Max 订阅用户,通过等待名单开放。这一安排符合 Anthropic 一贯的谨慎风格:先在小范围内验证产品行为,再决定是否扩大。
接下来的观察重点很明确:它的判断力在真实场景中到底表现如何。Anthropic 把「知道什么该打扰你」当作核心卖点,但这也是最难量化、最容易翻车的部分——提醒太少则失去主动代理的意义,提醒太多则沦为噪音。研究预览阶段的用户反馈,将直接决定这类产品能否从尝鲜走向常态。
从更宏观的角度看,Claude Duet 代表的是一种产品范式的转向:AI 不再等待指令,而是带着判断力主动介入工作流。这个方向的门槛不在模型能力,而在边界设计——什么时候该说话、什么时候该等待批准、什么时候该保持沉默。Anthropic 给出的答案是「人类保留最终审批权」,这或许会成为主动式代理的行业默认规则。
相关推荐
从零构建最小Agent:手把手教你写AI循环调用代码
跟随B站教程从零编写一个最小AI Agent:定义工具schema与finish信号,设计system/user prompt,实现带最大步数限制的循环调用,解析工具调用结果并修复finish后未跳出循环的bug。
Kimi K3.1 Pro实测:开源模型能否挑战Opus 5.5?
Kimi K3.1 Pro实测对比Opus 5.5和DeepSeek V4.1 Flash:基准测试亮眼,但MOBA游戏开发任务暴露短板。速度接近Opus,成本接近DeepSeek,成为开源模型中的性价比之选。
多Agent交接的边界:该给什么,该藏什么?
多Agent工作流中,交接该给多少上下文?本文拆解Reddit开发者的一线经验:给Coder原子spec加目标文件是否足够、给Reviewer为何必须带spec、切片太窄时如何用命名依赖请求有界摘录,并提炼一条可操作的交接判断规则。