Kimi K3.1 Pro实测:开源模型能否挑战Opus 5.5?
Kimi K3.1 Pro实测:速度近Opus、成本近DeepSeek,复杂3D任务仍是短板。
文章通过三个实战任务对比 Kimi K3.1 Pro、Claude Opus 5.5 与 DeepSeek V4.1 Flash。基准层面,Kimi 在多数测试中领先开源模型,每智能单位成本更低,但在 Arena 用户投票的代码与 Web 类别仅列第 8,且以 Neural Yap Benchmark 测得它是三者中最不啰嗦的模型。实战中,NumPy 实现 CNN 可视化与缩略图素材生成两项任务,三模型均能完成,Kimi 的速度接近 Opus、成本接近 DeepSeek,形成独特的性价比甜点。但在 Ursina 引擎开发 MOBA 原型这一高难度任务上,Kimi 首次运行耗时 44 分钟且需修复,完成度不及 Opus,重跑后改善但仍落后。作者结论是:若只能用开源模型,Kimi K3.1 Pro 是首选,但尚不能完全替代 Opus 5.5。
Kimi K3.1 Pro发布后,基准测试成绩亮眼,但实际体验如何?一位YouTube创作者通过三个实战任务,将其与Claude Opus 5.5和DeepSeek V4.1 Flash对比,发现了一个有趣的平衡点。
基准测试:纸面数据惊艳,但并非全部
据官方数据,Kimi K3.1 Pro在多个基准测试中排名第一,几乎在所有项目中都超越了其他开源权重模型。在终端基准上,它不仅表现优异,成本也显著低于GPT-6 Astra、Opus 5.5等闭源模型。独立评估机构Artificial Analysis的智能排名中,它位列Opus 5.5、Sonnet 5.5和Muse Wonderful之后,但成本效益(每智能单位成本)更低。
在Arena AI的用户投票排行榜(代码与Web开发类别)上,它仅排第8,但仍是前11名中仅有的两个开源模型之一。这提示我们,基准测试与真实用户偏好之间存在差距。
创作者还运行了自研的“Neural Yap Benchmark”,衡量模型的啰嗦程度。Kimi K3.1 Pro是“最不啰嗦”的模型之一,在回复长度上远优于前代Kimi K3,常用短语控制也处于第一梯队。相比之下,Opus 5.5被吐槽“不管问什么都给一篇小作文”。
Arena AI 排行榜与基准测试的差异
Arena AI(即 LMArena,前身为 Chatbot Arena)采用匿名对战模式:用户同时看到两个模型的回答,投票选出更好的一个,再通过 Elo 类算法汇总为排名。它的特点是贴近真实使用偏好,但样本由用户自发产生,任务分布偏向闲聊、代码片段和 Web 小页面,对长程工程任务、多文件代码库改造等场景覆盖不足。
而 MMLU、SWE-bench、终端操作类基准多为固定题目集,可复现、可横向比较,却容易被针对性优化(即“刷榜”)。因此出现一种常见现象:模型在基准上排名靠前,在 Arena 用户投票中却只排中游。文中 Kimi K3.1 Pro 在 Arena 代码与 Web 开发类别仅列第 8,正是这种落差的体现——它说明模型的强项可能集中在基准覆盖的题型上,而非用户日常最常遇到的开放式需求。
每智能单位成本(Cost per Intelligence Unit)
这是 Artificial Analysis 等独立评估机构提出的性价比指标:先按综合智能得分(由多个基准加权得出)衡量模型能力,再用单位 token 的 API 价格去除,得到“买到一分智能需要花多少钱”。
它的意义在于纠正两种片面看法:只看分数会忽略闭源旗舰模型高昂的调用成本;只看单价又会低估弱模型因反复重试、输出冗长而带来的隐性开销。对需要大量调用模型的生产场景(如批量生成素材、跑自动化测试)而言,这个指标往往比绝对排名更有决策价值。文中指出 Kimi K3.1 Pro 智能排名位列 Opus 5.5 等之后,但每智能单位成本更低,正是这一指标的典型用法——它不追求最强,而是在能力与价格之间取得更优的比值。
实战测试一:NumPy实现CNN可视化
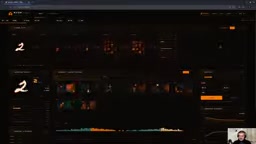
第一个任务是仅用NumPy实现一个在MNIST上训练的卷积神经网络,并在浏览器中可视化训练和推理全过程,风格要求极简、像素风、橙黑配色。
三个模型均成功完成任务。Kimi K3.1 Pro的界面功能完整,可调节样本数、批次大小、学习率等参数,实时展示损失和准确率变化。Opus 5.5的设计更流畅,动画更精细;DeepSeek广告 V4.1 Flash的界面信息过载,动画虽流畅但令人眼花缭乱。
成本和时间差异显著:Opus 5.5最快(约1分钟),但成本约2.30美元;DeepSeek最便宜(0.32美元),但耗时近1小时;Kimi K3.1 Pro居中,速度接近Opus,成本接近DeepSeek。
为何用纯 NumPy 实现 CNN
常规深度学习框架(PyTorch、TensorFlow)把卷积、反向传播、优化器都封装成一行调用,模型能力体现在“会不会用 API”。而要求仅用 NumPy 实现,意味着模型必须自己写出 im2col 或直接滑窗的卷积前向计算、手推交叉熵与 softmax 的梯度、实现卷积层与池化层的反向传播、以及 SGD/Adam 的参数更新,任何一处维度或转置错误都会导致训练不收敛。
这类任务因此被视为对“底层理解 + 长代码一致性”的强压力测试:它同时考察数学推导是否正确、上百行代码能否自洽、以及能否把训练循环与前端可视化正确接线。三个模型均能完成,说明当前一线模型在中等规模、单文件、逻辑清晰的数值代码上已相当可靠;差异主要体现在界面打磨和成本耗时,而非正确性。
实战测试二:缩略图素材生成
第二个任务是根据半成品缩略图,生成一个“CSV文件转化为已部署机器学习模型”的透明背景素材,并合成最终缩略图。
三个模型都生成了可用的素材,但放置位置均有偏差(偏左或偏下)。质量上难分伯仲,主要差异仍在成本和时间:Opus 5.5耗时38秒、成本0.38美元;DeepSeek耗时6分47秒、成本0.04美元;Kimi K3.1 Pro耗时接近Opus,成本接近DeepSeek。
创作者指出,如果Kimi能稳定完成此类任务,将大幅降低其缩略图制作成本——目前用Opus生成每个素材要花20-40美分。
实战测试三:Ursina引擎开发MOBA原型
第三个任务刻意增加难度:用Python的Ursina 3D游戏引擎(并非为游戏开发设计)构建一个MOBA游戏原型,包含一个英雄、三个技能和可重生的假人目标。
这是Kimi K3.1 Pro唯一明显落后的任务。首次运行耗时44分钟(中途出现白屏需修复),成本高于Opus;结果中技能效果模糊,自动攻击反馈弱。Opus 5.5耗时约30分钟,生成了更完整的游戏体验:可见的自动攻击、卡牌弹道、传送和镜像光束。DeepSeek虽然卡顿,但完成度也高于Kimi首次运行。
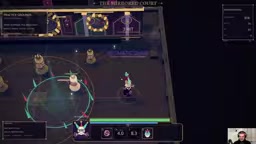
创作者给Kimi第二次机会,用相同提示重跑。第二次耗时21分钟,成本低于Opus,结果明显改善——自动攻击有伤害数字,技能可辨认,但仍不及Opus的完成度。创作者推测,问题可能出在Ursina引擎上,因为其他用户展示的Kimi 3D渲染效果极佳。
Ursina 引擎与长程任务的失败模式
Ursina 是建立在 Panda3D 之上的轻量 Python 3D 引擎,以“几行代码就能跑起 3D 场景”著称,API 简洁但对底层渲染、物理与状态同步的抽象较薄,且社区资料远少于 Unity、Godot,模型在训练数据中见到的正确用法样本也更少。
这解释了文中现象:Kimi 首次运行出现白屏、技能效果模糊、自动攻击反馈弱,本质是渲染循环、实体更新顺序与输入事件绑定这类跨文件、跨状态的长程依赖没有被正确串联。第二次重跑明显改善,说明问题部分源于采样随机性——同一提示下模型可能选择不同的架构路径,一条路径能自洽,另一条则在中途断裂。这提示评估长程编码任务时,单次结果不足以定论,重跑多次取中位数更能反映模型的真实稳定性。
结论:开源模型中的性价比之选
综合来看,Kimi K3.1 Pro并非Opus 5.5的完全替代品,尤其在复杂3D任务上存在差距。但在多数任务中,它提供了接近Opus的速度和接近DeepSeek的成本,形成了一个独特的“甜点”位置。
创作者明确表示,如果只能使用开源模型,Kimi K3.1 Pro将是首选——优于GLM系列(任务表现不佳)和DeepSeek(质量尚可但速度太慢)。对于需要快速迭代大型代码库的开发者,等待30-40分钟的成本难以接受,而Kimi在速度与成本间的平衡更具实用价值。
有意思的是,该视频为赞助内容,但创作者声称观点未受过滤。技术博客链接已在视频描述中提供。
相关推荐
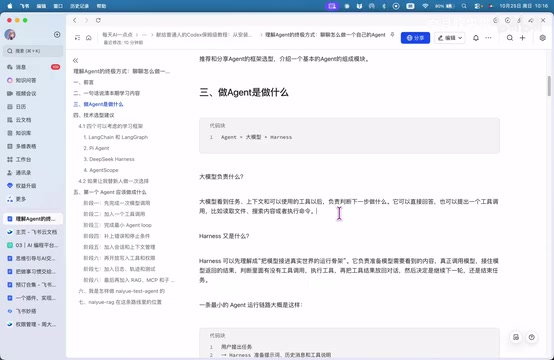
亲手构建Agent:理解AI Agent的最佳路径
想真正理解AI Agent?本文分享如何从零构建一个最小Agent,拆解大模型与Harness的分工,推荐PiAgent、DeepSeek Harness等学习型框架,并给出八个递进阶段和RAG与Agent的关系分析。
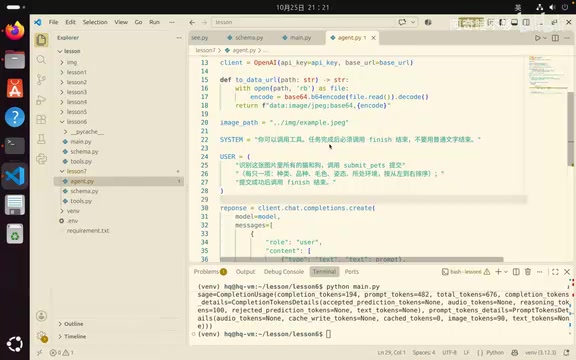
从零构建最小Agent:手把手教你写AI循环调用代码
跟随B站教程从零编写一个最小AI Agent:定义工具schema与finish信号,设计system/user prompt,实现带最大步数限制的循环调用,解析工具调用结果并修复finish后未跳出循环的bug。
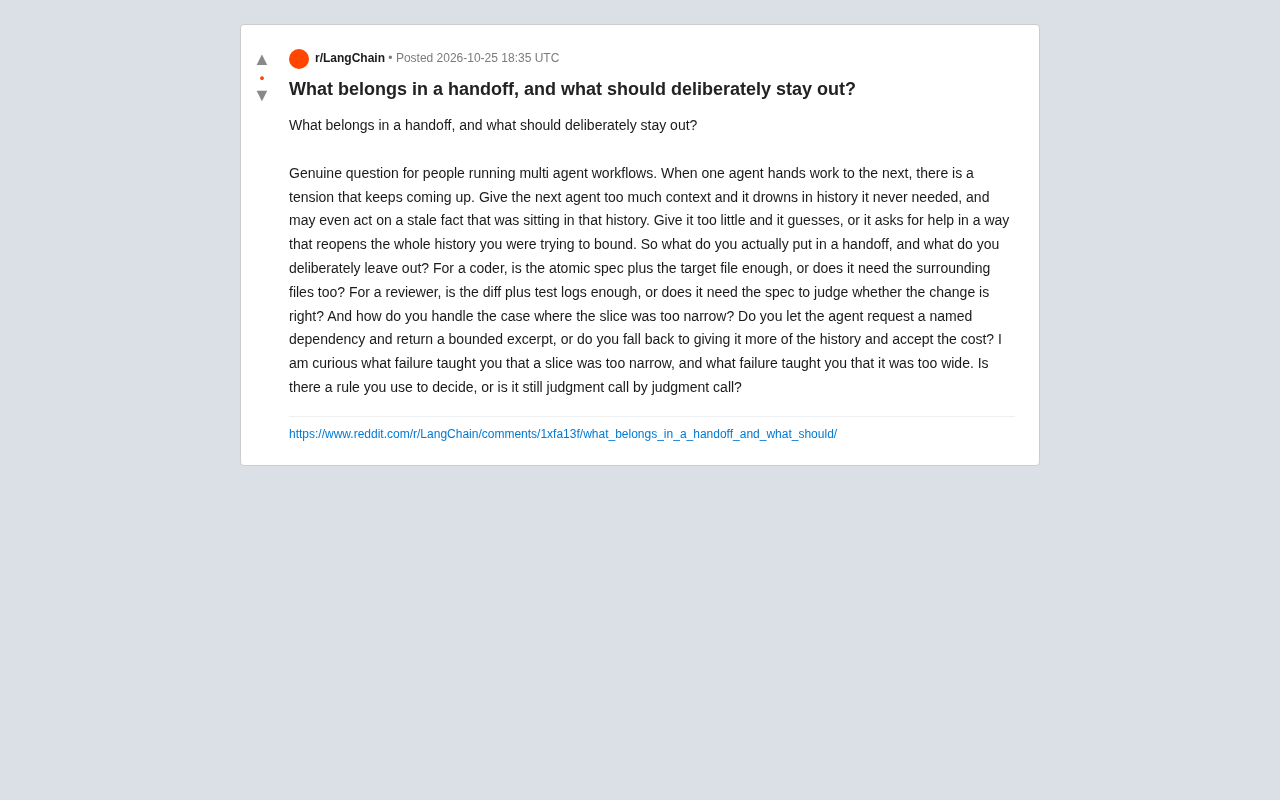
多Agent交接的边界:该给什么,该藏什么?
多Agent工作流中,交接该给多少上下文?本文拆解Reddit开发者的一线经验:给Coder原子spec加目标文件是否足够、给Reviewer为何必须带spec、切片太窄时如何用命名依赖请求有界摘录,并提炼一条可操作的交接判断规则。