Anthropic研究员拆解LLM训练:从调参到自我思考

从房价预测到强化学习,拆解大语言模型训练全链条与智能涌现原理。
本文基于Anthropic研究员Jeremy Berman的对话,以房价预测为起点,系统拆解了大语言模型的训练链条。神经网络通过反向传播调整参数拟合复杂函数,语言模型则将其扩展至词序列预测,预训练阶段学习互联网文本分布但仅具接龙能力。后训练通过对话样本和停止token赋予模型助手人格,思维链技术激发推理能力。GRPO强化学习让模型从自身生成的推理轨迹中学习,实现自我进化,但后训练人格具有脆弱性。文章最后探讨模型能否突破训练数据分布发现新知识,认为长视野推理训练有望构建新抽象,推动AI从拟合数据转向教会学习。
从房价预测到智能涌现:神经网络的第一性原理
Anthropic研究员Jeremy Berman在一场深度对话中,用最朴素的方式拆解了大语言模型的完整训练链条。他的起点并非Transformer架构,而是一个纽约公寓定价的玩具问题:给定位置、面积和浴室数量,预测房价。传统编程需要手写规则,但神经网络的思路是让计算机自己找到映射函数——用一堆可调的"旋钮"(参数)乘以输入,求和后输出预测值。这些旋钮初始随机,但通过对比预测与真实房价的差距(损失),再借助PyTorch等自动微分引擎计算每个旋钮对损失的影响方向(梯度),就能逐步微调至接近正确答案。
这个过程的本质是反向传播:链式法则算出每个参数的梯度,然后沿梯度反方向更新参数以最小化损失。Berman强调,单个神经元层只能表达线性关系,但堆叠多层并引入激活函数后,神经网络就成为"通用函数逼近器"——理论上只要有足够多的层和旋钮,可以拟合任何复杂函数。这正是深度学习的基石。
反向传播与自动微分:反向传播是训练神经网络的核心算法,本质是链式法则的高效应用。它从损失函数出发,逐层计算每个参数对损失的偏导数(梯度),从而知道如何调整参数以减小损失。自动微分引擎(如PyTorch的autograd)则负责在计算图中自动完成这一过程,无需手动推导公式。梯度下降沿负梯度方向更新参数,学习率控制步长。这一机制使得深层网络虽参数众多,仍能有效优化,是深度学习得以规模化的关键。
语言模型:当神经网络学会"文字接龙"
语言模型是神经网络的一种特殊形态,区别在于输入输出从数字变成了词序列(更准确说是token)。训练方式看似相同——预测下一个词,但关键差异在于:语言模型输出的是整个词表上的概率分布,而非单一数值。比如在"SOHO, 1200, 2BATH"的文本序列中,模型需要学会在给定前文时,将"1200"这个token的概率推向更高。损失函数衡量的是模型预测概率与真实下一词之间的差距。
Berman用Qwen 0.5B(5亿参数)的基座模型做了演示。这个模型在预训练后展现出纯粹的"互联网自回归"特征:输入"0",它可能输出代码片段;输入"Matthew Berman said",它会编造一句听起来合理但完全虚构的引述。这揭示了预训练模型的本质——它只是对训练数据分布的高保真压缩,而非追求事实正确。
预训练阶段需要海量数据和算力,因为语言空间的自由度远高于结构化数字。同样的映射任务,用普通神经网络可能只需少量参数,但语言模型需要吸收语法、语义、世界知识等无数潜在模式,才能把下一个词的概率分布校准到接近真实分布。
Token与词表概率分布:语言模型不直接处理字符或单词,而是将文本切分为token(子词单元),每个token对应词表中的一个ID。模型输出的是整个词表上的概率分布,表示下一个token的可能性。训练时使用交叉熵损失,衡量预测分布与真实next token的差距。这种设计使模型能处理未登录词和开放词汇,同时输出概率便于采样生成。词表大小通常为数万到数十万,概率分布的高维性也是语言模型需要大量参数的原因之一。
后训练:给"接龙机器"装上人格与思考
基座模型不会主动成为助手,它只会根据格式续写。研究者发现,如果在输入中预填"用户:1+1等于几?助手:",模型就会模仿互联网上助手的口吻作答。后训练正是利用这种模式匹配能力:构造大量"用户-助手"对话样本(可人工撰写或模型生成),并加入停止token,让模型学会在回答完毕后输出终止信号。Qwen2的对话模板(如<|im_start|>)就是这种思路的工程化体现。
这解释了为什么聊天界面中的消息角色(system、user、assistant)在底层会被拼接成特殊格式的文本——模型看到的始终是连续token流,所谓"对话"只是精心设计的提示工程。
但这还不够。早期指令模型会不假思索地输出错误答案,比如把398×923+2901算错一个数量级。研究者发现,只需在提问后加上"让我们一步步思考",模型就会展开推理步骤,准确率显著提升。这一发现催生了思维链(CoT)技术,而OpenAI的o1则是首个将"思考"内化为模型固有能力的公开模型。
思维链(Chain-of-Thought, CoT):思维链是一种提示技术,通过引导模型在回答前生成逐步推理步骤,显著提升复杂任务(如数学、逻辑)的准确率。其原理是让模型将问题分解为中间步骤,利用自回归特性逐步推导,避免直接跳跃到答案。CoT最初以few-shot示例或简单指令(“让我们一步步思考”)实现,后来发展为模型内在能力(如o1通过强化学习内化思考)。CoT揭示了语言模型具备潜在推理能力,只需适当激发。
强化学习:让模型在试错中自我进化
DeepSeek广告 R1论文揭示了o1背后的关键方法——GRPO(组相对策略优化)。其流程是:让模型对同一问题生成多次回答,根据格式和答案正确性打分,计算每个回答相对于组平均分的"优势值",然后依据优势值调整每个token的概率。表现好的回答被整体提升概率,差的被降低。
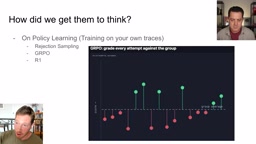
与简单的拒绝采样(只保留正确答案)相比,GRPO能利用负样本,并通过组内归一化抵消噪声。更重要的是,这是on-policy训练——模型学习的是自己生成的推理轨迹,而非人类示范。Berman指出,这使得参数更新更温和,因为模型本就具备生成这些轨迹的能力,只需微调旋钮;而模仿他人思考则可能破坏模型已有的其他能力。
这引出一个关键问题:为什么不能从预训练直接跳到强化学习?Berman解释,一旦模型获得"助手人格",再喂入原始预训练数据(如代码语料),它会模仿数据风格而丢失助手行为。后训练塑造的自我认知具有脆弱性,需要精心维护数据分布。
On-policy与Off-policy学习:在强化学习中,on-policy指智能体使用当前策略生成的数据进行学习,off-policy则使用其他策略(如旧策略或人类示范)产生的数据。GRPO属于on-policy方法,模型从自己生成的推理轨迹中学习,参数更新更稳定,且能保持模型原有能力。相反,模仿人类示范(off-policy)可能导致分布偏移,破坏模型已学到的技能。这一区别解释了为何后训练需精心维护数据分布,避免灾难性遗忘。
模型能否发现新知识?
对话尾声触及了根本性争议:基于历史数据训练的模型,能否超越分布、创造新知?Berman的答案是肯定的。他以爱因斯坦提出广义相对论类比:最初这个想法并不"大概率",但通过长期推理构建新抽象,最终使其成为可推导的结论。语言模型同理——当它们被训练在长视野上自主推理,就能逐步搭建新的概念结构,从而突破训练数据的边界。
这一观点与当前AI界对推理 scaling law 的探索相呼应。尽管Berman承认模型尚未产生改变世界的原创发现,但已在攻克部分未解数学问题。从调参到自我思考,LLM的训练哲学正从"拟合数据"转向"教会学习",而这条路径的终点仍充满想象空间。
相关推荐

间谍蜜罐训练内幕:情感解离与锚定技术
间谍如何被训练执行蜜罐任务?一位受训者披露情感解离、香水与关键词锚定、目标照片绑定等心理学技术,解析条件反射如何被用于情报行动,并揭示这套机制在日常生活营销中的类似应用。

前沿AI风险管理:从训练到部署的全链路实践
OpenAI系统阐述前沿AI风险管理框架:从训练阶段的模型对齐,到部署阶段的沙箱隔离与阻断式防护,再到部署后的持续监控,构建贯穿模型全生命周期的分层风险控制体系。

Databricks推出Genie Migrate,简化Serverless迁移
Databricks 发布 Genie Migrate for Serverless,帮助用户将既有工作负载迁移到 Serverless 计算。本文解析该迁移工具的定位、对用户的实际意义以及尚未明确的细节。