Antigravity SDK支持本地AI模型:Google的深层战略解读
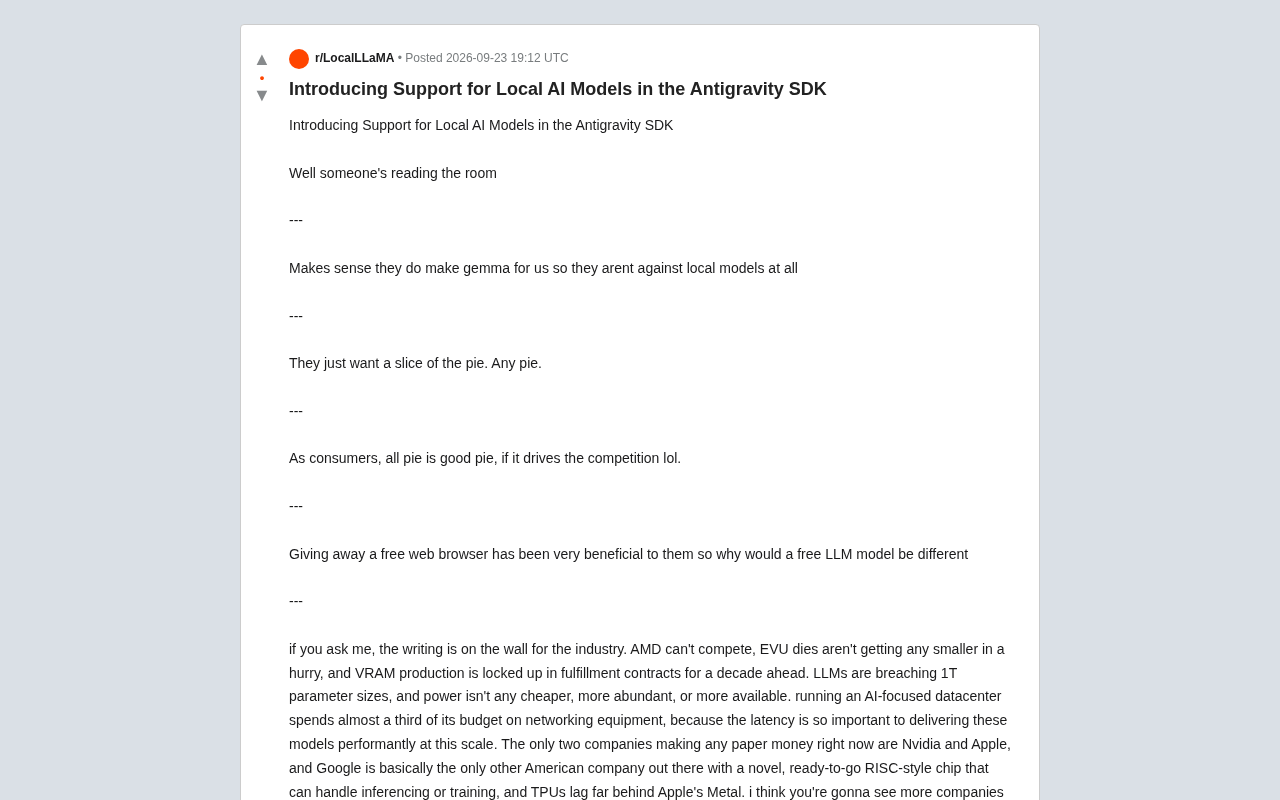
Google的Antigravity SDK支持本地AI模型,折射出AI价值链从"卖模型"向"用模型强化服务"的结构性重构。
Google为其Antigravity SDK增加本地AI模型支持,引发开发者社区对AI行业未来格局的深度讨论。社区的核心共识是:Google的商业本质是服务而非模型,允许用户在本地运行推理,实际上将托管成本转移给了用户,对Google是纯粹利好。结合Google已有的开源Gemma模型系列,这一决策被视为"读懂了行业趋势"的战略布局,而非简单的功能迭代。社区进一步预判,AI泡沫破裂后,以卖模型为生的"前沿模型公司"将难以为继,最终存活的将是能用AI能力增强自身服务生态的企业——Google正是此类公司的典型。尽管开发者普遍欢迎本地推理带来的隐私与成本优势,但对Google"免费递来的钥匙"背后的意图仍保持审慎警惕。
Google的Antigravity SDK宣布支持本地AI模型,这条看似普通的功能更新,在开发者社区引发了一场关于AI行业未来走向的深度讨论。当大多数前沿模型公司仍在死守云端推理的高墙时,Google为何反其道而行之,主动为用户递上运行本地模型的钥匙?
一次"读懂房间"的产品决策
社区对这条消息的第一反应颇为微妙——"总算有人读懂了房间的气氛"。这句评价背后,是开发者们对本地AI需求日益增长却长期被前沿厂商忽视的普遍感受。
有意思的是,Google支持本地模型并不令人意外。正如一位用户指出的,Google本身就发布了开源的Gemma模型系列,"他们为我们做了Gemma,所以他们从不反对本地模型"。Gemma采用宽松的开源许可证免费提供,虽然性能上无法与旗舰的Gemini相提并论,但被普遍认为是一个相当不错的模型。这种"既有闭源旗舰、又有开源轻量"的双轨策略,本身就为支持本地推理埋下了伏笔。
从商业逻辑看,Google免费送出Web浏览器(Chrome)已被证明是极其有益的战略投资,那么免费送出一个LLM模型又有何不同?两者共享同一套底层逻辑:通过降低使用门槛,把用户牢牢绑定在自己的服务生态之内。
Gemma是Google于2024年2月发布的轻量级开源大语言模型系列,基于与Gemini相同的底层研究和技术构建,但针对本地设备运行进行了优化,提供2B和7B等参数规模的版本。其许可证允许商业用途,开发者可以免费下载、微调并部署。Antigravity SDK(也称为Google AI Edge / On-device SDK)则是Google为在Android、iOS及Web端实现本地AI推理而提供的开发工具包,支持将Gemma等模型直接打包进应用,让推理计算在用户设备上完成而无需联网请求云端服务器。两者组合代表Google在"端侧AI"方向的系统性布局,而非一次孤立的功能更新。
Google为什么不怕你用自己的模型
社区中最具洞察力的观点,来自对Google商业模式本质的剖析。这一分析在多条讨论中被反复强调,可视为社区的核心共识。
核心论点是:Google并非又一家"敌对的前沿模型公司",它的生意本质是服务,而非模型本身。允许用户用本地模型来访问Google的服务,对Google而言是纯粹的利好——因为这直接把托管和推理的成本从Google的账单上移除了。而几乎所有人(除了华尔街)都痛苦地意识到,前沿模型的托管成本是何等不可持续。
有评论者用了一个精妙的比喻:在这场AI淘金热中,Google不是那个卖铲子的人,而是拥有埋着黄金的那片土地的人。Google要做的,是把汽车的钥匙交到你手上,甚至给你一张寻找燃料的地图——而那燃料,最终还是Google的。
这也解释了Google对搜索这块"皇冠明珠"的护城心态:它不会吓跑搜索用户,但也不会重蹈柯达或百视达的覆辙。真正的革命者懂得,最好的发明应当是隐形的——扫地机器人不像《杰森一家》里的女佣机器人罗西,它只是地板上一个塑料圆盘。Google深谙此道,它可以把Gemini无声地整合进搜索等现有服务,而无需强行塞进你的工作流。
"泡沫破裂后没有前沿生意"的行业预判
围绕这条消息,社区展开了对整个AI行业结构性困境的讨论。有用户列出了一连串令人警醒的产业现实:
- AMD在AI芯片竞争中难以追赶;
- 制程微缩短期内难有突破;
- VRAM产能已被未来长达十年的履约合同锁死;
- LLM参数规模正突破万亿量级,而电力既不便宜、也不充裕;
- 一个AI数据中心近三分之一的预算花在网络设备上,只因大规模高性能交付对延迟极度敏感。
基于这些判断,该评论者认为行业趋势已经写在墙上:泡沫破裂后,LLM不会消失(正如互联网泡沫没有杀死电子商务),但它作为"前沿模型生意"本身将不复存在。未来剩下的,是用模型增强自身服务的企业,而非以卖模型为生的公司。在这种叙事下,越来越多公司将转向研究如何让本地推理跑起来,因为泡沫之后其他路径都难以赚钱。
需要说明的是,这些芯片产能、数据中心成本等具体判断来自单一评论者的个人观点,未经独立数据源交叉验证,读者应审慎看待。
所谓"前沿模型生意"(frontier model business),指的是以训练和租售当下最大规模、能力最强的基础大语言模型为核心商业模式的公司形态,代表企业包括OpenAI、Anthropic等。这类公司的运营模式高度依赖持续的大规模算力投入和云端API调用收费,边际推理成本难以压缩。相比之下,"用模型增强自身服务"的公司(如Google之于搜索、Adobe之于创意工具)将AI能力视为提升现有产品价值的手段,而非独立的销售对象。互联网泡沫的历史先例常被援引为类比:2000年泡沫破裂后,纯粹的"互联网公司"大批倒闭,但将互联网整合进实体业务的企业(如亚马逊、eBay)最终存活并壮大。这一框架是理解本文核心论点的重要背景。
"云不过是别人的电脑"
讨论中还浮现出一句来自2010年代初的老话:"云不过是别人的电脑(the cloud is just someone else's computer)。"这句略带戏谑的格言,恰好点出了本地AI浪潮的情绪根源——对数据主权和自主控制的渴望。
当推理可以在本地设备完成,用户不必再把每一次请求都交给"别人的电脑"处理。对开发者而言,这意味着更低的延迟、更可控的成本,以及数据不出本地的隐私优势。
当然,社区对Google的态度远非全然信任。一位用户直言不讳:"这确实是Google该走的正确方向,他们也比某些科技公司少一些邪恶,但我不会犯下认为他们可信赖的错误。"这种"方向认可但保持警惕"的态度,或许是面对任何科技巨头开放姿态时最健康的立场。
写在最后
Antigravity SDK支持本地模型,表面是一个开发者工具的功能更新,深层却折射出AI产业正在发生的价值链重构。当前沿模型的经济模型受到质疑,当本地推理的硬件与需求逐渐成熟,Google这类掌握"土地"而非只卖"铲子"的公司,正试图在下一阶段占据更有利的位置。
对开发者和普通用户而言,无论巨头动机如何,能够在本地运行、自主掌控AI模型,本身就是值得欢迎的方向——前提是我们始终对"免费递来的钥匙"背后的意图保持清醒。
相关推荐
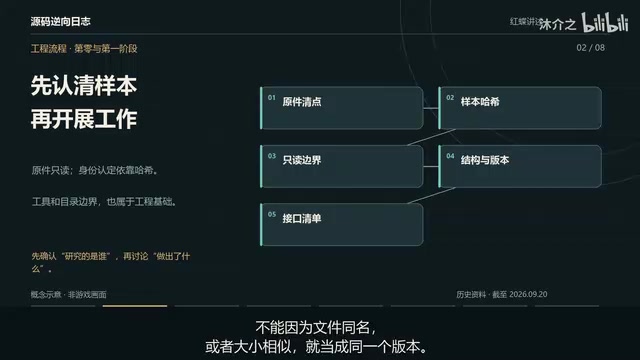
用GPT-6逆向《突袭2》:n2Game_Dll从读懂到替换的方法论
B站UP主募借知用GPT-6逆向即时战术游戏《突袭2》核心库n2Game_Dll,本文详解其七阶段方法论:从打地基、认清样本、画全景图到主线深挖、动态验证与可交接成果,展示严谨逆向工程如何从读懂走到能替换。
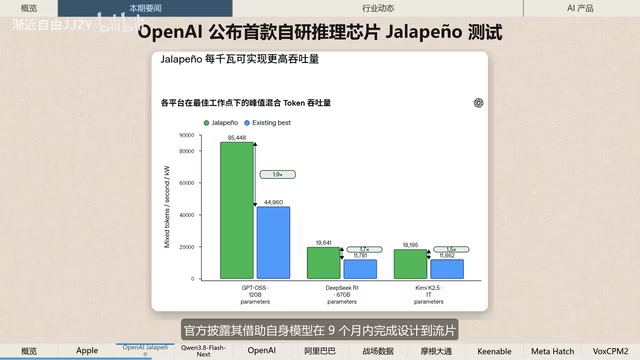
苹果M5 Ultra登场,OpenAI自研芯片Jalapeño跑分超英伟达
8月26日AI早报:苹果发布M5 Ultra四芯片桌面芯片,统一内存最高512GB可本地运行大模型;OpenAI自研推理芯片Jalapeño能效超NVIDIA 1.5至1.9倍;阿里开源新模型、马云增持,Meta推消费级智能体平台Hatch。
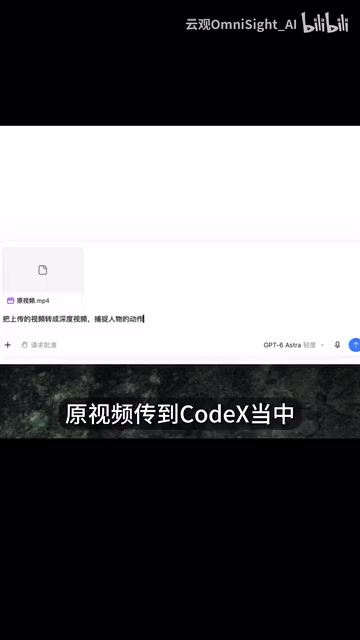
实测Seedance 2.5深度视频:AI复刻多人长镜头动作教程
实测Seedance 2.5深度视频玩法:通过Codex提取深度视频捕捉人物动作,再结合三视图与背景图,借助Agent一键合成高还原度的AI多人长镜头视频。附完整分步教程与本地GPU渲染要点。