AREX-2:用长程反思任务打造自我改进的AI智能体
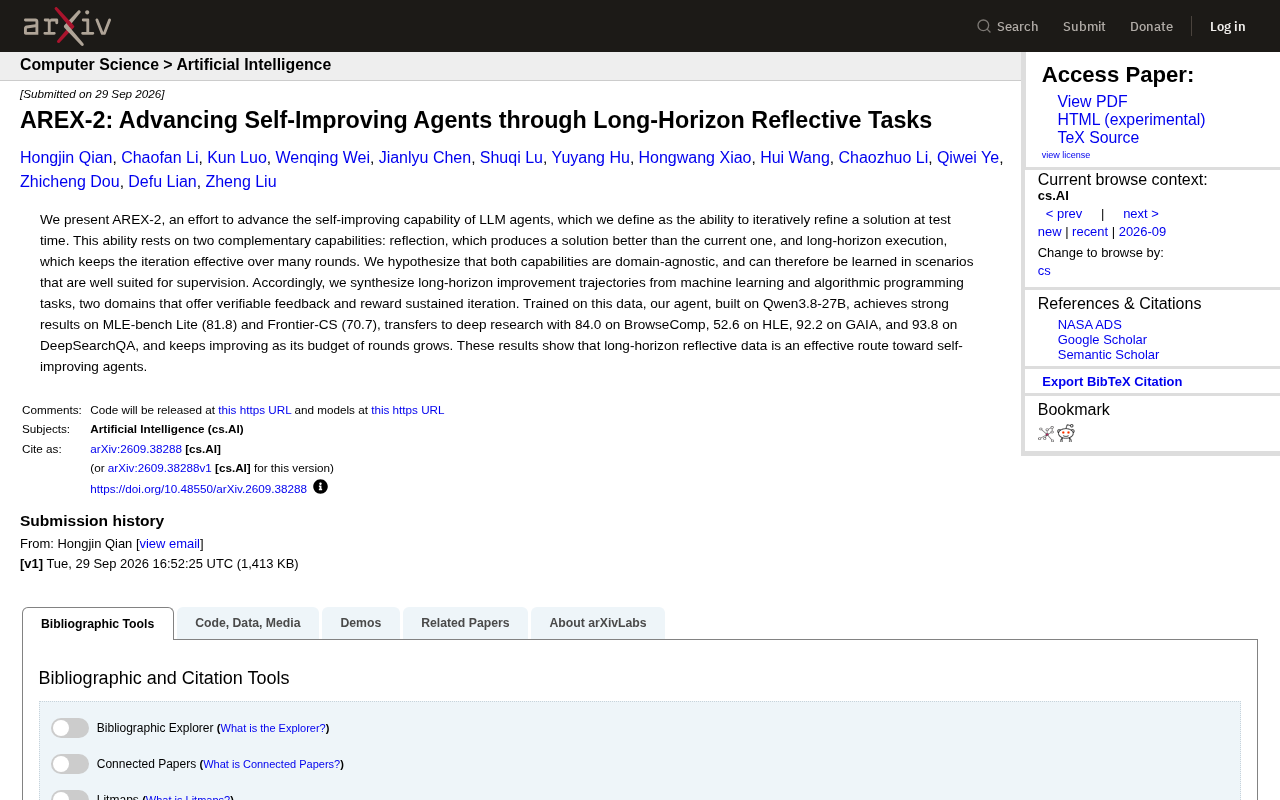
AREX-2通过在可验证领域合成长程反思轨迹,训练出能跨领域迁移的自我改进LLM智能体。
AREX-2是一项推进LLM智能体自我改进能力的最新研究,核心机制是反思(产出更优解)与长程执行(让多轮迭代持续有效)的结合。研究的关键假设是这两种能力具有领域无关性:在机器学习和算法编程这两类反馈信号清晰的场景中合成长程改进轨迹进行训练,习得的能力可以迁移到完全不同的任务上。基于Qwen3.8-27B构建的AREX-2在训练相关领域(MLE-bench Lite 81.8、Frontier-CS 70.7)和深度研究类任务(GAIA 92.2、DeepSearchQA 93.8、BrowseComp 84.0、HLE 52.6)均表现优异,且迭代轮数越多、表现越好,契合当前测试时扩展的研究趋势。这项工作为智能体研究提供了一条可复制的方法论:先在最适合监督的领域培养通用能力,再依靠迁移扩散到难以直接训练的场景。
自我改进智能体为何是关键突破
大语言模型智能体(LLM Agent)的能力边界,正在从"一次性给出答案"向"反复打磨答案"演进。arXiv 最新论文提出的 AREX-2,核心目标正是推进 LLM 智能体的自我改进能力——即在推理阶段(test time)迭代优化自身解决方案的能力。
这种能力听起来简单,实现起来却依赖两个互补的底层机制。研究团队将其拆解为:反思(reflection),负责产出一个比当前版本更优的解;以及长程执行(long-horizon execution),负责让迭代在多轮循环中持续有效,而不是几轮之后就陷入停滞或退化。两者缺一不可——没有反思,迭代就没有方向;没有长程执行能力,再好的反思也无法累积成真正的进步。
核心假设:能力是领域无关的
AREX-2 背后有一个大胆而关键的假设:反思与长程执行这两种能力是**领域无关(domain-agnostic)**的。换句话说,智能体在某个适合监督训练的场景里学会"如何反思、如何坚持迭代",这套能力可以迁移到完全不同的任务领域。
这个假设的价值在于解决了数据来源的难题。如果能力本身是通用的,那么训练数据就不必覆盖所有目标领域,而是可以在最容易提供可验证反馈的场景中合成。研究团队正是沿着这条思路,选择了两类具备明确反馈信号的任务来生成训练数据。
从机器学习与算法编程中合成训练轨迹
团队从两个领域合成长程改进轨迹(long-horizon improvement trajectories):机器学习任务和算法编程任务。这两个领域的共同优势在于——它们都能提供可验证的反馈,并且天然奖励"持续迭代"的行为。
机器学习任务中,模型性能可以通过指标量化,一次次调优都有明确的好坏判断;算法编程任务则可以通过测试用例验证正确性与效率。这种可验证性,让智能体能够在训练中真正学到"什么样的修改带来了改进",从而把反思和长程执行内化为可迁移的能力。
长程改进轨迹(long-horizon improvement trajectories)是指记录智能体从初始解出发、经过多轮反思与修改最终收敛到更优解的完整过程序列。与单步问答数据不同,这类轨迹包含了"为什么上一版本不够好""哪里需要修改""修改后效果如何"等中间推理步骤,使模型能够学到迭代改进的策略而非仅仅学到答案本身。合成这类数据的关键挑战在于:需要一个可靠的外部反馈信号来判断每一步修改是否真正带来了进步。机器学习任务的评估指标(如验证集准确率)和算法编程任务的测试用例(如正确性与运行效率)恰好提供了这种客观、自动化的反馈,使大规模轨迹合成成为可能,同时避免了对人工标注的依赖。
领域无关迁移(domain-agnostic transfer)的假设在机器学习中有深厚的理论根基,与迁移学习和元学习的核心思路一脉相承。其直觉是:某些认知能力——如"发现错误、提出改进、验证改进是否有效"——是跨任务共享的元能力,而非特定领域的知识。类比人类学习:一个经过大量调试代码训练的程序员,往往也能将系统性排查问题的思维方式迁移到写作修订或实验设计上。AREX-2 的新颖之处在于,它将这一假设明确化并付诸实验验证:选择两个反馈信号最清晰的领域作为"能力孵化场",再通过跨领域基准测试来量化迁移效果。实验结果对该假设构成了有力的经验支撑,但其适用边界——例如迁移到需要高度专业知识的领域时是否同样有效——仍是值得后续研究探索的开放问题。
实验结果:从训练领域到广泛迁移
AREX-2 基于 Qwen3.8-27B 构建,在多个基准测试上取得了亮眼成绩。在训练相关的领域内,它在 MLE-bench Lite 上得分 81.8,在 Frontier-CS 上得分 70.7,验证了合成轨迹训练的有效性。
更能说明问题的是跨领域迁移表现。尽管训练数据来自机器学习和算法编程,AREX-2 却能迁移到深度研究(deep research)类任务,成绩包括:
- BrowseComp:84.0
- HLE:52.6
- GAIA:92.2
- DeepSearchQA:93.8
这组数字直接支撑了"能力领域无关"的核心假设——在编程和机器学习场景中习得的反思与长程执行能力,确实迁移到了信息检索、复杂推理等截然不同的任务上。
迭代预算越多,表现越好
论文还强调了一个值得关注的特性:随着迭代轮数预算(budget of rounds)的增加,智能体持续改进。这意味着 AREX-2 并非在几轮之后就触及天花板,而是能够有效利用更多的测试时计算资源来换取更好的结果。
这一点与当前业界对"测试时扩展(test-time scaling)"的关注高度契合。如果一个智能体能够随着思考轮数的增加稳定变强,那么它就为用户提供了一个可控的质量-成本权衡杠杆:对高价值任务投入更多轮次,换取更优解。
测试时扩展(test-time scaling)是近年来 LLM 研究的重要趋势。与训练时扩展(scaling up parameters or training data)不同,测试时扩展指的是在推理阶段投入更多计算资源——例如增加思考步骤、采样更多候选答案或执行更多迭代轮次——来换取更高质量的输出。OpenAI 的 o1/o3 系列以及 DeepSeek广告-R1 等模型的成功,已经证明推理时的"多想一步"可以显著提升复杂任务的解题正确率。AREX-2 将这一思路延伸到智能体场景:迭代轮数本身成为可调节的计算预算,且收益随轮数单调递增而非过早饱和。这意味着该框架天然兼容"按需付费"的部署模式——对时间敏感的轻量任务用少轮次快速返回,对高价值的复杂任务则追加轮次以换取更优解,形成可控的质量-成本权衡。
意义与展望
AREX-2 给出的核心结论清晰而有力:长程反思数据(long-horizon reflective data)是通往自我改进智能体的有效路径。它证明了无需在目标领域直接采集数据,而是通过在可验证反馈充足的场景中训练反思与长程执行能力,就能实现广泛的能力迁移。
对整个智能体研究方向而言,这提供了一条可复制的方法论:先识别哪些能力是通用的,再在最适合监督的领域里高效地培养它们,最后依靠迁移把能力扩散到难以直接训练的场景。随着越来越多的智能体开始强调测试时的持续优化,AREX-2 这类工作或将成为后续研究的重要参照。
相关推荐

MCP协议入门:从概念到天气服务实战开发全解析
本文系统讲解MCP(模型上下文协议)的核心概念、三层架构与两种通信机制,并手把手演示用Python和UV开发天气查询MCP Server、在Claude Desktop中配置调用,以及用MCP Client编码方式连接的完整实战流程。

大模型RAG企业实战:从零搭建问答系统架构
大模型RAG企业项目实战课第一周详解:基于FastAPI构建RESTful API,统一调度本地开源模型与在线API,用PyCharm远程连接Linux服务器完成部署,并用Postman验证前后端问答链路,还原企业级大模型系统的真实开发流程。
RAG知识库系统实战:从零搭建企业级私有知识库全流程
手把手教你搭建企业级RAG私有知识库系统,基于Vue 3与Spring AI,涵盖Milvus向量数据库、分块策略、召回率优化、AI幻觉抑制、来源追溯与访问控制等企业级实战难点,附完整Java+AI学习路径。