ASTEROID:非对称在线蒸馏如何让智能体学会探索

ASTEROID 用非对称在线蒸馏,让学生模型在部分可观测下学会测试时探索。
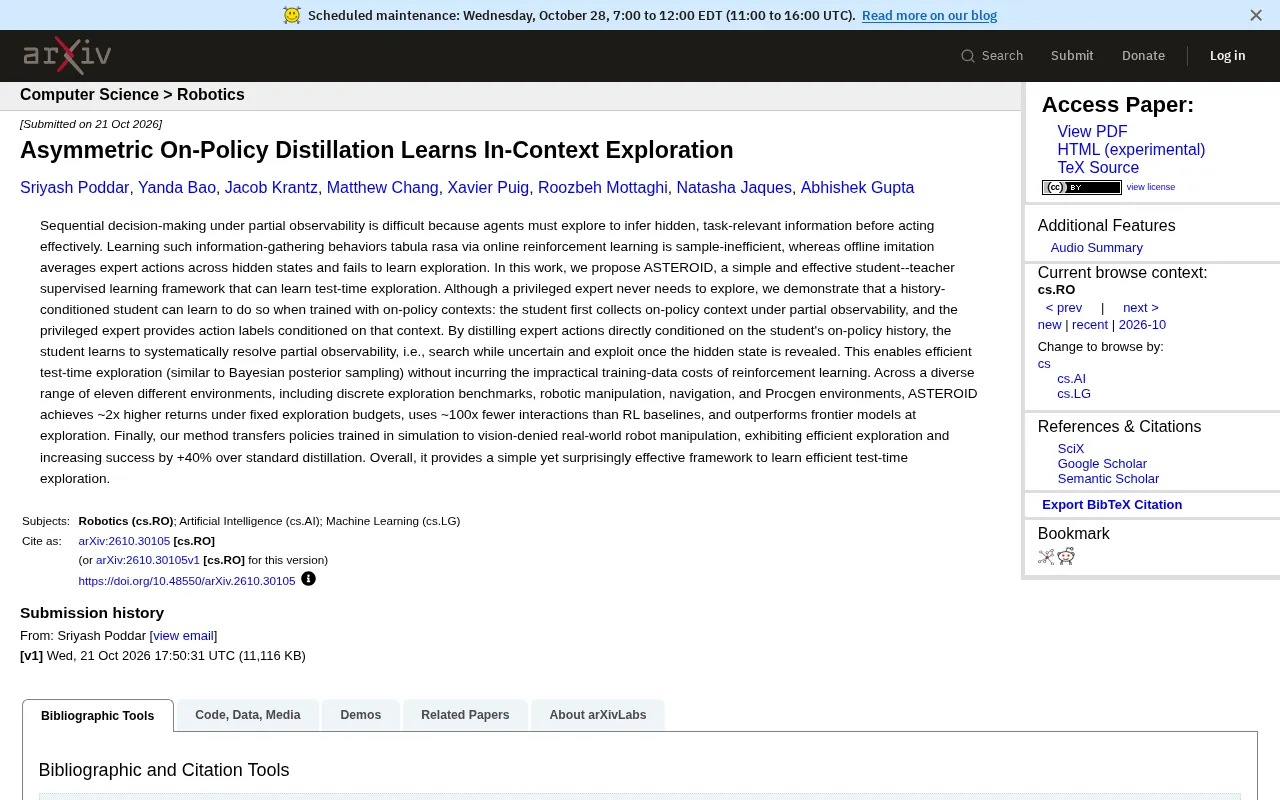
ASTEROID 是一个学生-教师监督学习框架,旨在解决部分可观测序列决策中探索行为难以学习的问题。传统在线强化学习样本效率低,离线模仿学习又因专家动作在隐藏状态上取平均而无法学到探索。ASTEROID 的核心是让学生模型仅依赖历史观测收集在线轨迹,再由能看到真实隐藏状态的特权专家基于学生历史标注动作,通过非对称蒸馏迫使学生学会“先搜索后利用”。在11个环境(离散探索基准、机器人操作、导航、Procgen)中,固定探索预算下回报约为基线两倍,交互次数减少约100倍,并成功迁移到视觉受限的真实机器人操作,成功率比标准蒸馏提升40%。
在部分可观测的序列决策中,智能体常常需要先主动探索、推断隐藏的任务信息,才能做出有效行动。然而,在在线强化学习(RL)中从零学习这种“先探索后利用”的策略样本效率极低,而离线模仿学习则因为对专家动作在隐藏状态上取平均,根本无法学到探索行为。近期一篇题为《Asymmetric On-Policy Distillation Learns In-Context Exploration》的工作提出了 ASTEROID 框架,展示了一种简单却有效的学生-教师监督学习方案,仅通过非对称的在线策略蒸馏,就能让历史条件化的学生模型学会测试时的探索。
核心问题:为什么探索这么难学
部分可观测环境下的决策困难在于,智能体必须通过行动来收集信息,以推断出与任务相关的隐藏状态。例如在机器人操作中,物体的精确位置可能被遮挡;在导航任务中,目标可能不在视野内。此时,最优策略不是直接执行动作,而是先探索、收集信息,再根据推断结果行动——这种“先搜索后利用”的能力是智能体泛化的关键。
传统的在线强化学习虽然能够从零学习这种探索行为,但样本效率极低,因为奖励信号稀疏且延迟,智能体需要大量试错才能偶然发现探索的价值。另一方面,离线模仿学习(如行为克隆)虽然高效,但专家演示通常来自拥有特权信息的专家,这些专家在隐藏状态上平均后的动作,实际上并不包含探索行为——专家在训练时不需要探索,所以学生也无法从专家动作中直接学习探索。
部分可观测马尔可夫决策过程(POMDP) 是理解本文问题的形式化基础。在 POMDP 中,智能体无法直接观测到环境的真实状态,只能接收到与状态相关的观测,并通过历史观测序列维护一个信念状态(belief state),即对隐藏状态的概率分布。最优策略本质上是信念状态的函数:当信念分布熵较高时,主动采取信息增益大的动作以降低不确定性;当信念收敛时,则执行利用动作。本文中“学生只依赖历史观测决策”正是 POMDP 的标准设定,而“特权专家看到真实隐藏状态”则相当于拥有全观测的 MDP 专家。二者之间的信息差,就是非对称蒸馏要跨越的鸿沟。
行为克隆中的“动作平均”问题 值得进一步说明。当专家拥有特权信息(如真实物体位置)时,同一观测历史可能对应多种隐藏状态,专家会针对每种状态输出不同动作。若学生仅以观测历史为输入、以专家动作为标签做监督学习,等价于最小化 (\mathbb{E}[|\pi_\theta(a|h) - \pi^(a|s)|^2]),其最优解是专家动作在隐藏状态后验分布下的条件期望 (\mathbb{E}[\pi^(a|s)|h])。这个平均值往往指向一个“折中”动作,既不探索也不精确利用,甚至会因动作平均而丧失多模态性。这正是离线模仿无法学到探索行为的根本原因,也是 ASTEROID 必须让专家基于学生历史重新标注、而非直接复用离线动作标签的动机。
ASTEROID:非对称在线蒸馏框架
ASTEROID 的核心洞察是:特权专家虽然不需要探索,但它可以在学生自己收集的在线策略上下文上提供动作标签。具体训练流程分为两步:
- 学生在部分可观测下收集在线上下文:学生模型只依赖历史观测(而非真实隐藏状态)进行决策,并收集交互轨迹。
- 特权专家基于该上下文提供动作标签:专家在训练时可以看到真实隐藏状态,但它会根据学生当前的历史上下文来标注动作。通过将专家动作直接条件于学生的在线历史进行蒸馏,学生逐渐学会系统性地解决部分可观测性——在不确定时搜索,一旦隐藏状态揭示则立即利用。
这种非对称性在于:学生与专家的信息输入不同,但专家标签直接针对学生的历史状态,从而避免了离线模仿中“动作平均”的问题。作者指出,这种方法让测试时的探索行为类似于贝叶斯后验采样,而且不需要承担强化学习那样高昂的训练数据成本。
在线策略蒸馏(On-Policy Distillation) 与传统的离线蒸馏或行为克隆的关键区别在于数据分布。在线策略蒸馏中,训练数据由学生模型当前策略与环境交互产生,因此状态分布随学生策略的更新而不断变化,形成一种“边学边练”的闭环。这与 DAgger(Dataset Aggregation)的思想一脉相承:专家在学生访问到的状态上提供标签,从而缓解分布偏移。ASTEROID 将这一思想推广到部分可观测设定,并引入非对称信息结构——专家不仅在该状态上标注,还利用其特权信息给出“在该历史下最优的探索或利用动作”,使得学生逐步对齐专家在信念层面的决策逻辑。
实验结果:11个环境中的高效探索
论文在十一个不同的环境中评估了 ASTEROID,包括离散探索基准、机器人操作、导航以及 Procgen 环境。主要结果如下:
- 在固定的探索预算下,ASTEROID 的回报约为基线方法的两倍。
- 与 RL 基线相比,交互次数减少了约 100 倍。
- 在探索能力上,该方法超越了前沿模型。
- 在仿真训练后,策略成功迁移到视觉受限的真实世界机器人操作任务,相比标准蒸馏方法成功率提升 +40%,并展现出高效的探索行为。
这些结果表明,ASTEROID 在样本效率和探索质量上均具有显著优势。尤其在真实机器人操作中,视觉受限意味着部分可观测性更强,而 ASTEROID 仍能有效探索并完成任务,验证了方法的实用性。
深度分析:为什么非对称蒸馏有效
理解 ASTEROID 有效性的关键在于“非对称”和“在线策略”两个设计。
非对称性:学生只看到历史观测,专家看到完整状态。学生无法直接模仿专家在完整状态下的动作,因为输入不同。但专家根据学生历史来标注动作,相当于告诉学生“在你当前掌握的信息下,应该采取什么动作来获取更多信息或利用已有信息”。这迫使学生学会从历史中推断隐藏状态并做出探索决策。
在线策略上下文:学生自己收集的轨迹覆盖了它在探索过程中遇到的状态分布,而离线数据往往偏离学生的实际分布。在在线策略上下文中蒸馏,学生能够针对自己实际遇到的不确定性进行学习,避免了分布偏移。
直观上,学生学会了一种“搜索-利用”策略:当历史信息不足以确定隐藏状态时,选择能最大程度减少不确定性的动作;当历史已经揭示隐藏状态时,则直接利用。这种策略本质上与贝叶斯后验采样一致——在不确定时采样以获取信息,确定后则利用。
贝叶斯后验采样(Bayesian Posterior Sampling) 是解释 ASTEROID 探索行为的理论视角。在信念空间中,一个理想的探索策略会从当前信念分布中采样一个假设状态,然后针对该假设执行最优动作;当动作结果与假设不符时,信念更新,不确定性降低。这种“采样-检验”机制天然平衡了探索与利用。ASTEROID 的学生模型在历史条件下输出动作,其行为被专家标签引导至近似后验采样的模式:在信息不足时选择能区分不同隐藏状态的动作,在信息充分时直接利用。论文指出这种类比,意味着该方法可能继承了后验采样的理论保证(如对数遗憾界),尽管实际实现中并未显式维护信念分布。
局限与展望
论文未详细讨论专家标注的成本问题:虽然不需要专家在线交互,但仍需要特权专家提供动作标签。此外,方法在真实世界中的迁移仅涉及视觉受限的机器人操作,更广泛的场景(如自动驾驶、医疗决策)尚未验证。不过,ASTEROID 提供了一种简单而有效的框架,为学习高效测试时探索开辟了新思路。
结论
ASTEROID 通过非对称在线策略蒸馏,让学生模型在部分可观测环境中学会系统性的探索行为,在多个基准上实现了约 2 倍的回报、100 倍的交互效率提升,并在真实机器人操作中取得 +40% 的成功率提升。这项工作是模仿学习与强化学习之间的一次巧妙折中,对于需要高效探索的序列决策问题具有重要参考价值。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。