把iPhone变成MacBook第二块GPU:本地大模型预填充提速29–44%

开发者用USB-C将iPhone 17 Pro Max接入MacBook,通过Transformer层拆分与KV缓存卸载,将预填充速度提升29-44%并将上下文窗口扩展至200k以上。
一位开发者将iPhone 17 Pro Max通过USB-C数据线接入24 GB M4 Pro MacBook,利用A19 Pro的Metal 4张量单元,把Transformer的前40层留在Mac、后24层交给手机流水线并行处理。在8k–48k上下文下,预填充速度提升29%–44%,冷启动27k会话耗时从245秒缩短至168秒。当上下文超过64k后,手机角色切换:接管旧KV缓存并用Neural Engine加速旧key的注意力计算,使Mac内存在64k处停止增长,最多可将约5.7 GB KV数据卸载到手机,实现196k–229k的超长上下文。64k以下的生成加速则来自作者fork中的SME2指令与DFlash2推测解码,与手机无关。这一方案的核心价值在于:当单机内存成为硬约束时,异构设备间的层拆分与KV卸载是比堆砌单机算力更务实的本地推理扩展路径。
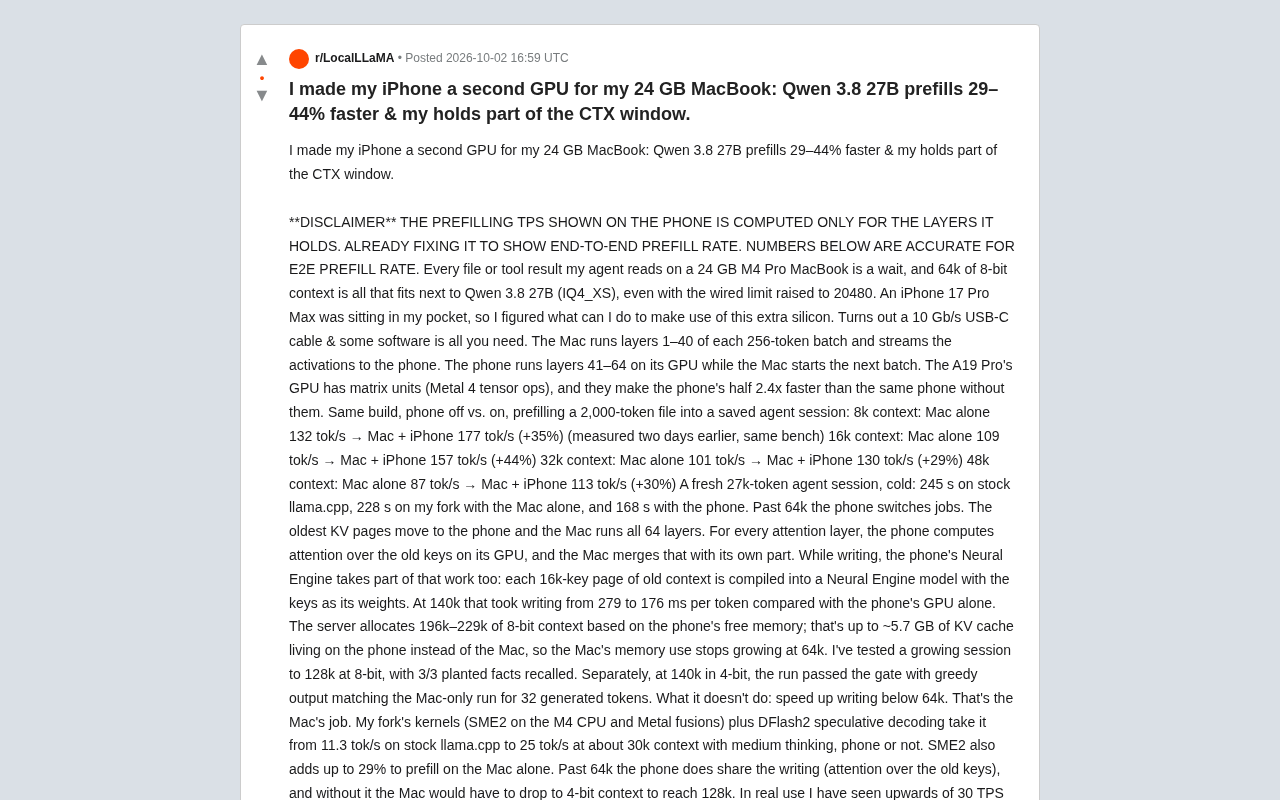
一位开发者在 Reddit 上分享了一个颇具想象力的本地推理方案:用一根 10 Gb/s 的 USB-C 数据线,把 iPhone 17 Pro Max 接入 24 GB 内存的 M4 Pro MacBook,让手机充当第二块 GPU,为本地运行的 Qwen 3.8 27B(IQ4_XS 量化)模型分担计算。结果是预填充(prefill)速度提升 29%–44%,同时手机还能分担一部分上下文窗口的存储压力。
这不是跑分炫技,而是针对本地 Agent 工作流痛点的工程实践——在 24 GB 内存的 Mac 上,模型加载后只剩下容纳约 64k 8-bit 上下文的空间,每次读取文件或工具结果都要等待。作者把口袋里闲置的 A19 Pro 芯片利用了起来。
核心思路:按层拆分,流水线并行
整个方案的关键在于把 Transformer 的层拆开,在两台设备上流水线执行。Mac 负责每个 256-token 批次的第 1–40 层,算完后把激活值(activations)通过 USB-C 流式传给手机;手机用自己的 GPU 跑第 41–64 层,另一边 Mac 已经开始处理下一个批次。
这里真正让方案可行的是 A19 Pro GPU 内置的矩阵运算单元(Metal 4 tensor ops)。作者指出,有了这些张量核心,手机负责的那一半计算比不带张量单元时快了 2.4 倍——这正是让手机值得被拉进推理管线的硬件前提。
激活值(Activations) 是神经网络每一层计算后输出的中间张量。在 Transformer 中,每层的输出会作为下一层的输入,因此层间传输的"数据"就是这份激活值。对于一个 256-token 的批次,激活值的大小约等于 批次大小 × 序列长度 × 隐藏维度 × 数据类型字节数。以 27B 规模模型常见的 5120 隐藏维度、FP16 精度为例,单批次激活值约为 1.3 MB——这正好在 USB-C 3.2 Gen 2(理论 10 Gb/s,实际有效带宽约 800 MB/s)的可接受范围内,延迟仅约 1.6 ms,不会成为流水线的瓶颈。流水线并行的核心优势在于:当手机处理第 41–64 层时,Mac 可以同步开始处理下一个批次的第 1–40 层,两段计算在时间上重叠,从而减少等待造成的吞吐量损耗。
实测数据:上下文越长,收益越明显
作者在同一套构建下,对比了「手机关闭」与「手机开启」两种状态,预填充一个 2,000-token 文件进入已保存的 Agent 会话,得到如下端到端(E2E)预填充速率:
- 8k 上下文:Mac 单独 132 tok/s → Mac + iPhone 177 tok/s(+35%)
- 16k 上下文:109 tok/s → 157 tok/s(+44%)
- 32k 上下文:101 tok/s → 130 tok/s(+29%)
- 48k 上下文:87 tok/s → 113 tok/s(+30%)
在冷启动场景下,一个全新的 27k-token 会话:原版 llama.cpp 需要 245 秒,作者的 fork 在 Mac 单独运行时 228 秒,接入手机后缩短到 168 秒。
需要留意作者的一个诚实更正:手机屏幕上显示的 prefill TPS 只计算了它所承担的那几层,并非端到端速率,他正在修复这个显示问题。上面列出的数字已是准确的端到端预填充率。
超过 64k:手机从「算力」切换为「内存」
方案中最巧妙的部分,是上下文超过 64k 后手机的角色转变。此时手机不再跑第 41–64 层,而是接管旧的 KV 缓存:最早的 KV 页被搬到手机上,Mac 则运行全部 64 层。
对每个注意力层,手机在自己的 GPU 上对旧 key 做注意力计算,再由 Mac 把结果与自身部分合并。更进一步,在生成(writing)阶段,手机的神经引擎(Neural Engine)也被调用——每个 16k-key 的旧上下文页被编译成一个以 key 作为权重的 NE 模型。作者称在 140k 上下文下,这让每 token 的写入时间从 279 ms 降到 176 ms(相比只用手机 GPU)。
服务端会根据手机的空闲内存,分配 196k–229k 的 8-bit 上下文,相当于把最多约 5.7 GB 的 KV 缓存放到手机上,Mac 的内存占用因此在 64k 处停止增长。作者测试了一个增长到 128k(8-bit)的会话,3 个预埋事实全部召回;在 140k(4-bit)下,贪婪解码输出与纯 Mac 运行在 32 个生成 token 上完全一致。
KV 缓存(Key-Value Cache) 是 Transformer 推理时的核心内存开销来源。在自回归生成中,每个注意力层都需要保存所有历史 token 对应的 Key 和 Value 向量,以避免重复计算。其大小与上下文长度成线性增长:上下文长度 × 层数 × (K维度 + V维度) × 数据类型字节数。以 27B 模型、64 层、8-bit 量化为例,每 1k token 约需 0.5–1 MB,64k 上下文就已占用约 32–64 GB,远超普通 Mac 的可用内存。这正是为什么 24 GB MacBook 在加载模型后只剩约 64k 上下文空间——模型权重本身已占用大半内存。将旧的 KV 页卸载到手机,本质上是用 USB-C 带宽换取超出本机内存上限的上下文窗口扩展能力。Neural Engine(神经引擎) 是苹果芯片中专为矩阵乘法和卷积等固定模式运算设计的硬件模块,吞吐量极高但灵活性低于 GPU,适合将重复性的注意力计算编译为固定权重模型后批量执行。
边界与局限:64k 以下写入不加速
作者对这套方案的能力边界说得很清楚。64k 以下的生成速度,手机帮不上忙,那是 Mac 的活儿。真正把生成从原版 llama.cpp 的 11.3 tok/s 拉到约 30k 上下文下 25 tok/s 的,是他 fork 里的自定义内核——M4 CPU 上的 SME2 指令、Metal 融合算子,再加上 DFlash2 推测解码。其中 SME2 还能单独为 Mac 的预填充再贡献最多 29% 的提升。
换句话说,手机带来的提升集中在两个场景:预填充阶段(约 512 token 以上才会让手机加入)和超长上下文的旧 key 注意力计算。在一次真实会话中,36 个请求里只有 7 个触发了手机参与,但这 7 个覆盖了约 83% 被读取的 token。目前的实现还是一次只处理一个请求,且超过 64k 后手机「存储」和「计算层」两件事还不能同时做——作者说这是下一步要解决的。
SME2(Scalable Matrix Extension 2) 是 Arm 架构为高性能矩阵运算引入的 CPU 扩展指令集,首次出现在 Apple M4 所采用的处理器核心中。它允许 CPU 在不依赖 GPU 的情况下高效完成矩阵乘法,对 LLM 推理中的线性层(特别是生成阶段的单 token 矩阵-向量乘法)有显著加速。DFlash2 是作者在 fork 中自研的推测解码(Speculative Decoding)实现:推测解码通过让一个小型草稿模型提前生成多个候选 token,再由主模型并行验证,从而在单次前向传播中输出多个 token,突破自回归逐 token 生成的串行瓶颈。这两项优化均与手机无关,是纯粹的 Mac 端内核改进,解释了为什么在 64k 以下的生成速度(11.3 → 25 tok/s)提升不应归功于 iPhone 的接入。
展望:新架构 + 新手机的叠加潜力
作者提到,真正的「金矿」在于更新的模型架构与更新的手机硬件配合。他举例 DeepSeek广告 V4.1-Flash 的全局 KV 缓存只需每 token 890 字节,并引入了 n-gram 嵌入表(Engram);Qwen3.8-Flash-Next(Qwen 4 架构预览)也带有 n-gram 查找表。这些特性都不在他测试的 27B 模型里,他也尚未对这两种架构做基准测试。
对硬件,他同样期待 iPhone 18 Pro Max 上的 A20 Pro 能释放更多空间。这个项目的代码、配置与基准脚本已开源在 GitHub(StayLameBro/backburner),作者还提到整套系统是借助 Opus 5.5 构建的。
对本地 LLM 爱好者而言,这个方案的价值不在绝对速度,而在于它展示了一条被普遍忽视的路径:当内存成为本地推理的硬约束时,异构设备间的层拆分与 KV 卸载,可能比单纯堆砌单机算力更务实。
相关推荐

用 Clippy 录屏喂给 AI 编程助手:更快的开发工作流
一位开发者分享如何用录屏工具 Clippy 配合 Claude、Codex 等 AI 编程助手:口述演示需求生成结构化链接,Agent 直接获取截图、转录和摘要,省去逐帧处理的时间与 token,大幅提升开发效率。
OpenDocRouter发布:统一API聚合130+文档解析模型
OpenDocRouter发布:统一API聚合130+文档解析模型
OpenDocRouter 发布,提供统一的文档解析 API,聚合 130+ 前沿与开源 OCR/VLM 模型,支持成本价调用、速率限制管理、边界框版面服务及自动路由,解决文档解析模型选型难题。

智能体OCR:如何用恰到好处的AI推理终结脆弱的传统文档识别
OCR长期被脆弱的传统系统主导,而智能体OCR通过动态分配计算、自我纠错和语义理解,有望同时实现更高准确率与更低成本。本文解析为何智能体式编排优于直接堆砌前沿大模型。