本地27B模型实测:Qwen3.8能扛多复杂的编程活?

实测 Qwen3.8:本地 270 亿参数模型能独立完成中等复杂编程任务,架构规划仍需依赖云端大模型。
海外开发者对开源模型 Qwen3.8(270亿参数)进行了三级难度实测,核心问题是"本地模型能可靠处理多复杂的真实任务"。结果显示,HTML 工具类和番茄钟等中等难度应用均能靠单条提示一次成型,表现超出预期;但面对 Nim 语言编写的全栈新闻聚合器,生成的架构规划被 GPT 交叉验证后发现 6 处关键缺陷,说明复杂系统设计仍是明显短板。将规划任务交给云端大模型、编码执行交给本地模型的混合工作流,被认为是兼顾隐私保护与成本控制的实用方案。相比前代 Qwen3.6,新版在中等复杂任务上进步显著,博主表示将从前代升级。
本地大模型的定位:不是替代,而是补充
海外开发者博主对新发布的开源模型 Qwen3.8(270亿参数)进行了一轮实测。与常见的评测思路不同,他从一开始就明确了自己的立场:不去纠结这个模型能否取代 Opus 或 Gemini 这类顶级云端模型,因为直接对比并不是合理的做法。
他真正关心的问题是——一个本地运行的、这种体量的模型,能可靠地处理多复杂的真实任务?
在他看来,本地模型不是付费模型的完全替代品,而是一个补充工具,适合处理相对简单和常规的任务,以及那些不希望数据离开本地电脑的场景。这个定位贯穿了整篇实测,也让评测结论更接地气。
硬件门槛:显存才是关键
博主坦言,他日常主力机是一台仅有 24GB 统一内存的 MacBook,但这个配置跑不动当下的模型——能运行,但速度慢到无法正常使用。因此他把 Qwen3.8 部署在台式机上,再通过局域网从 MacBook 远程调用。
他给出的核心建议非常直接:如果你也想跑 Qwen3.8,最重要的参数是显卡显存越大越好,这是运行 LLM 最关键的指标。推理工具方面,他使用 Ollama 下载和启动模型,但也提到 LM Studio、llama.cpp 等都可以替代。
从实测的 GPU 负载图可以看到,整个模型完全装进了独立显卡显存,还留有充足空间给较大的上下文窗口,GPU 处于满载状态。
显存(VRAM)对 LLM 推理如此关键,是因为模型权重需要完整加载进显存才能高效运算。以 Qwen3.8(270亿参数)为例,以 4-bit 量化方式加载大约需要 14-16GB 显存,若使用更高精度则需求更高。当模型无法完全装入显存时,系统会将部分层卸载到内存甚至硬盘,导致推理速度大幅下降——往往从每秒数十个 token 跌至个位数,实际使用体验极差。MacBook 的统一内存(Unified Memory)由 CPU 和 GPU 共享,虽然容量可观,但苹果芯片的 GPU 显存带宽远低于独立显卡(如 RTX 4090 的 1TB/s 带宽),这是速度瓶颈的根本原因。因此在选购或配置本地推理硬件时,独立显卡的显存容量是首要考量指标,而非整机内存。
三级难度实测:从简单到复杂
博主使用了自己在 GitHub 上维护的提示词仓库,这些提示按从简单到复杂排列,代理工具选用了极简且可扩展的 Py(他强调这能让他最直接地接触模型)。
第一关:时钟 + 秒表 + 计时器
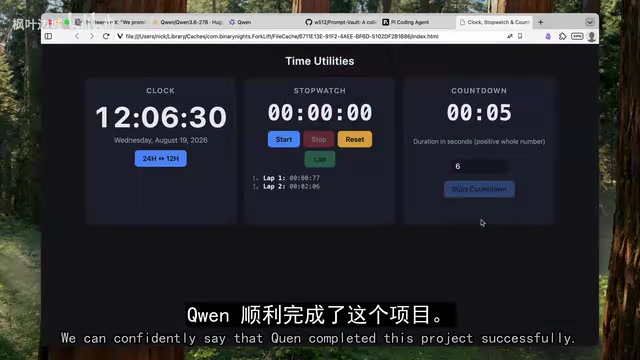
最简单的任务是创建一个包含时钟、秒表和计时器的 HTML 页面。由于难度低,他没有制定任何计划,直接让模型根据描述实现。生成文件耗时略超 3 分钟,速度不错。打开浏览器后,时钟、秒表、计时器一应俱全,按钮可用,功能全部正确。这一关轻松过关。
第二关:番茄钟(Pomodoro)
第二个任务藏着隐性难度:番茄钟有多个状态,应用需要正确识别并在状态间切换,还要实现浏览器通知、保存分析数据和设置,以及流畅的动画。
通常对这类中等难度任务,博主会先让模型制定实现计划再逐步执行。但这次他故意加大挑战,同样不给计划、只凭描述让模型一次性实现。结果生成耗时约 6 分钟(是简单任务的两倍),打开后设计效果出乎意料地好,功能完整、没有报错。他直言"非常惊讶",模型第一个提示就做到了这种水平。
第三关:全栈新闻聚合器,模型撞上天花板
真正的硬骨头是第三个任务:不仅要前端,还要后端和数据库,需要一个新闻订阅聚合器。为进一步加大难度,博主要求项目用小众的 Nim 编程语言编写——这是一门他个人偏爱但尚不流行的语言。
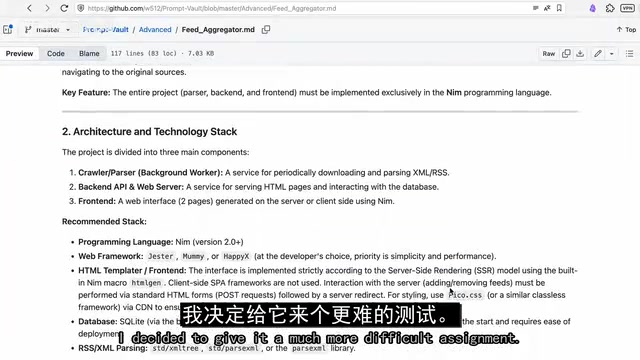
面对这种复杂度,单条提示显然不现实。他的做法是:先让模型基于项目描述生成实现计划,再把计划拆分成一个个小任务。
计划环节暴露短板
几分钟后计划生成完毕,初看相当详细、具体。但博主把项目描述和这份计划交给 OpenAI 的新模型(视频中称为 GPT 5.6)交叉验证,结果大模型指出了 6 个关键问题:整体概念不错,但尚未达到可实施的程度。
这就是博主找到的第一个明确局限——Qwen3.8 不适合复杂的架构设计和项目规划任务。考虑到它的体量,这个结果在他的预期之内。
执行环节表现出色
于是他换成自己常用的工作方式:先和 ChatGPT 一起完善实现计划、拆成小任务,再逐条交给 Qwen 执行。整个过程约 2 小时,中间偶尔需要纠正模型、帮它处理某些语法。
最终应用成功运行:前端正常打开,添加 RSS 源后文章顺利加载,说明后端和数据库也按预期工作。虽然只是原型而非成品,但它包含了异步网络操作和数据库处理,在一门冷门语言上完成了任务。博主认为这是"优秀的结果"。
Nim 是一门静态类型的编译型语言,语法风格接近 Python,但编译后性能接近 C。由于社区规模小、公开代码库有限,它在 LLM 训练数据中的覆盖度极低,这使得模型在处理 Nim 项目时面临双重挑战:既要理解特定的语法约定,又要应对训练数据稀疏带来的"知识盲区"。选用冷门语言作为测试场景,能有效放大模型在少见语言上的泛化能力与局限,是评估编程助手真实上限的有效手段。博主最终能完成这个原型,一定程度上也依赖了模型将通用编程逻辑迁移到 Nim 语法的能力,而非对该语言的深度掌握。
与前代对比:进步明显
博主特别把 Qwen3.8 和前代 Qwen3.6 做了对比。在此前的测试中,Qwen3.6 连中等难度任务都很吃力,即便拆成小任务也勉强;而新的 Qwen3.8 甚至能靠单条提示轻松搞定同类任务。进步显而易见。
结论:本地模型值得信任的边界在哪
综合三关实测,可以清晰画出 Qwen3.8 作为本地模型的能力边界:
- 可放心交付:单文件工具类项目、中等复杂度的前端应用,甚至能一次成型;分解清晰的顺序化编程任务。
- 仍需大模型:复杂的系统架构设计与项目整体规划——这类任务交给更大的云端模型更稳妥。
博主给出的实用工作流也值得借鉴:用大模型(如 ChatGPT)做规划和方案审查,用本地模型做具体编码执行,两者配合既能保护数据隐私,又能控制成本。他表示自己会从前代升级到 Qwen3.8。对于希望在本地跑编程助手、又对显存有一定投入的开发者来说,这个模型已经跨过了"可用"的门槛。
这种"规划交云端、执行靠本地"的混合工作流,在隐私保护与成本控制之间取得了务实的平衡。具体代码实现往往涉及公司内部逻辑、专有算法或敏感数据结构,适合留在本地处理;而架构设计和方案评审所需的上下文通常是抽象的描述,即便发送给云端服务,实际泄露的敏感信息也相对有限。此外,编码执行任务的 token 消耗量远大于规划任务,用本地模型承担这部分工作可以显著降低 API 费用。随着开源模型能力持续提升,这一工作流中"需要云端介入"的边界也在不断向复杂方向移动。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。