本地AI模型为何慢?内存带宽才是速度天花板

本地大模型生成速度的上限约等于内存带宽除以模型大小,瓶颈在带宽而非算力。
文章指出,本地运行大模型的速度瓶颈并非芯片算力,而是内存带宽。原因是每生成一个token,模型都要从主内存完整重读全部参数,无法像传统程序那样缓存复用。由此可得简洁公式:最大速度(tokens/秒)≈内存带宽÷模型大小。以M5 Max的614 GB/s运行17GB模型为例,理论约36 tokens/秒,实测约31 tokens/秒,14%的差距来自带宽未达峰值、注意力开销与软件调度。该上限在无优化时几乎不可突破,因此选型应优先看带宽而非核心数,并用模型量化、投机解码、KV缓存优化等手段部分突破。
很多人以为本地运行大模型的速度取决于芯片算力,但真相是:内存带宽才是决定token生成速度的硬上限。这个被大多数人忽略的指标,解释了为什么你花大价钱买的顶配硬件,跑起来依然不够快。
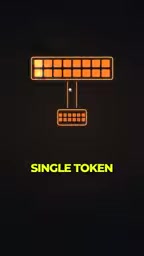
核心机制:每生成一个token,模型都要被完整读一遍
大语言模型推理有一个反直觉的特性:每生成一个token,模型都需要从内存中重新读取全部参数。一个17GB的模型,意味着每输出一个字,这17GB数据就要在内存和计算单元之间完整搬运一次。
这不像传统程序那样可以把数据缓存起来反复使用。模型参数规模动辄几十GB,远超CPU缓存容量,所以每次推理都必须从主内存重新加载。速度的瓶颈不在算力,而在数据搬运的速度。
内存带宽指内存在单位时间内能传输的数据总量,通常以GB/s为单位。它与内存容量是两回事:容量决定能装下多大的模型,带宽决定数据搬运有多快。大模型推理属于典型的“内存受限”(memory-bound)负载——计算单元大部分时间在等待数据从内存送达,而非忙于运算。与之相对的是“计算受限”(compute-bound)负载,如大规模矩阵批量运算,此时算力才是瓶颈。理解这一区分是判断硬件配置是否合理的前提:本地单用户推理几乎总是内存受限。
计算公式:带宽除以模型大小
根据YouTube技术频道的分析,本地AI的token生成速度存在一个理论上限,公式非常简洁:
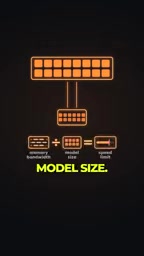
最大速度(tokens/秒)≈ 内存带宽 ÷ 模型大小
以M5 Max芯片为例,其内存带宽可达614 GB/s。运行一个17GB的模型时,理论速度上限约为36 tokens/秒。而实际基准测试结果大约在31 tokens/秒——理论值与实测值相当接近,说明这个公式能较好地预测真实性能。
理论值与实测值的差距从何而来
理论预测36 tokens/秒,实测31 tokens/秒,约14%的差距来自多个因素:内存读取并非总能达到峰值带宽、注意力机制的计算开销、以及软件栈的调度损耗。
但关键在于,这个公式给出的上限在没有进一步优化的情况下几乎不可突破。你可以升级CPU、增加核心数,但如果内存带宽不变,速度就不会有实质性提升。这也解释了为什么某些配置看似豪华,跑本地模型却依然缓慢。
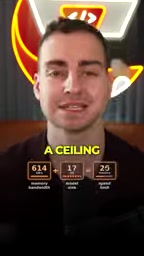
注意力机制的计算开销主要来自KV缓存:生成每个token时,模型需要与之前所有token的键值向量做注意力运算。序列越长,KV缓存越大,读取它占用的额外带宽就越多,实际可用带宽会被摊薄。此外,投机解码(speculative decoding)通过让小模型先草拟多个token、再由大模型并行验证,把多次串行读取合并为一次批量读取,从而在带宽不变的情况下提高有效吞吐。这类优化能部分突破公式上限,但收益取决于草稿模型的命中率,并非无条件生效。
对本地AI部署的实际启示
理解这个公式后,硬件选择就有了明确方向:
- 优先关注内存带宽而非核心数量。对于本地推理场景,高带宽内存(如苹果统一内存架构、或高端GPU的HBM)比多核CPU更重要。
- 模型大小直接决定速度上限。量化压缩模型(如4-bit量化可将17GB降至约5GB)能显著提升速度,代价是精度损失。
- 优化手段存在但空间有限。投机解码、KV缓存优化等技术可以突破部分限制,但基础公式仍然成立。
这个简单的除法公式,是判断任何本地AI硬件配置是否合理的快速标尺。在选购设备或评估性能预期时,先算一算带宽与模型大小的比值,比看跑分更能反映真实体验。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。