本地部署前沿AI模型:硬件自主运行的可能性
本文探讨在自有硬件上运行前沿AI模型的可行性、门槛与核心价值。
本文围绕「在本地硬件上运行前沿AI」这一议题展开,分析了当前面临的三大核心门槛:显存与算力需求极高、顶尖闭源模型不开放权重、本地部署工程复杂度较大。与此同时,文章也指出本地部署的核心吸引力在于数据主权、长期成本优势以及不受服务商限制的使用自由。随着开源模型能力持续提升(如 Llama、Mistral、DeepSeek 等系列)以及量化技术的进步,本地方案与云端服务之间的能力差距正在收窄。文章最终认为,尽管完整复现「前沿」体验仍有难度,但这条路径的可行性正在稳步提高,值得关注隐私与技术自主的用户持续跟踪。
前沿AI能否跑在自己的硬件上
随着大型语言模型的能力不断提升,一个越来越受关注的话题浮出水面:能否在自己的硬件上运行前沿级别的AI模型,而不依赖云端服务?这一议题在 Hacker News 上被提出,尽管讨论热度尚处于早期阶段,但它触及了当前AI生态中一个核心矛盾——算力集中与数据自主之间的张力。
对于开发者和技术爱好者而言,将AI模型部署在本地硬件上意味着更强的隐私保护、更低的长期成本以及不受外部服务限制的自由度。这也是近年来开源模型社区快速发展的重要驱动力。
注:本文基于 Hacker News 上标题为「Frontier AI on Your Own Hardware」的讨论条目撰写。该条目目前信息有限(5 分、暂无评论),以下分析结合当前本地AI部署的普遍现状展开。
本地运行AI的现实门槛
所谓「前沿AI」通常指参数规模庞大、能力接近顶尖水平的模型。要在个人或小型团队的硬件上运行这类模型,面临几个关键约束:
显存与算力
大型模型对显存的需求极高。运行数百亿甚至上千亿参数的模型,往往需要多张高端GPU或专用加速卡。即便通过量化技术(如 4-bit、8-bit 量化)压缩模型体积,硬件成本依然可观。
量化技术是本地部署中最关键的压缩手段之一。其核心思路是将模型权重从高精度浮点数(如 FP16、BF16)降低为更低精度的整数表示(如 INT8、INT4),从而成倍减少显存占用。以一个 700 亿参数的模型为例,FP16 精度下需要约 140GB 显存,而经过 4-bit 量化后可压缩至 35GB 左右,使其勉强可在消费级多卡环境中运行。常见的量化方案包括 GPTQ、AWQ 和 GGUF(后者被 llama.cpp 广泛使用),各有精度损失与推理速度上的不同权衡。量化并非没有代价——压缩比越高,模型在复杂推理任务上的表现往往会有所下降,因此选择合适的量化精度需要在硬件限制与能力需求之间仔细平衡。
模型可获取性
真正的「前沿」模型(如最顶尖的闭源模型)通常不开放权重,无法本地部署。用户能够在本地运行的,多为开源或半开源模型。这些模型在能力上不断逼近闭源前沿,但差距仍然存在。
开源模型生态的代表性项目包括 Meta 的 Llama 系列、Mistral AI 的 Mistral/Mixtral 系列,以及国内的 Qwen、DeepSeek广告 等。这些模型以「开放权重」的形式发布,用户可以下载并在本地运行,但许可协议各异,部分模型禁止商业用途。值得注意的是,「开放权重」与真正意义上的「开源」存在区别:前者仅公开模型参数,训练数据与完整训练代码通常不对外披露。尽管如此,开放权重模型已足以支撑绝大多数本地部署场景。近年来,开放权重模型的能力提升速度显著,在多项基准测试中已能追平甚至超越一年前的顶尖闭源模型,使得「等待开源追赶」成为本地部署用户的一种可行策略。
工程复杂度
本地部署涉及推理框架选择、量化配置、硬件调优等一系列工程问题。相比一键调用的云端API,本地方案对使用者的技术能力提出了更高要求。
目前本地部署的主流工具链已大幅降低了工程门槛。llama.cpp 支持纯 CPU 推理及多种量化格式,适合硬件受限场景;Ollama 在其基础上封装了更友好的命令行与 API 接口,可一键拉取并运行主流模型;LM Studio 则提供了图形化界面,适合非技术用户。面向生产级部署的场景,vLLM 和 Text Generation Inference(TGI)提供了更高效的批处理与并发推理能力。硬件侧,NVIDIA GPU 因 CUDA 生态成熟而占据主导地位,但 AMD ROCm、Apple Silicon(通过 Metal 加速)以及纯 CPU 方案也在持续完善,使得本地部署的硬件选择更加多元。
为什么本地部署仍然值得关注
尽管存在门槛,本地运行AI的趋势不容忽视。开源模型生态的成熟,加上消费级硬件性能的持续提升,正在缩小本地方案与云端方案之间的能力鸿沟。
数据主权是核心驱动力之一。对于处理敏感数据的企业和个人,将数据留在本地而非上传至第三方服务器,具有不可替代的价值。此外,一次性硬件投入相比持续的API调用费用,在高频使用场景下可能更具经济性。
本地部署还带来了不受审查和限速的自由——模型完全由使用者掌控,不会因服务商政策变更而中断。
结语
「在自己硬件上运行前沿AI」既是一个技术命题,也是一种理念表达。它反映了技术社区对算力去中心化、数据自主的持续追求。虽然当前受限于硬件成本与模型可获取性,完全的「前沿」体验仍难以在本地复现,但随着开源模型和硬件的共同演进,这条路径的可行性正在稳步提高。
对于关注隐私、成本控制和技术自主的用户来说,持续跟踪本地AI部署方案的进展,将是一个有价值的方向。
相关推荐
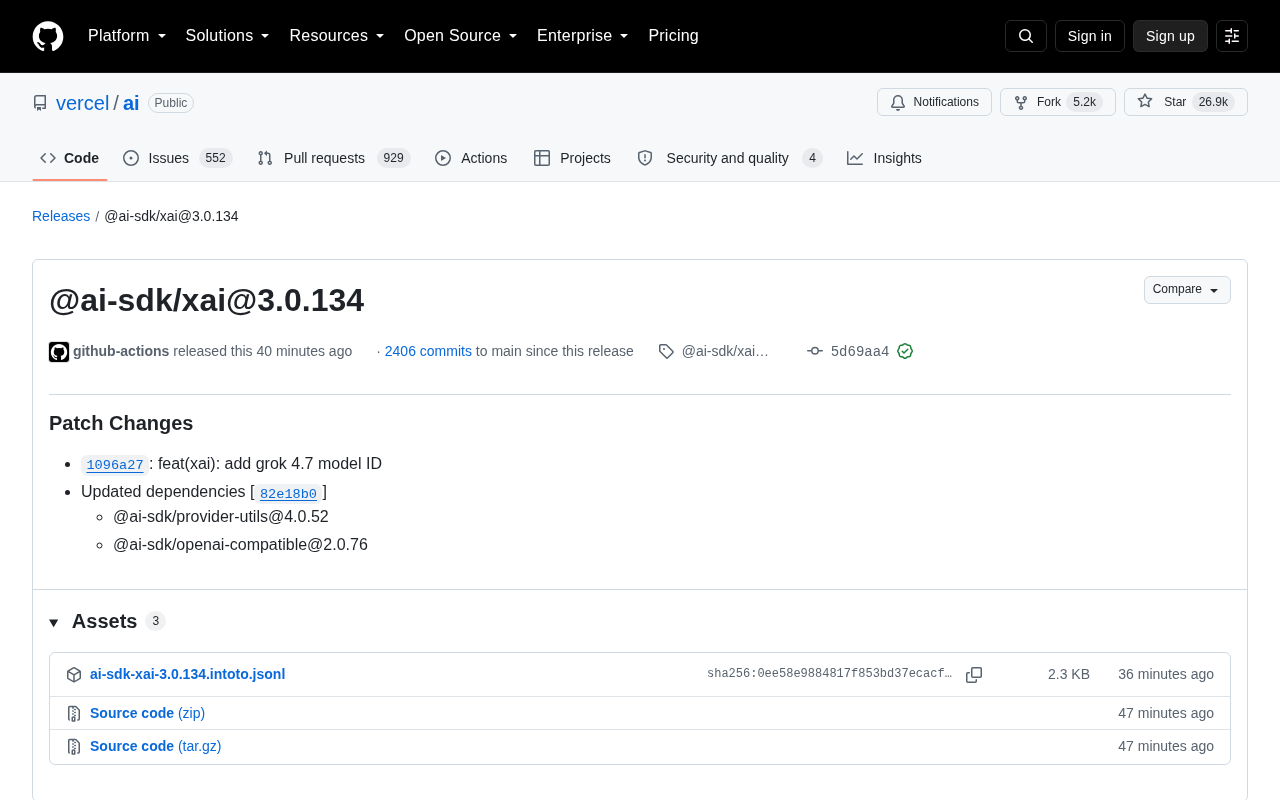
Vercel AI SDK 更新:@ai-sdk/xai 新增 Grok 模型支持
Vercel AI SDK 发布 @ai-sdk/xai@3.0.134 补丁更新,新增对新版 Grok 模型 ID 的支持,并同步升级 provider-utils 与 openai-compatible 依赖。本文解读更新内容及开发者应对建议。

Gemini Pro 订阅方案对比:Pixel 失效后如何选择
Gemini Pro 订阅方案最新对比:Pixel 渠道被谷歌封控失效,学生优惠认证收紧仅推荐老账号,Jio 渠道虽便捷但存在掉订阅与价格波动风险。一文看懂如何选择合适的 Gemini Pro 订阅渠道。
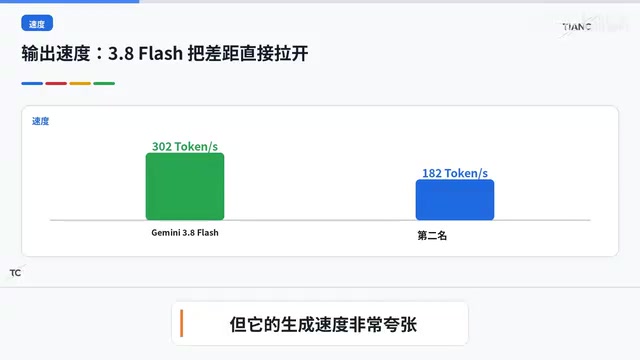
Gemini 3.5 Pro难产背后:谷歌为何疯狂押注Flash
Gemini 3.5 Pro延期难产,谷歌却疯狂迭代3.8 Flash。本文从智能、速度、单位任务成本与TPU算力能效角度,解析谷歌如何重新定义大模型战争,从军备竞赛转向工业竞赛。