本地大模型能否取代云端API?从Qwen与Hermes实践谈起

Reddit用户以战锤梗力挺本地模型,Qwen+Hermes组合折射开源替代云端API的真实趋势。
一则充满《战锤40K》梗文化的Reddit帖子,以"Local can do all"为口号,展示了开发者用Qwen与Hermes两款开源模型搭建本地Agent的实践,引发社区广泛共鸣。帖子背后是一个真实的技术趋势:隐私保护、零边际成本与完全可控的自由度,正驱使越来越多用户转向本地部署方案。Qwen凭借均衡的中英文推理能力胜任通用任务,Hermes则以出色的函数调用和指令遵循能力主导Agent执行,二者组合可拼装出接近商业API的效果。尽管顶级闭源模型在复杂推理和超长上下文上仍有优势,硬件门槛也是现实约束,但对日常文本处理、代码辅助等场景而言,本地模型已然"够用",且随着量化技术与部署工具的持续成熟,其适用边界还在不断扩大。
引言:当本地模型遇上云端API
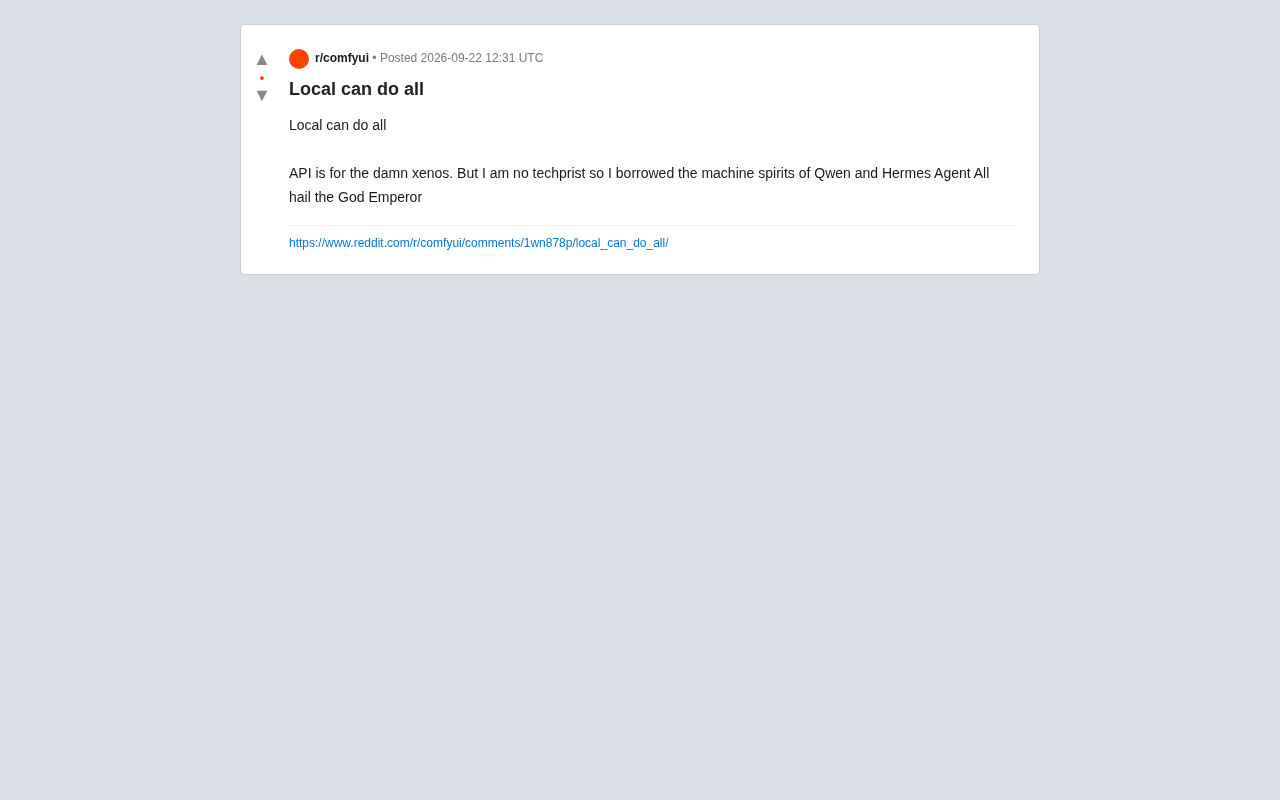
近期一则来自 Reddit 社区的帖子引发了本地大模型爱好者的讨论。发帖者用戏谑的《战锤40K》风格宣称"Local can do all"(本地全能),并把云端 API 调侃为"给异形(xenos)用的东西",同时提到自己借助了 Qwen 与 Hermes 这两套模型来搭建本地 Agent。
虽然帖子本身文字不多、带有强烈的梗文化色彩,但它折射出一个真实且日益升温的趋势:越来越多的开发者与爱好者,正在尝试用本地部署的开源模型来替代付费的云端 API 服务。
本地部署为何越来越有吸引力
发帖者的核心态度很鲜明——不依赖外部 API,把一切放在本地运行。这种偏好背后有几个现实动因。
隐私与数据主权是首要考量。使用云端 API 意味着提示词、上下文乃至业务数据都要经过第三方服务器,对于注重数据安全的用户而言,本地运行意味着数据从不离开自己的机器。
成本可控是另一个因素。云端 API 通常按 token 计费,高频调用或长上下文场景下费用累积迅速。而本地模型一旦部署完成,边际调用成本几乎为零,只需承担硬件与电力开销。
离线可用与自由度同样重要。本地模型不受网络波动、服务商限流或政策调整影响,用户可以自由微调、量化、组合不同模型,构建完全属于自己的工作流。
本地部署的技术可行性近年来得益于两项关键进展而大幅提升:其一是量化技术(Quantization),通过将模型权重从 32 位或 16 位浮点数压缩为 8 位、4 位乃至更低精度的整数表示,可将模型显存占用降低至原来的 1/4 甚至更少,使普通消费级显卡(如 RTX 3090、4090)能够运行数十亿参数规模的模型;其二是以 Ollama、llama.cpp、LM Studio 为代表的本地推理框架日趋成熟,大幅降低了部署门槛,普通用户无需深入了解 CUDA 编程即可一键运行开源模型。这两项进展共同构成了"本地全能"口号从口号走向现实的技术基础。
Qwen 与 Hermes:两种典型的本地选择
帖子提到的 Qwen 与 Hermes,代表了当前开源本地模型生态中的两类实力派。
Qwen 系列
Qwen(通义千问广告)是阿里推出的开源大模型系列,凭借多尺寸版本、良好的中英文能力以及活跃的社区支持,成为本地部署的热门选择。它在推理、代码和多语言任务上表现均衡,且提供了从小参数到大参数的多种规格,方便用户根据自己的硬件条件灵活取舍。
Hermes 系列
Hermes 是 Nous Research 基于开源基座微调的模型系列,以出色的指令遵循和 Agent 能力著称。发帖者特别提到用它来充当"Agent",说明 Hermes 在函数调用、任务规划等自主执行场景中的适配性获得了社区认可。
将两者结合使用——一个负责通用推理,一个专注 Agent 执行——正是本地玩家常见的组合策略:用不同模型各取所长,拼装出接近甚至媲美商业 API 的能力。
Hermes 系列目前已迭代至 Hermes 3 版本,基座通常选用 Meta 的 Llama 系列或 Mistral 系列,通过 Nous Research 的专项指令微调(Instruction Fine-Tuning)和对齐训练,使模型更擅长遵循复杂指令、进行多步推理和调用外部工具。所谓"函数调用"(Function Calling)能力,指模型能够理解何时需要调用预定义的外部工具(如搜索、计算器、代码执行器),并输出结构化的调用参数,再将工具返回结果整合进最终答案——这是构建自主 Agent 工作流的核心基础。Hermes 对 JSON 结构化输出的良好支持,使其在 LangChain、AutoGen 等主流 Agent 框架中具有较好的兼容性,也是社区将其定位为"Agent 专用模型"的主要原因。
"Local can do all"是理想还是现实
发帖者的口号充满信心,但客观来看,本地模型"全能"仍需辩证看待。
在能力上限方面,顶级闭源模型(如最新的商业旗舰)在复杂推理、超长上下文和多模态方面仍有优势。本地开源模型虽然进步神速,但要完全替代所有场景,尤其是对精度要求极高的任务,仍存在差距。
在硬件门槛方面,运行较大参数的模型需要可观的显存与算力,这对普通用户是一道现实门槛。量化技术虽能降低要求,但也会带来一定的性能损耗。
不过,对于大量日常任务——文本处理、代码辅助、简单 Agent 自动化——本地模型确实已经"够用",甚至体验优于付费 API。发帖者的实践正是这一现实的生动缩影。
结语
这则短小的 Reddit 帖子以幽默方式表达了一个严肃趋势:本地开源模型正在成为可靠的生产力工具。Qwen 与 Hermes 的组合,展示了普通用户如何用开源生态搭建自己的 AI 工作流。
对于是否"抛弃云端、拥抱本地",答案因人而异。但可以确定的是,随着开源模型能力持续提升、部署工具日益成熟,本地方案的适用边界会不断扩大。对于重视隐私、成本与自主性的用户来说,现在正是尝试本地大模型的好时机。
相关推荐
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
我让Claude构建可漫步的物理精确O'Neill圆柱:AI生成3D模拟的边界
一位开发者让Claude构建物理精确、可实时漫步的O'Neill圆柱太空栖息地模拟。本文解析其中的科里奥利力、重力梯度等物理挑战,以及AI生成交互式3D模拟的现实意义与局限。

破解数据锁定:用REGISTER与UNREGISTER API实现目录可移植性
湖仓架构下,开放表格式解决了存储可移植性,但目录锁定成为新难题。本文解析REGISTER与UNREGISTER API如何实现元数据松耦合,帮助企业避免厂商绑定、支持多目录协作并安全迁移数据。
macOS 27 AI模型清理工具:如何移除与禁用Apple本地AI
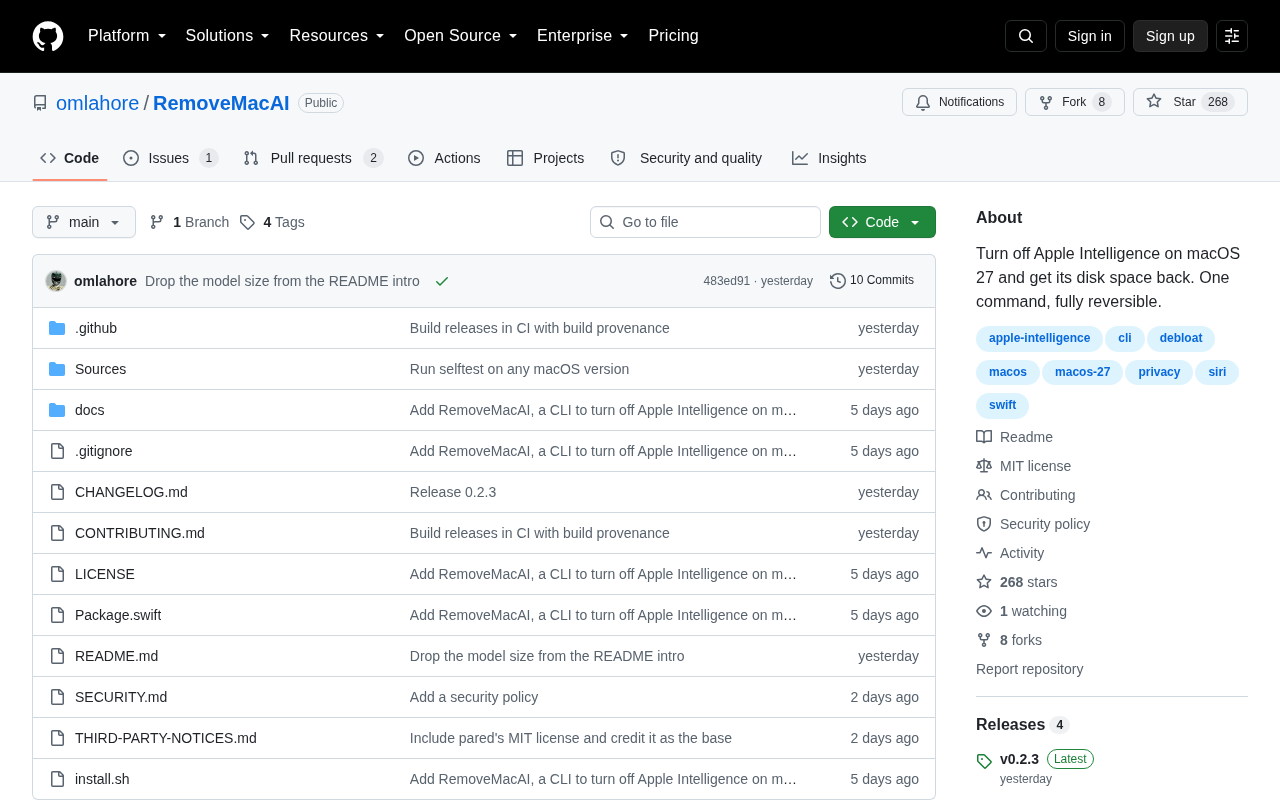
一款登上Hacker News热榜的开源工具可移除和禁用macOS 27中的Apple本地AI模型,帮助用户释放磁盘空间、节省资源并提升隐私可控性。本文解析其工作原理、风险与背后的用户诉求。