本地大模型为何突然好用?三道关卡被依次松开

本地模型变好用,靠的是量化、蒸馏、混合专家三道关卡依次被松开。
文章把本地模型“从答非所问到对答如流”的转变拆解为三道关卡:装得下、会想、跑得快。装得下靠量化,4位是精度与体积的平衡点,低于4位性能断崖式下降;会想靠蒸馏,让小模型学到打大模型的推理过程,320亿模型蒸馏后得分从47跳到72.6;跑得快靠混合专家,内存按总参数算、速度按激活参数算,30B的MoE比32B稠密模型快两倍多。三件事在2023至2025年间依次落地,叠成用户感知到的“突然好用”。同时新边界仍在:MoE不省内存、蒸馏不带来新知识、量化有硬底。
从答非所问到对答如流:本地模型经历了什么
两三年前,在笔记本上跑开源模型,问它“天空为什么是蓝的”,它会先说是“常见的争议”,然后给出两个互相矛盾的答案——一会儿是雾和云层里的微小碎片反射光色,一会儿是地球自身温度的影响,最后还补上一句“目前还没……”,第二遍才绕回“还没有一个公认的解释”。模型能启动、能对话、听得懂中文,却答不出一个基础常识题。
今天,同一台机器、断网、同一个问题,答案正常了。这中间到底发生了什么?把“好用”拆开,其实是三道关卡:装得下、会想、跑得快。这三道关卡在不同年份被卡住,也被不同的方式松开。
第一关:装得下——量化把模型塞进普通内存
模型权重原本是16位浮点数,一个数占两个字节。80亿参数的模型,光权重就是16GB,大多数笔记本腾不出这么多内存。第一步必然是压缩,办法叫量化:把每个数用更少的位数存,从16位降到8位,再降到4位。
压缩一定有代价,好在代价可以量出来。这个量叫困惑度,意思是模型对下一段文字有多“意外”,越低越好;涨得越多,模型越糊涂。据Llama CPP在同一个80亿参数模型上的记录:8位涨0.003,6位涨0.02,基本无损;4位涨0.175,文件从8GB压到4GB半;3位涨0.657,已经是4位的将近4倍;2位直接跳到3.5倍,模型基本报废。
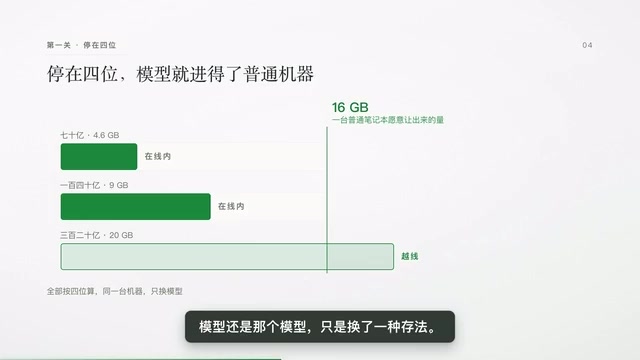
顺着位数往下走,4位是最后一级缓坡,3位开始变抖,2位就掉下去了。另一组人在数学题上验证了同一件事:16位正确率77.6,4位77.4,几乎没动;3位掉到68.3。所以4位的价值不是“更小”,而是刚好停在悬崖上边。停在4位,模型就小到能进普通机器了:70亿模型4GB多,140亿9GB,320亿要20GB——最后一条越过了普通笔记本能腾出来的16GB。能稳稳跑起来的,是70亿和140亿这一类。模型还是那个模型,只是换了一种存法。
困惑度(Perplexity) 是衡量语言模型预测能力的常用指标,定义为模型对测试文本中每个词预测概率的几何平均的倒数。直观理解:模型对下一个词的预测越“意外”,困惑度越高;预测越准,困惑度越低。它不需要人工标注,只需一段文本即可计算,因此常被用来快速对比同一模型在不同量化精度下的损失。但困惑度对量化损伤的敏感度有限——困惑度小幅上涨时,模型在简单对话中可能看不出差别,而在数学、代码等需要精确推理的任务上已明显退化。所以实践中常配合下游任务准确率(如数学题正确率)交叉验证,避免只看困惑度而低估量化代价。
第二关:会想——蒸馏把推理过程搬进小模型
装得下之后,立刻撞上第二堵墙:一个70亿的模型,就算给你完整精度,也很难分步推理。
2025年1月,DeepSeek广告把这条限制推开了一步。他们先用强化学习训了一个671B的大模型,然后让它把自己做题的过程写下来,一共80万条,用大模型的输出去教小模型——这个办法叫蒸馏。他们拿这批教材微调了6个尺寸的小模型,最小1.5B,最大70B。1.5B的蒸馏版数学竞赛得分28.9,同期的GPT-4o是9.3;但更能说明问题的是320亿那一档的对照:同一个底座直接做强化学习得分47,换成蒸馏,还是那个底座,得分72.6。尺寸一模一样,变的只是训练信号从哪里来。论文说得很直接:小模型自己摸索,不如把大模型的推理搬过来。
这就是第二关的解法:它搬的是方法,不是体积。
知识蒸馏(Knowledge Distillation) 最早由 Hinton 等人在 2015 年提出,核心思想是让一个小模型(学生)模仿一个大模型(教师)的输出分布,而不仅是硬标签。传统蒸馏传递的是“软标签”——教师对每个类别的概率分布,其中蕴含了类别间的相似性信息。在大语言模型时代,蒸馏演化出两种形态:一是输出蒸馏,学生直接拟合教师的 token 概率;二是推理链蒸馏,即文中 DeepSeek 采用的方式——教师生成完整的解题步骤(思维链),学生以这些步骤为监督信号进行微调。后者传递的不只是答案,而是“怎么一步步想到答案”的过程,因此对小模型推理能力的提升尤为显著。蒸馏的局限在于:学生只能学到教师已展现的能力,无法超越教师的知识边界。
第三关:跑得快——混合专家让参数更多反而更快
蒸馏搬能力,搬不动尺寸。320亿的模型4位也要20GB内存,想更强通常意味着更大,也就更装不下。2025年,混合专家把这个矛盾拆开了:把模型内部切成很多个专家,每个词只经过其中几个。Qwen3-30B-A3B总参数305亿,每词只激活33亿;GPT-OSS-20B总参数210亿,每词激活36亿。
关键在解码这一步:速度取决于读了多少字节。专家必须全部带在内存里,但每个词只读被选中的那几个。于是内存按总参数算,速度按激活参数算。同一台机器、同样4位,30B的混合专家每秒95个Token,稠密的Qwen3-32B每秒只有34个——参数更多,速度反而快了两倍多。第三关不是算得更快,是每次少读一点。
混合专家(Mixture of Experts, MoE) 的核心组件是“门控网络”和若干“专家网络”。对每个输入 token,门控网络计算各专家的权重,只选择得分最高的前 K 个专家参与计算(常见 K=2),其余专家不激活。这样总参数量可以做得很大,但单次前向传播的计算量和显存读取量只与激活参数相关。MoE 并非新概念,早在 1991 年就有人提出,但直到 2017 年 Shazeer 等人将稀疏门控引入大规模神经网络,才在语言模型中展现出优势。其代价是显存占用高——所有专家权重必须常驻内存,且训练时容易出现专家负载不均(少数专家被过度使用),需要额外的负载均衡损失来约束。
三件事叠在同一条时间轴上
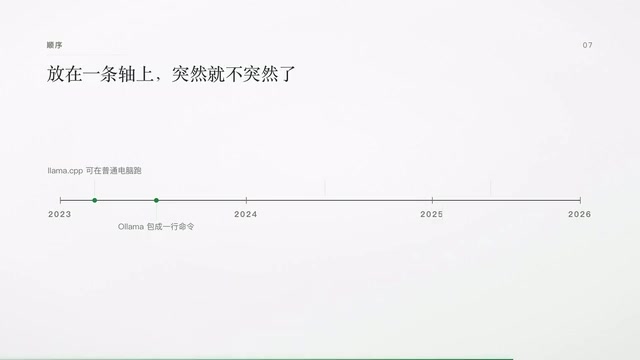
把这三件事放到同一条时间轴上,突然就不突然了:2023年3月,Llama CPP让Meta模型能在普通电脑上跑;同年7月,Ollama把它包成一行命令;再往后,4位成了各家下载工具默认给的那一档;2025年1月蒸馏小模型开源;同年4月和8月,两个混合专家模型发布。每一级台阶都很小,但它们叠在了一起。你感觉到的“某天突然好用”,是最后一级台阶赏区的时候。
松开之后,新的边界也在那里
这三关松开的地方,也留下了新的边界。混合专家省的是速度不是内存,所有专家都得在场:GPT-OSS-20B在8000上下文要14.9GB,上下文拉到13万涨到17.9GB,上下文越涨解码还越慢——同一台机器上从500个词源到32000个,速度从46掉到30。蒸馏也有天花板,它搬的是推理方式,不是新知识,论文自己说要突破能力边界仍然需要更强的基座。量化更是硬底:4位以下不是慢慢变差,是直接断掉。
所以本地模型不是突然变聪明了,是装得下、会想、跑得快这三道关被依次让开。你觉得理所当然的那次对话,背后是三年里三件不同的事。下一次它再变好用,大概率还是这个套路:某个具体的约束被松开了。
上下文长度与显存的关系 值得单独说明。Transformer 的注意力机制在解码时需要缓存每个已生成 token 的 Key 和 Value 向量(即 KV Cache),其大小随上下文长度线性增长。对于稠密模型,KV Cache 与模型权重相比通常很小;但对混合专家模型,权重已经占满内存余量,KV Cache 的增长就成为压垮骆驼的最后一根稻草。这就是为什么 GPT-OSS-20B 在 8000 上下文时占 14.9GB,拉到 13 万上下文时涨到 17.9GB——多出来的约 3GB 几乎全是 KV Cache。此外,上下文越长,注意力计算越重,解码速度也会下降。这解释了文中“上下文越涨解码还越慢”的现象,也说明长上下文能力在本地部署中受限于内存而非算力。
相关推荐

Aircad:浏览器里的专业制图与3D建模新选择
Aircad在Hacker News展示浏览器端专业制图与3D建模能力,探索无需安装的CAD工作流。本文分析其定位、潜在优势与早期项目的不确定性。

AI做新闻,受众为何不买账?
AI正成为信息入口,但受众仍抵触AI生产新闻。本文分析信任赤字根源、信息入口与内容生产的边界,以及对媒体机构AI化的现实启示。

律所如何用AI重塑法律业务?Gilbert + Tobin的实践
澳大利亚律所Gilbert + Tobin合伙人兼CEO Sam Nickless谈律所如何用AI重新思考法律业务模式,从效率工具走向业务逻辑重构,以及CEO层级介入AI战略的意义。