本地模型别乱下:用llmfit先筛后测的完整流程
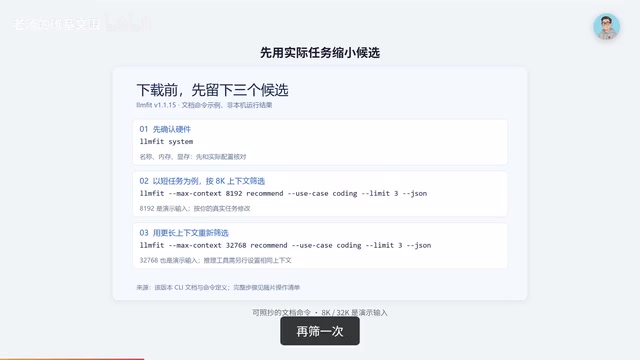
llmfit 是一款本地大模型选型工具,帮助用户在下载前通过硬件识别、量化对比和候选筛选找到最合适的模型配置。
llmfit(视频中称 LMF8)解决的核心问题是:本地大模型种类繁多,盲目下载后往往因量化方式、上下文长度或硬件适配不当而卡顿。工具的逻辑是先正确识别硬件(显存、内存),再按用户实际任务的上下文长度和用途筛出三个候选,同时把量化、上下文占用和运行方式(全显卡/部分卸载/纯 CPU)放在同一张表里对比估算。它还支持「反向规划」——固定想跑的模型,反查硬件还差多少。速度估算经历了社区质疑后已引入本机实测和社区数据,但仍需区分数字来源是实测还是公式推算。工具的最终价值在于缩短盲选成本,但合不合用还需用真实任务对候选模型做同条件对比测试才能确定。
本地大模型的数量越来越多,跟着榜单一股脑下载,文件是塞进硬盘了,可一接入项目代码就开始卡。问题往往不只在参数量的大小,还牵扯到量化方式、上下文长度和运行方式。这期要讲的 llmfit(视频中简称 LMF8,下同)就是把「盲选」变成「先筛三个候选,再用自己的任务定下来」的工具。
作者最早在 Hacker News 上坦白,做这个工具的动机是给自己买更强的笔记本「找个理由」——先搞清楚硬件到底缺什么,再决定要不要花钱。这个出发点很务实,也决定了工具的定位:它给的是规划依据,不是最终答案。本文按 1.1.15 版本来讲。
先做硬件识别,再谈模型推荐
LMF8 的核心逻辑是把模型、量化和运行方式放在同一张表里估算,而这一切都建立在正确读取硬件的基础上。
安装方式因系统而异:Windows 若已装 Scoop,直接执行界面上的安装命令,否则去官方 Release 下载对应架构的压缩包解压运行;Mac 和 Linux 可以用官方 Homebrew 配方。启动后进入终端界面,这个阶段只做硬件选型,还不需要为了看推荐而下载大模型。
打开后第一件事不是追最高分,而是核对最上方的硬件信息:显卡名称、显存、系统内存,是否与你的实际配置一致。作者特别提醒,如果机器明明有独显、界面却只认到处理器,这种情况换模型解决不了问题——先用 System 看识别结果,有异常再用 Doctor 找原因。后面所有推荐都建立在这一步之上,识别错了,后面的数字都不可信。
按真实任务分段筛选候选
假设你想让本地模型帮忙改一个函数,可以先按 8000 左右的上下文做一轮筛选,用途限定为写代码,只留三个候选。如果接下来要塞更长的项目材料,就把参数改成 32768 再筛一次。
作者强调,这两个数字只是演示输入,你要按真实任务来选,别拿短任务的推荐直接套长任务。同一个模型换一种量化,占用也会变——量化可以理解成把权重存得更紧凑,通常能省空间,但回答质量可能受影响。上下文同样要占内存,只算模型文件大小,「就像租房只亮床,不给人留过道」。所以对照候选时,要把量化、实际参与估算的上下文、以及模型是全放显卡还是要让处理器分担,一起看。
综合分意味着什么
单表里的综合分把质量、速度、内存适配和上下文这些维度合在一起。写代码和聊天测重点不同,所以第一名的意思是「按这套规则值得先试」,而不能理解成它已经做对了你的项目。实用的判断标准是:先排除明显不合适的,再把留下来的模型带到真实任务里。这也是 LMF8 比一张显存对照表更有价值的地方。
量化(Quantization)是将模型权重从高精度浮点数(如 FP16、BF16)压缩为低位整数(如 Q4、Q8)的技术。以常见的 GGUF 格式为例,Q4_K_M 表示用 4 位整数存储权重,Q8_0 则用 8 位——位数越低,文件越小、运行越快,但数值精度损失越大,回答质量可能下降。一个 70B 参数的模型,FP16 格式约需 140GB 显存,而 Q4 量化后可压缩至 40GB 左右。选择量化级别时没有固定答案:对代码补全等对准确性要求高的任务,Q5 或 Q8 通常更可靠;对摘要、闲聊等容错率高的任务,Q4 往往是性价比最高的起点。
反向规划:硬件到底差多少
问题可以反过来问——「我就想跑这个模型,在指定上下文和量化下,硬件还差多少?」
选中模型按小写 P 进入规划,大写 S 则能临时模拟不同内存容量。注意,改大容量只是改了假设,并没有让原来的电脑变快。比如某个候选装得太勉强,可以先固定模型,再检查能不能缩短上下文或换一个更省空间的量化,然后看规划里「全显卡 / 部分卸载 / 只用处理器」各自是什么条件。
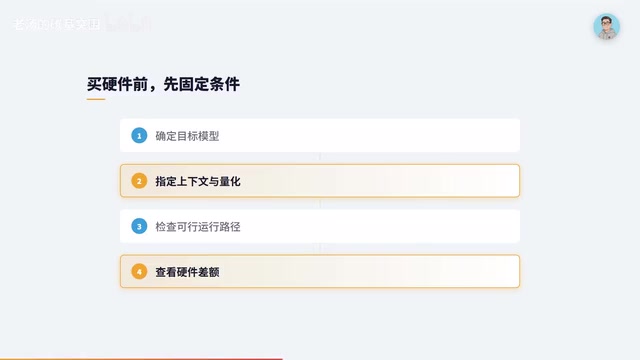
这样你就能回答:为了这个任务,是调整配置就行,还是确实需要更多硬件。它提供的是买机器前的规划依据,真正下单前还要核对目标硬件的真实测试。
速度估算的争议与澄清
关于速度,早期确实有争议。3 月的 Reddit 用户一边喜欢它把信息集中起来,一边觉得速度估算太乐观。7 月作者在 1.0 公告里回应:估算不够准,「你们说的对」,现在的版本已经加入本地测试和社区数据,所以不能再沿用「它完全不做实测」的旧说法。
关键变成了:你眼前这个数字究竟从哪来?选中候选、带上相同上下文参数,用 info 查看详细分析,重点找估算依据和验证方法。速度数字大体分三种来源:自己这台机器测过的、别人相近条件下测过的、纯公式估出来的。校准过的公式仍然是估算。看到一个漂亮的速度,先问一句:模型、量化、硬件和运行条件对得上吗?对不上,就别当自己的保底成绩。
评估本地模型速度时常见的两个指标是「首字延迟」(Time to First Token,TTFT)和「生成速度」(tokens/s)。前者指从发出请求到收到第一个输出字符的等待时间,主要受 prompt 处理速度影响;后者指后续连续生成的吞吐速率。两者都重要:首字延迟决定交互感是否流畅,生成速度决定长回复要等多久。通常显卡全量加载时生成速度最快;若模型部分卸载至内存甚至完全由 CPU 运行,生成速度会显著下降,首字延迟也会拉长。纯公式估算往往只考虑显存带宽的理论上限,而忽略量化解码开销、上下文长度对注意力计算的影响,因此乐观偏差较为常见。
下载与实测:结果得自己跑
留下候选后才进入下载。选中模型按小写 D,有多个可用工具时会出现下载方式选择框。已经在用 Ollama 就让它继续管理模型,用其他支持的运行工具则按实际可用项选。
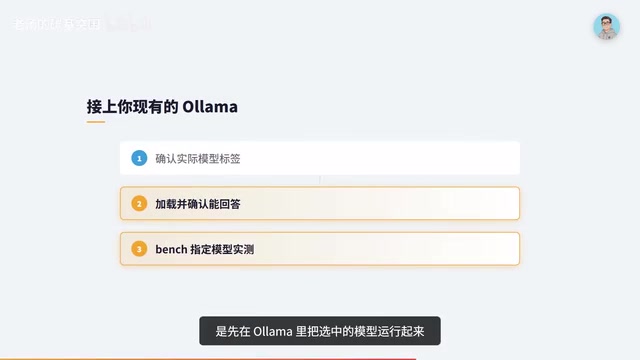
这里有个容易踩的坑:LMF8 的推荐表并不等于模型已经就绪。最稳妥的路线是先在 Ollama 里把选中的模型运行起来、确认能回答,再回到 LMF8 测。不要把模型目录里的名称原封不动当成 Ollama 名称,要以运行工具实际列出的名字为准——我们要比的是同一个模型的同一种配置,否则换了量化再比速度,很容易得出错误结论。
在终端界面刷新以更新安装状态,选中运行中的模型按小写 B 就能按提示启动测试。官方示例会进行三轮推理,测生成速度和首字等待时间。测完后结果保存在本地,也能反过来帮助后续推荐。
最后这一关得你来定:拿同一段真实代码,让两个候选修同一个问题,上下文、量化和运行设置都记下来,既看等待多久,也看修改能不能通过检查。一个吐字更快却反复改错的模型,未必更省时间。判断好不好用,应该看这项任务多久能做对,而不只是每秒吐多少字。
Ollama 是目前最常用的本地大模型管理工具之一,负责模型的下载、版本管理和通过标准化 API 将模型提供给上层应用。它使用自己的模型命名规范(如 llama3:8b-instruct-q4_K_M),与 Hugging Face 或 GGUF 文件名并不直接对应。同一个基础模型在 Ollama 库中可能存在多个量化变体,名称末尾的标签标识了量化级别和变体类型。在 llmfit 里看到的候选名称来自模型元数据,实际用 Ollama 拉取时需要在其模型库中确认完整标签,直接复制可能找不到对应项或拉取到不同量化版本,导致对比测试的条件不一致。
已经在用 LM Studio 还需要它吗
先承认一个事实:LM Studio 自己就有加载前的内存预估(estimate only 命令)。如果你已经选定模型,只想确认这一个配置能不能加载,原工具可能就够了。
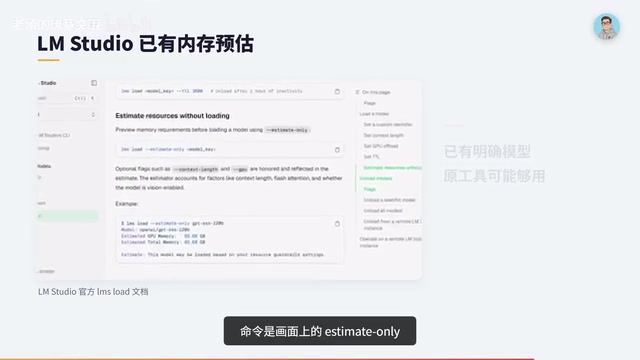
LMF8 更值得装的场景是:你还没确定候选,需要把模型、量化和硬件方案一起筛一遍。Ollama 主要负责下载、加载和把模型提供给应用,LMF8 可以放在它前面做选择、再接回来测。
还有两个实际细节:前面设置的上下文只是估算条件,运行工具里也要另行设成一致;国内用户虽然能看中文说明,但安装包和模型下载仍取决于访问 GitHub、Hugging Face 等站点的情况。识别错了、下载失败了,先解决原因,再相信后面的结果。
一句话总结:经常换本地模型、想少下几个大文件的人值得装它来筛选;已经有稳定模型的人可以按需跳过。它像试衣前的尺码表,能减少拿错款,但合不合身,还得穿上试一下。
相关推荐
一个月为M4 Mac Mini开发Linux GPU驱动的技术挑战
开发者Cody Ho用一个月时间为M4 Mac Mini构建Linux GPU驱动,本文解析Apple Silicon GPU逆向工程的核心难点、开源社区协作价值及其对Linux硬件生态的意义。
SEO Page Builder Enhanced:让AI生成的SEO内容摆脱套路味
开发者基于octelens原版seo-page-builder打造的增强版开源工具,通过引入编辑审校、一手经验、事实与时效校验及写作风格护栏,专门解决AI生成SEO内容套路化、缺乏原创洞见的问题。
分层RAG架构研究求助:独立开发者如何叩开学术研究之门
一位独立开发者在Reddit求助信息检索领域教授,指导其分层RAG架构研究。本文剖析异构文档检索的技术背景,探讨独立AI研究者面临的学术门槛困境,并给出公开成果、社区协作等实用建议。