本地小模型撑起百万Token上下文,Spark X如何做到?

Spark X 2.5用稀疏注意力架构撑起百万Token上下文,但真正跑满需43GB内存,实测128K以内才稳定。
Spark X 2.5是一个约40亿参数的开源模型,通过稀疏注意力架构实现了官方宣称的百万Token上下文窗口。其36层中仅9层为全文做笔记,其余27层只关注最近512个Token,这使KV Cache内存消耗降至全层追踪方案的约四分之一。然而"能装下"并不等于"能用上":满载百万Token时KV Cache约39GB,加模型文件共约43GB,普通32GB整机根本无法承载,而官方部署脚本默认就把窗口拉满到这个值,下载页对此毫无提示。社区非证实测试显示模型在128K Token以内召回稳定,超过后准确率下降。实用建议是:日常任务用32K,代码库分析用128K(16GB机器可跑),百万级上下文留给32GB以上工作站,且需自行验证。
一个只有约40亿参数、能跑在普通电脑上的开源模型,官方却宣称原生支持约100万Token的上下文窗口。这听起来违反直觉——参数如此有限的模型,凭什么记住如此长的文本?B站UP主对Spark X 2.5(4B)的架构拆解给出了答案,也揭示了这个数字背后的真实代价。
三分之二的层只有"金鱼记忆"
Spark X 2.5的核心设计在于它并不让每一层都去追踪全文。模型共有36层,被切分成重复的"4层一组"结构。每组里有三个滑动窗口层,只关注最近的512个Token;剩下的第四层才是全局层,真正读取整篇文本。
这意味着36层中只有9层在为全文做笔记,其余27层(约四分之三)转眼就忘了几段之前的内容。UP主用了一个形象的比喻:这就像运营一间办公室,四分之三的员工只有金鱼记忆,只处理眼前这句话的局部语法和短语;而全局层则能一路回溯到代码库顶部定义的变量。
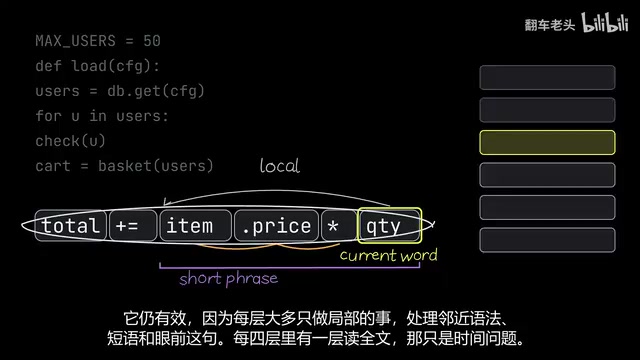
这个设计之所以仍然有效,关键在于全局层每隔几层就会把检索到的全文信息向上传递。局部层负责处理临近的语法与短语,全局层负责"读全文",两者分工协作,让模型在大部分层只做局部计算的情况下,依然保留了追溯长距离信息的能力。
这种"局部层+全局层"交错排列的设计,在学术上属于**稀疏注意力(Sparse Attention)**架构的一种变体。传统Transformer的自注意力机制要求每个Token与序列中所有其他Token计算相关性,计算量和内存消耗随序列长度呈平方级增长(O(n²))。当序列长度达到百万Token时,这个代价在工程上几乎不可接受。稀疏注意力的核心思路是:并非所有Token之间的交互都对最终输出同等重要,因此可以只保留"有价值的"注意力连接。滑动窗口注意力(Sliding Window Attention)是其中最直接的实现——每个Token只与相邻的固定数量Token交互,计算复杂度降为O(n×w),其中w是窗口大小。Longformer、BigBird等模型都采用了类似的混合策略:大多数层做局部注意力,少数层做全局注意力,以较低代价保留对长距离依赖的感知能力。Spark X 2.5本质上是这一思路在小参数量模型上的工程落地。
KV Cache:真正吃内存的账单
理解Spark X的内存开销,需要拆成两笔账。第一笔是模型文件本身的固定开销:常见的8-bit版本约4GB,全精度约8GB。哪怕你只让它写三个字的购物清单,这笔钱也得先付——把权重装进内存是启动的前提。
第二笔开销才是真正随上下文长度膨胀的部分,工程师称之为KV Cache(键与值的缓存)。在普通模型里,每一层都要为每个Token写一条笔记,Token越多,内存占用就像黑色星期五的停车场一样爆满。
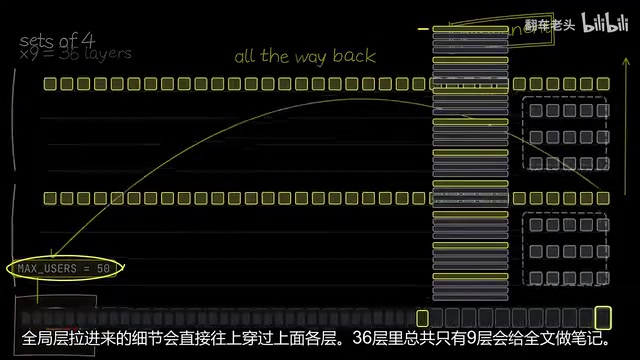
Spark X打破了这个模式。三个滑动窗口层存满512条笔记后内存就不再增长,旧笔记直接丢弃;只有9个全局层为每个Token保留永久笔记。按公开设计,每个全局层每Token约存4KB,9层加起来每个Token进入提示词就多出约37KB。这样一来,KV Cache占用的内存仅为"每层都记全文"方案的四分之一左右。
据UP主引用的公开设计数据,若36层全部追踪全文,追踪100万Token的开销会飙升到约155GB;而Spark X的稀疏设计把这个数字压到约39GB。
KV Cache的全称是Key-Value Cache,是Transformer推理阶段的核心优化机制。在自注意力计算中,每个Token会生成三个向量:Query(查询)、Key(键)和Value(值)。生成文本时,模型是逐Token自回归地输出的,如果每次生成新Token都重新计算所有历史Token的Key和Value,计算量将随序列长度线性增长。KV Cache的做法是把已计算过的Key和Value向量缓存在内存中,下次直接复用,以空间换时间。代价是内存占用与序列长度严格正比:序列越长,缓存的Key-Value对越多,内存压力越大。缓存大小取决于层数、注意力头数、每个头的维度以及序列长度四个因素的乘积。这正是Spark X稀疏设计的价值所在——通过大幅减少需要维护完整KV Cache的层数,将内存压力从与层数成正比变为只与全局层数(9层)成正比。
百万Token的真实内存账
光有巧妙的架构还不够,实际能否跑起来取决于你的硬件。UP主给出了几档具体测算:
- 32,000 Token:KV Cache约1.3GB,加上4GB模型文件,总占用约9GB,16GB内存的普通笔记本轻松带得动。
- 128,000 Token:KV Cache涨到约4.9GB,加模型文件总占用约9GB,仍在16GB机器的舒适区。
- 1,000,000 Token:光KV Cache就要约39GB,加模型文件约43GB,操作系统还没开始运行就已经超出32GB整机的容量了。
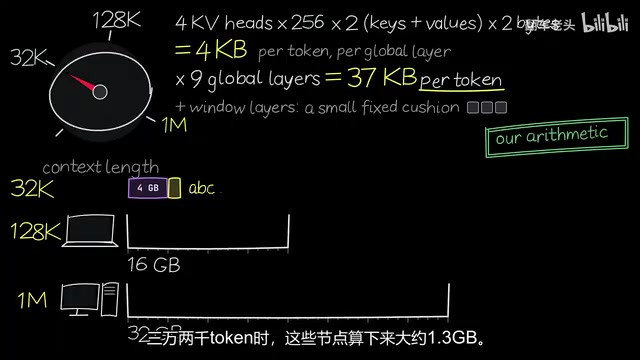
值得警惕的是,官方SGLang部署脚本在启动时会直接把上下文窗口拉满到100万Token。也就是说,下载页面上那个诱人的"百万Token"标签,根本不会提前告诉你运行时等着的这笔巨额内存账单。
能装下不等于能用上
上下文窗口只是模型能"吞下"的文本上限,并不代表它真能用上全部内容。机器学习领域检验这一点的标准方法是"大海捞针"测试——把一个具体事实藏进海量无关文本中,看模型能否准确捞出来。
据UP主引用,当Orca Router在评测中对比Spark与Gemma 4(12B)时指出:其宣传的百万Token只是架构声明和发布设置,并非经证实的日常能力,当时还没有人发布过覆盖全场景、经独立验证的大海捞针测试结果。
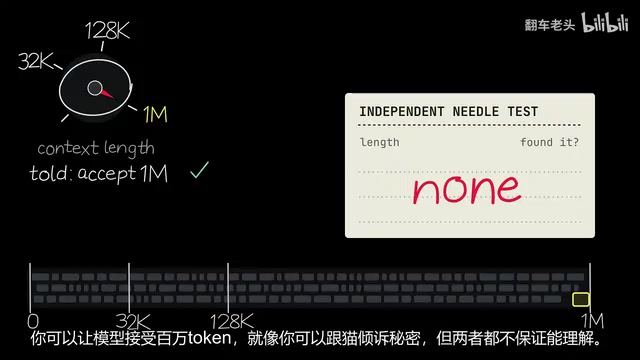
来自本地LLaMA论坛的社区测试更接地气:有测试者跑了不同长度的基准,报告模型在约128,000 Token以内表现稳定,一旦超过这个长度就开始"找不到针"了。测试者推测模型可能主要就是按这个较短长度训练的。UP主也提醒,这只是一份非证实报告,并非完整的实验室测试,确切原因尚未被证实。
结论很务实:128,000 Token以内是有实测依据的可用区间,超过这个数就只是没经验证的设计上限,得拿你自己的文档试过才算数。
"大海捞针"测试(Needle-in-a-Haystack,NIAH)是目前评估长上下文模型实际检索能力最主流的基准方法,由Greg Kamradt于2023年提出并被社区广泛采用。测试方法是将一段简短的目标事实("针")插入大量无关文本("草堆")的不同位置,然后提问让模型找出这个事实。通过系统地改变草堆长度(即上下文窗口的填充程度)和针的插入位置(文本开头、中间还是结尾),可以绘制出一张二维热力图,直观显示模型在不同长度和不同位置的检索准确率。一个模型宣称支持百万Token的上下文窗口,与它真的能在百万Token中可靠地找到一个关键细节,是两件完全不同的事。前者是架构设计的理论上限,后者需要经过覆盖全场景的NIAH测试才能证实。很多模型存在"位置偏差"问题——对开头和结尾的内容召回率远高于中间位置,这在热力图上会呈现为中间区域的"暗区"。
该给你的电脑设多大窗口
根据硬件条件,UP主给出了清晰的选型建议:
- 日常聊天与单文件处理:从32,000 Token起步,KV Cache仅约1.3GB,加上4GB的8-bit模型,普通笔记本内存就放得下。
- 一次分析大段代码库:设128,000 Token,16GB机器就能跑,且正好落在实测召回率仍稳的区间。
- 百万级上下文:留给32GB以上的工作站,且在喂入整个库之前,最好先自己藏个事实测测它能不能找到。
无论你选用Ollama、LM Studio还是llama.cpp作为运行时,在把整个代码库喂进去之前,先确认已装好对Spark 2.5的支持。这个模型用巧妙的稀疏注意力架构证明了小模型也能撑起超长上下文的"骨架",但真正决定实用性的,还是你手里的内存和亲自跑过的验证测试。
相关推荐

气态巨行星上的浮空城市:为什么人类终将移居木星云端
SFIA 主持人 Isaac Arthur 重新定义气态巨行星浮空城市:它们不是等待聚变的燃料站,而是散装氢、氦、氮的"质量城市"。本文解析其工程原理、供电方案与从工业前哨到文明家园的演化逻辑。

用Claude Code一天半做出AI测验:Vibe Coding的真实样本
一位开发者用Claude Code结合Opus 5.5与Fable 5.1,在一天半内做出一款PS1复古风格的AI主题测验游戏。本文解析这个业余项目背后的AI辅助编程实践与行业启示。

用Claude+Muse打造自动化膳食规划:AI如何替代HelloFresh
一位不懂编程的Reddit用户用Claude和Muse搭建了自动化膳食规划系统,涵盖菜单规划、沃尔玛自动下单、厨房平板界面,号称HelloFresh杀手。本文解析其工作流与AI生活自动化的启示。