本地运行AI模型全指南:推理引擎与工具栈解析
本地AI工具大多只是llama.cpp或vLLM的外壳,选型应先看场景再选引擎。
文章把本地运行大模型的工具栈拆为三层:计算库(PyTorch、GGML、MLX、TensorRT)、推理引擎(llama.cpp、vLLM、SGLang、TensorRT-LLM 等)和封装层(Ollama、LM Studio、Open WebUI 等),指出琳琅满目的工具大多只是少数几个引擎的外壳。作者在 8GB VRAM 的 RTX 3060 Ti 上用同一 OpenAI 兼容脚本做对照实验:100 个并行请求下 llama.cpp 耗时 9.2 秒、vLLM 仅 1.6 秒、TensorRT-LLM 约 3.6 至 3.8 秒并未跑赢 vLLM,说明编译优化收益高度依赖具体场景。显存策略上,llama.cpp 按需分配、vLLM 预分配比例,混合量化可把 14B 模型塞进 8GB 显存。结论是选型应先确定单机还是多用户、灵活还是性能、显存是否受限,再选底层引擎,最后才考虑封装层。
大多数本地 AI 工具其实都是同一批推理引擎和计算库的封装。理解这个底层生态,比记住每个工具的命令行更重要。
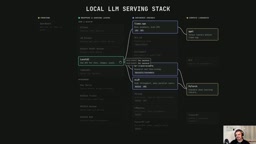
一位 YouTube 技术博主用一张生态图谱和一系列实操演示,把本地运行大语言模型的工具栈拆成了三层:计算库、推理引擎、封装与服务层。核心结论很明确——你看到的琳琅满目的工具,大多只是 llama.cpp 或 vLLM 的外壳。
三层架构:计算库、推理引擎与封装层
计算库:背后的数学重活
最底层负责张量运算和 CUDA 内核。PyTorch 是 Python 深度学习框架,支撑了生态中的大部分工具;GGML 是它的 C/C++ 对应物,由 llama.cpp 作者打造,专门为 llama.cpp 优化;MLX 是苹果 Silicon 专有方案;TensorRT 则是 NVIDIA 的优化编译器,把模型编译成针对特定硬件、特定模型、特定设置的操作图,用灵活性换性能。
这个层面的意义在于:用 vLLM 就在用 PyTorch,用 llama.cpp 就在用 GGML。理解这层,才能明白为什么不同工具的硬件适配和性能表现差异如此之大。
KV Cache 是推理引擎中影响显存占用的关键机制。大模型生成文本时采用自回归方式,每生成一个新 token 都要重新计算此前所有 token 的注意力,计算量随上下文长度平方增长。KV Cache 把每一层已计算过的 Key 和 Value 张量缓存下来,后续 token 直接复用,从而把每步计算量降到线性。代价是显存占用随上下文长度和并发请求数线性上升——这正是 vLLM 预分配 --gpu-memory-utilization 比例时要纳入计算的部分,也是 llama.cpp 按需分配策略更省内存的原因。PagedAttention(vLLM 的核心技术)通过分页管理 KV Cache,减少显存碎片,是其高吞吐的关键。
推理引擎:各有取舍
推理引擎建立在计算库之上,负责加载、服务和推理。作者对每个引擎给出了一句话定位:
- llama.cpp:适合单人在家用 CPU 或 GPU 跑单个模型,是本地 AI 普及初期最早被广泛使用的工具。
- vLLM:面向 GPU、并行和高吞吐场景,多个用户同时请求时的首选,不支持开箱即用的 CPU。
- SGLang:与 vLLM 同级别,但针对重复上下文(多轮对话、Agent、结构化输出)做了优化,在重复提示场景下可能反超 vLLM。
- Hugging Face Transformers:更适合微调、研究和快速实验,服务能力只是附带的。
- LM Deploy:主打 4-bit 量化模型的性能优化,由 InternLM 团队打造,配合自家模型使用更顺。
- TensorRT-LLM:NVIDIA 生态专属,数据中心场景的常客。
- MLX-LM:苹果 Silicon 专有,作者因没有苹果硬件未做演示。
量化 是让大模型在有限显存上运行的核心手段。它把模型权重从 FP16(16 位浮点)压缩到 8 位、4 位甚至更低,显存占用可降到原来的 1/4 至 1/8。常见格式包括 GGUF(llama.cpp 生态)、AWQ 和 GPTQ(GPU 推理常用)。量化会带来精度损失,但 4-bit 在多数对话任务上几乎无感。文中 LM Deploy 主打 4-bit 量化性能优化、xLama v3 用“不同层不同比特率”的混合量化把 14B 模型塞进 8GB VRAM,都是这一思路的延伸:对注意力层和前馈层采用不同精度,在显存和效果之间做更细的权衡。
封装层:便利性大于能力
Ollama、LM Studio、Open WebUI、Docker Model Runner、LocalAI、TabbyAPI 都属于这一层。它们不改变底层能力,只是让调用更顺手:Ollama 让拉取和运行模型变得极简;LM Studio 提供漂亮的 GUI 和极方便的模型搜索;Open WebUI 在 Ollama 之上再套一层类 ChatGPT 界面;Docker Model Runner 让模型能直接写进 Compose 文件;LocalAI 用一套 OpenAI 兼容 API 统一文本、图像等多种模态;TabbyAPI 则是 xLama v3 的标准服务层。
实测:同一脚本,不同引擎
作者在 8GB VRAM 的 RTX 3060 Ti 上跑了一组对照实验。所有引擎都暴露 OpenAI 兼容接口,推理脚本几乎只需改端口和模型名。
并行请求测试最能拉开差距:100 个请求同时发出,llama.cpp 耗时 9.2 秒;vLLM 仅 1.6 秒;Ollama 即便开启 num_parallel=16 也依然很慢;Hugging Face Transformers 的并行表现“完全不行”;TensorRT-LLM 约 3.6 到 3.8 秒,反而慢于 vLLM。SGLang 在结构化输出任务上表现很快,但作者也指出,多数场景下 vLLM 的生态更广,除非实测确认 SGLang 更快且这个性能对你重要。
显存策略的差异
llama.cpp 按需分配 VRAM,vLLM 则预先占用指定比例(通过 --gpu-memory-utilization 配置),KV cache 和模型本身都算在内。作者提醒,在有 128GB 共享内存的设备上跑小模型时不要设置过高比例。xLama v3 + TabbyAPI 的组合则展示了另一种思路:用不同层不同比特率的量化,把 14B 模型塞进 8GB VRAM,实测 VRAM 几乎吃满。
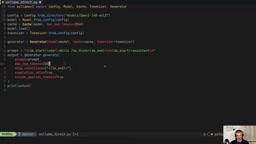
OpenAI 兼容 API 是这些工具能够“只改端口和模型名”就互相替换的前提。它指各推理引擎对外暴露与 OpenAI /v1/chat/completions 等接口一致的 HTTP 端点,请求和响应采用相同的 JSON 结构。这样上层的客户端、Agent 框架、IDE 插件无需感知后端是 llama.cpp、vLLM 还是 Ollama,只要改 base URL 即可切换。这也是封装层能存在的基础——Ollama、LocalAI、TabbyAPI 本质上都在做协议适配,把各自的引擎包装成统一的 OpenAI 接口,从而让生态中的工具可以自由组合。
怎么选:按场景对号入座
家用单模型、想省事,llama.cpp 或 Ollama;想要图形界面和模型搜索,LM Studio;想零门槛上手,Open WebUI;已有 Docker Compose 工作流,Docker Model Runner;需要多模态统一 API,LocalAI;GPU 多用户高吞吐,vLLM;重复上下文和 Agent 工作流,SGLang;量化模型且显存紧张,LM Deploy;NVIDIA 数据中心,TensorRT-LLM;大模型塞小显存,xLama v3 + TabbyAPI。
数据中心的编排工具(Ray Serve、NVIDIA Triton、Dynamo、NIM)作者只做了概念性介绍,未展开演示,因为重点在消费级体验。
编辑观点
这篇内容的价值不在于罗列工具,而在于揭示了“封装层之下只有少数几个真正的引擎”这一事实。对开发者而言,这意味着选型时应该问的是“我的场景是单机还是多用户、是灵活性优先还是性能优先、显存是否受限”,而不是追逐新出现的封装工具。一旦底层引擎确定,上层换哪个壳都只是便利性问题。
一个值得注意的细节是 TensorRT-LLM 在作者的并行测试中并未跑赢 vLLM,这说明编译优化的收益高度依赖具体模型、设置和批次形态,不能想当然地认为“编译一定更快”。同样,Ollama 的并行能力弱是设计取向决定的,把它当高并发服务用是选错了工具。
相关推荐

零基础用WorkBuddy做AI漫剧:技能包保姆级安装教程
零基础如何用WorkBuddy制作AI漫剧?本文详解WorkBuddy安装、Skill技能包导入与调用全流程,附剧本生成实操演示与人工修改技巧,帮你跑通AI漫剧从剧本到分镜的第一步。

WorkBuddy智能体一句话跑通GEO数据库挖掘全流程
WorkBuddy智能体实现GEO数据库挖掘全自动化:从数据搜索、下载整理到批次校正、差异分析、共表达网络、特征基因筛选及免疫浸润分析,一句话提示词即可生成完整生信分析报告,大幅降低生信分析门槛。

PC内存被浪费?Hacker News热议集中式数据中心之争
Hacker News用户提出个人电脑内存被浪费、应集中到数据中心的观点,引发关于集中式与分布式计算资源分配的讨论。本文分析该观点背后的逻辑、集中化的代价,以及AI时代内存资源分配的新张力。