笔记本跑Qwen 3.8读原始权重:46分钟一个答案

研究者让大模型直接读取自身17GB权重文件,耗时46分钟但仅适合可解释性探索。
本文介绍了“权重空间编程”这一激进的可解释性思路:让语言模型直接读取神经网络的原始权重文件作为输入。Simon Willison用Qwen 3.8 27B在个人笔记本上复现了该实验,模型文件约17GB,单次回答耗时46分钟、消耗43,506个推理token。Pong测试运行超过一小时,Freeway任务则直接失败。文章指出,该方法对任务类型高度敏感,工程成本极高,目前仅适合小规模的可解释性研究,不具备交互式使用价值。原内容标注为“首次观察”,结论仍处早期阶段,需要更多独立复现来验证稳定性和适用范围。
当模型直接“阅读”自己的权重
大模型的可解释性研究通常依赖探针、注意力可视化或激活修补,这些方法都在模型的外部表征层面做文章。但一篇关于“权重空间编程”(weight space programming)的论文提出了一个更激进的思路:让语言模型直接读取神经网络的原始权重文件,把权重当作输入文本来处理。据Simon Willison在其博客中的记录,他用Qwen 3.8 27B(原文写作QEN 3.8 27b)在个人笔记本上复现了这一实验——模型文件约17GB,而一次回答消耗了46分钟和43,506个推理token。这个数字本身已经说明了问题的一体两面:思路足够新奇,代价也足够真实。
权重空间编程(Weight Space Programming) 的核心思想是绕过传统的“输入文本-输出文本”接口,将神经网络的参数矩阵直接序列化为数值 token 序列,作为语言模型的上下文输入。这与主流可解释性方法(探针、注意力可视化、激活修补)的根本区别在于:后者在模型的激活空间或表征层做分析,而前者试图让模型在权重数值层面建立内部映射。其理论动机源于“模型能否理解自身”的自指问题——如果语言模型能处理任意数值序列,那么权重文件作为一种特殊的数值序列,原则上也可以被处理。但挑战在于,权重数值的分布与自然语言 token 的分布差异巨大,模型需要消耗大量推理 token 来“解析”这些数值模式,这正是 43,506 个推理 token 消耗的来源。
实验细节:17GB权重与46分钟的推理
Willison的实验设置并不复杂:把约17GB的模型权重文件喂给同一个模型,让它基于这些原始数值回答问题。单次推理耗时46分钟,生成了超过四万个推理token。这个量级的推理成本意味着它无法用于任何交互式场景,但在研究语境下,长推理链本身可能包含有价值的信息——模型如何逐步消化权重中的数值模式,这个过程值得观察。
需要说明的是,这是一次初步的复现尝试,而非对原论文的完整验证。Willison本人也将此定位为一次“首次观察”。
推理 token(Reasoning Token) 在此语境下指模型在生成最终回答前产生的中间思考步骤所对应的 token。现代大模型(如 Qwen 系列)支持“思维链”式推理,会在输出答案前生成大量内部推导文本。43,506 个推理 token 意味着模型花费了数万步来逐步消化权重文件中的数值模式,而非直接给出答案。这种长推理链的代价是推理时间线性增长——在消费级笔记本上,每个 token 的生成都需要完整的模型前向计算,46 分钟的总耗时与此直接相关。值得注意的是,长推理链本身可能包含有价值的中间表征信息,研究者可以观察模型如何逐步“理解”权重数值,这构成了该方法在可解释性研究中的独特价值。
实际表现的局限
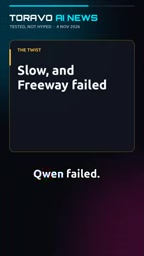
并非所有任务都能顺利跑通。在Pong相关的测试中,运行时间超过了一小时;而在Freeway任务上,Qwen直接失败了。这两个案例暴露了当前方法的脆弱性:权重空间编程对任务类型高度敏感,模型在读取原始权重后能否正确理解并执行任务,存在明显的不确定性。
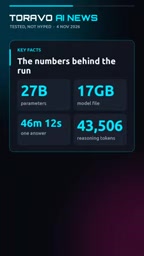
从工程角度看,17GB的输入规模本身就逼近了上下文处理的边界,推理时间以小时计也意味着任何迭代调试都极其昂贵。这决定了它目前只适合小规模、探索性的研究,而不是通用能力。
上下文窗口(Context Window) 是限制该方法工程可行性的关键因素。17GB 的权重文件序列化为文本后,token 数量远超当前主流模型的上下文窗口上限(通常为 128K 到 1M token)。这意味着模型无法一次性“看到”完整权重,只能通过分段处理或滑动窗口机制来消化,而分段之间的信息整合本身就是一个未解决的难题。此外,权重数值的精度(如 FP16 或 BF16)在序列化为文本时会引入表示开销,进一步膨胀输入规模。Pong 测试超过一小时、Freeway 任务失败,很可能与模型在超长上下文中丢失关键数值模式有关——当输入逼近或超出上下文边界时,模型对早期数值的注意力会显著衰减,导致任务理解失败。
适合谁:可解释性研究者的窄门
如果你从事的是模型内部机制的可解释性研究,这个方法提供了一个不同于传统探针手段的视角——不是从外部观察激活,而是让模型自己处理权重数值。这种“自省”式的路径可能揭示一些外部方法难以捕捉的模式。但如果你只是想找一个高效的推理方案,这个方向目前完全不适用。
你可能没注意到,原视频内容明确标注了“我们尚未测试”以及“这是对一篇博客文章的首次观察”,这意味着相关结论仍处于早期阶段,后续需要更多独立复现来确认方法的稳定性和适用范围。
结论:研究者的一瞥,不是产品
综合来看,这次实验的价值在于验证了一个概念上的可能性:消费级硬件上的本地模型确实可以处理自身的原始权重。但46分钟的单次回答、超过一小时的Pong测试、以及Freeway上的失败,共同划定了当前的边界。
对于关注模型内部机制的研究者,这条路线值得跟进;对于普通开发者,它暂时只是一个有趣但昂贵的思想实验。评价可以概括为一句:经过测试,而非炒作。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。