编译式AI Agent架构:为何放弃运行时决策而选择固定流水线
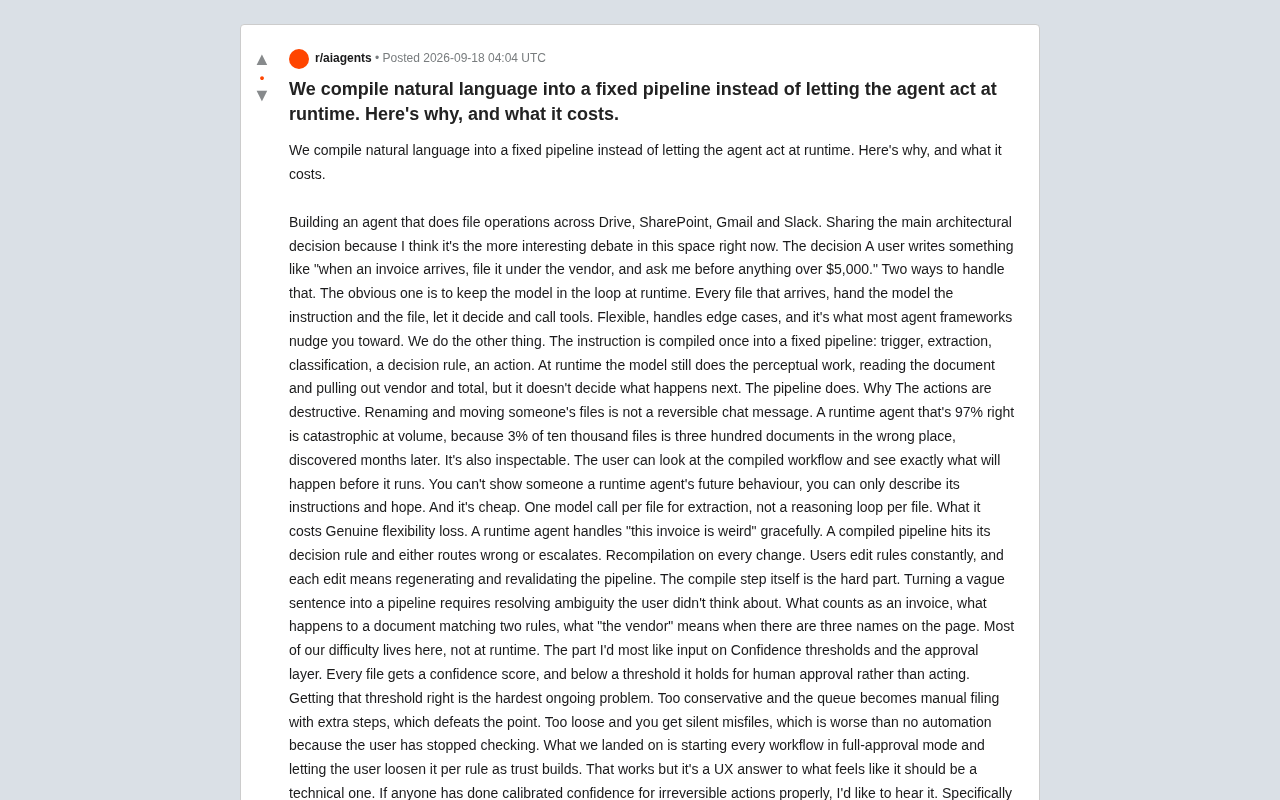
将AI Agent的自然语言指令预编译为固定流水线,让模型只做感知而非决策,以换取可预测性和可审查性。
本文讨论了生产级AI Agent的核心架构分歧:让模型在运行时自主决策(ReAct范式),还是将用户指令一次性编译为固定处理管线。文件操作类产品The Drive AI选择了后者——模型仅负责信息抽取等感知任务,控制流由预编译的规则管线掌控。这一选择的三大理由是:文件操作不可逆、工作流可被用户预先审查、单文件成本更低。代价则是灵活性损失、规则变更需重新编译,以及歧义消解的真正难度集中在编译阶段而非运行时。最棘手的开放问题是置信度阈值设计:阈值过严沦为手动归档,过松导致静默错放。文章最终提出一条设计哲学:Agent的自主程度应由操作后果决定,而非作为技术卖点。
一个正在被重新审视的Agent设计难题
构建能够跨 Google Drive、SharePoint、Gmail 和 Slack 执行文件操作的 AI Agent 时,最核心的架构分歧并不在于模型能力,而在于让模型在运行时自主决策,还是把自然语言指令编译成固定流水线。这是当前 Agent 领域最值得讨论的问题之一。
一位 Reddit 开发者(商业产品 The Drive AI 团队)分享了他们的选择:不让 Agent 在运行时自由行动,而是把用户的自然语言指令一次性编译成一条固定的处理管线。这个决策背后的权衡,对任何在做生产级 Agent 的团队都有参考价值。
两种处理方式的分野
设想用户写下这样一条指令:
"当发票到达时,按供应商归档;任何超过 5000 美元的都要先问我。"
处理这条指令有两条路径。
运行时决策(主流做法)
最直觉的方案是让模型始终在回路中。每当一个文件到达,就把指令和文件一起交给模型,让它判断该做什么并调用工具。这种方式灵活、能优雅处理边缘情况,也是大多数 Agent 框架默认引导你走的方向。
这种架构通常被称为"ReAct"模式(Reasoning + Acting),由Yao等人在2022年提出。模型在每一步先推理当前状态,再决定调用哪个工具,工具返回结果后再进入下一轮推理。LangChain、LlamaIndex、AutoGen等主流Agent框架均默认采用这一范式。它的吸引力在于无需预先枚举所有可能路径——模型可以根据中间结果动态调整策略,这在需求模糊或流程分支复杂的场景下表现出色。然而这种灵活性的代价是:每个决策点都是一次新的模型调用,执行路径在运行前无法确定,因此也无法向用户提前展示"系统将会做什么"。
编译式流水线(本文的选择)
另一种做法是把指令编译一次,生成固定的处理管线:触发条件、信息抽取、分类、决策规则、执行动作。
运行时模型仍然承担"感知"工作——读取文档、抽取供应商名称和总金额,但它不再决定接下来发生什么,这一步交给编译好的管线。模型从"决策者"退化为"感知器"。
这一思路与软件工程中"将动态解释替换为静态编译"的传统优化策略一脉相承,也与近年来兴起的"工作流自动化"(Workflow Automation)产品方向高度吻合。在AI应用领域,类似的设计被称为"确定性Agent"或"结构化Agent",其核心思想是将LLM的使用限制在有明确边界的子任务上——例如信息抽取、意图分类——而把控制流逻辑(如条件判断、动作路由)交由代码或规则引擎处理。这与Anthropic在其Agent设计指南中所建议的"尽量用代码逻辑代替模型决策"原则一致。编译步骤本身可以理解为一次"意图解析"(intent parsing):将用户的自然语言规则转化为机器可执行的结构化表示,相当于把prompt engineering的工作从每次运行时前移到了部署时。
为什么选择编译式:三个硬理由
操作是破坏性的、不可逆的
重命名和移动别人的文件,不像聊天消息那样可以撤回。作者点出了一个关键的量级问题:一个 97% 正确率的运行时 Agent,在规模化场景下是灾难性的。一万个文件里的 3% 就是三百份文档被错放,而且往往几个月后才被发现。
可检查性
编译式管线是可以被审查的。用户在运行之前就能看到编译后的完整工作流,明确知道将会发生什么。而运行时 Agent 无法向用户展示它未来的行为,你只能描述它的指令,然后祈祷它照做。
成本更低
每个文件只需一次模型调用来做抽取,而不是为每个文件跑一整个推理循环。在高吞吐场景下,这个成本差距会被放大。
代价同样真实
编译式路线并非没有牺牲,作者对自己的选择保持了难得的诚实。
灵活性的真实损失。 运行时 Agent 能优雅地处理"这张发票很奇怪"的情况;固定管线撞上决策规则时,要么路由错误,要么直接升级到人工。
每次改动都要重新编译。 用户会不断修改规则,而每次编辑都意味着重新生成并重新验证整条管线。
编译步骤本身才是最难的部分。 把一句模糊的话变成管线,需要解决用户根本没想到的歧义:
- 什么才算"发票"?
- 一份文档同时匹配两条规则时怎么办?
- 当页面上出现三个名字时,"供应商"到底指谁?
作者坦言,他们大部分的困难都集中在这里,而不在运行时。这与直觉相反——大家常以为运行时执行才是难点,但当决策被前移到编译阶段,歧义消解成了真正的工程瓶颈。
最棘手的开放问题:置信度阈值与审批层
作者最希望获得外部意见的,是置信度阈值和审批机制的设计。
每个文件都会得到一个置信度分数,低于阈值时不执行动作,而是挂起等待人工审批。如何设定这个阈值,是持续存在的最难问题:
- 阈值太保守:审批队列变成"多了几步的手动归档",自动化的意义就没了。
- 阈值太宽松:出现静默错放。这比"完全不自动化"更糟,因为用户已经停止检查了。
他们目前的方案是:每条工作流都从"全审批模式"起步,随着信任建立,允许用户按规则逐步放宽。 这确实有效,但作者敏锐地指出——这是一个"UX 答案",去回应一个本该由"技术"解决的问题。
一个尚未解决的技术追问
作者向社区抛出的具体问题很有价值:能否从 LLM 分类中直接得到一个可用的、校准过的置信度分数?还是说你最终必须引入一个独立的验证环节(separate verification pass)?
这触及了当前 LLM 应用的一个软肋——大模型输出的"置信度"往往未经校准,对于不可逆动作而言,未校准的置信度几乎等于没有置信度。
LLM输出的概率分数(logprobs)与真正意义上"校准过的置信度"存在本质差异。校准(calibration)指的是:当模型说某个预测有80%置信度时,该预测在现实中确实应该有80%的正确率。研究表明,大型语言模型普遍存在过度自信(overconfidence)或置信度与准确率不一致的问题,在分布外样本(out-of-distribution inputs)上尤为明显。针对这一问题,工程上的常见缓解手段包括:温度缩放(temperature scaling)对logprobs进行后校准、引入独立的验证模型对初次分类结果打分、或通过多次采样并统计结果一致性来估算可靠性。但这些方法都会增加延迟和成本,且没有哪种方案能在所有任务上普遍适用,这正是作者所说"未经校准的置信度几乎等于没有置信度"的工程现实。
这场辩论的更大意义
这个案例超越了单个产品的架构细节,指向了生产级 Agent 的一条设计哲学分歧:
在动作可逆、容错高的场景(如聊天、草稿生成)里,运行时自主 Agent 的灵活性是优势;而在动作破坏性、规模大、错误难以察觉的场景(如文件系统操作、财务归档)里,可检查、可预测的编译式流水线可能才是负责任的选择。
换句话说,Agent 的"自主程度"不应是一个技术炫耀点,而应是根据操作后果动态调整的工程决策。当代价是别人几个月后才发现的三百份错放文档时,牺牲一部分灵活性换取确定性和可审查性,是完全合理的取舍。
相关推荐
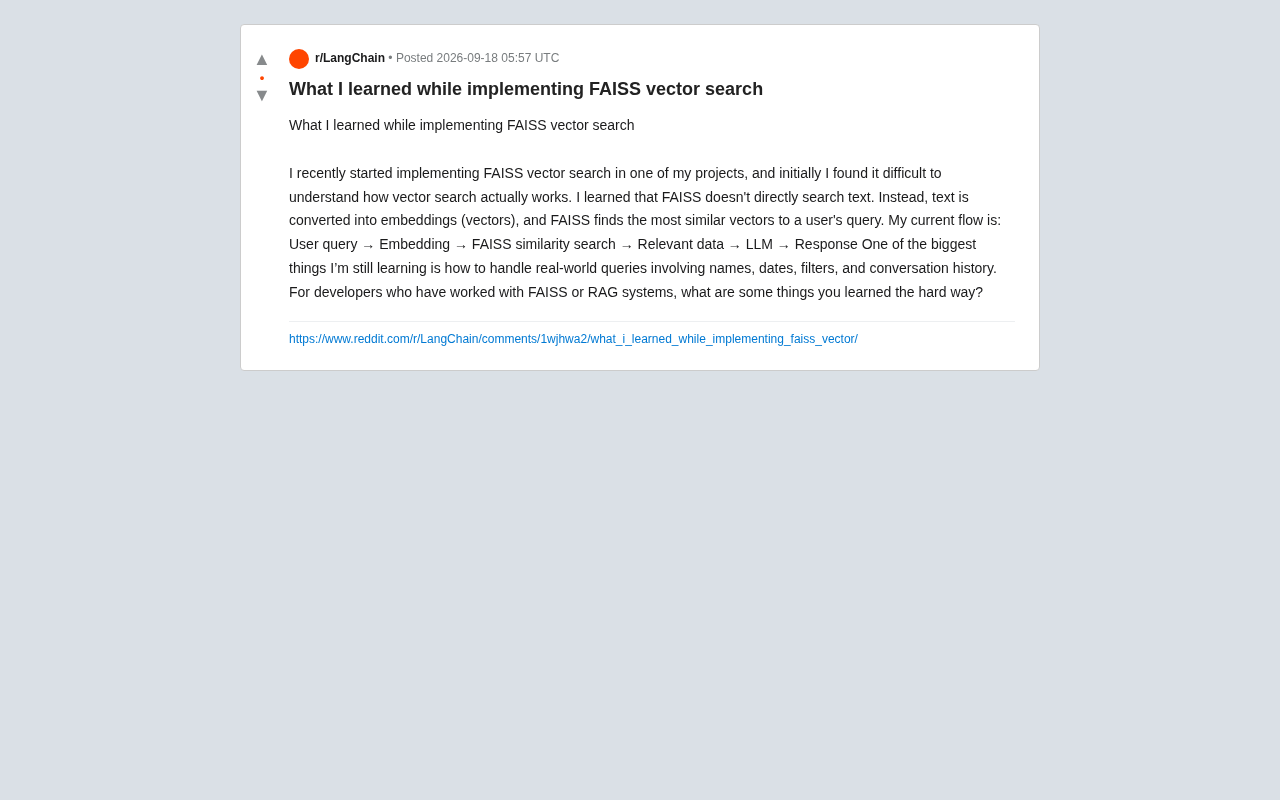
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。