BioPhys-Bridge:跨学科科学推理评测新基准
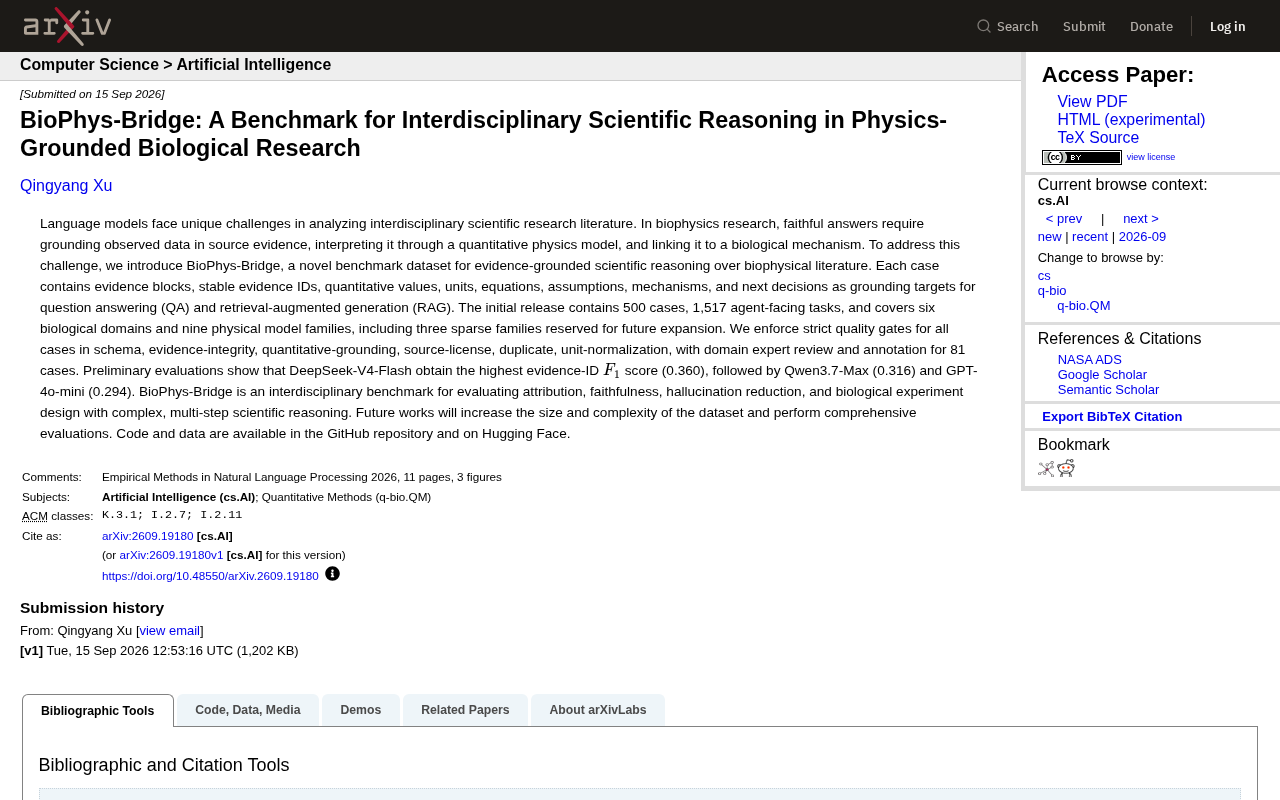
BioPhys-Bridge是首个面向生物物理文献的证据溯源科学推理基准,揭示主流大模型在跨学科归因上的显著短板。
BioPhys-Bridge 是一个专为生物物理跨学科推理设计的评测基准,旨在考察大模型能否在复杂多步骤科学推理中做到证据可溯源、结论忠实可信。数据集首发版本包含500个案例与1517个智能体任务,覆盖六大生物领域和九个物理模型家族,每个案例被拆解为结构化的接地目标,同时支持问答与RAG两类任务。数据集通过多重自动质量门与81个案例的专家人工复核双重保障可信度。初步评测显示,表现最佳的DeepSeek-V4-Flash在证据ID的F1分数上仅达0.360,表明当前大模型在跨学科溯源与定量-机制串联上仍有相当大的提升空间。相关代码与数据已在GitHub和Hugging Face开源。
大模型面对跨学科科研的难题
语言模型在处理科学文献时表现日益出色,但当研究跨越多个学科边界时,挑战陡然升级。生物物理学正是这样一个典型场景:一个可靠的回答,需要把观察到的数据锚定到原始证据中,再通过定量的物理模型进行解释,最终将结论关联到具体的生物学机制。这条推理链条环环相扣,任何一步的脱节都可能导致模型给出看似合理却缺乏依据的答案。
为应对这一难题,研究者提出了 BioPhys-Bridge——一个面向生物物理文献、以证据为基础的科学推理评测基准。它的核心目标是检验模型能否在复杂、多步骤的科学推理中做到证据可溯源、结论忠实可信,并有效抑制幻觉。
数据集的设计与结构
BioPhys-Bridge 的每一个案例都不是简单的问答对,而是被拆解成一系列结构化的接地目标(grounding targets)。这些目标包括证据块(evidence blocks)、稳定的证据 ID、定量数值、单位、公式、前提假设、生物学机制以及下一步的决策方向。
这种设计让基准能够同时支撑两类任务:问答(QA)与检索增强生成(RAG)。换句话说,模型不仅要回答"是什么",还要说清楚"依据在哪里"以及"如何从物理模型推导到生物机制"。
首个发布版本包含 500 个案例、1517 个面向智能体的任务,覆盖六大生物学领域和九个物理模型家族。其中三个物理模型家族属于稀疏类别,被保留用于未来扩展,为基准的成长预留了空间。
检索增强生成(RAG)是一种将大型语言模型与外部知识库结合的技术范式:模型在生成答案前,先从文档库中检索出相关片段,再以这些片段作为上下文进行推理。与纯粹依赖参数记忆的生成方式相比,RAG 能够将输出锚定到可查证的原始文献,从而降低幻觉风险。在 BioPhys-Bridge 的设计中,RAG 任务要求模型不仅给出答案,还必须从证据块库中精确定位支撑该答案的具体段落或数值,这比普通 RAG 更进一步——错误的证据 ID 即使答案表面正确也会被判定为失败,因此对模型的归因能力构成直接考验。
严格的质量把关机制
跨学科数据集最容易出问题的地方在于质量控制。BioPhys-Bridge 对所有案例设置了多道严格的质量门槛,覆盖以下几个维度:
- Schema 规范:确保数据结构统一一致
- 证据完整性:验证证据块的可靠性
- 定量接地:数值与来源必须对应
- 来源许可:遵循合规的授权要求
- 去重:避免重复案例
- 单位归一化:统一量纲表达
在此基础上,研究团队还邀请领域专家对其中 81 个案例进行了人工审查与标注。这种"自动质量门 + 专家复核"的双重机制,是保障跨学科基准可信度的关键一环。
主流模型的初步表现
初步评测揭示了当前模型在证据溯源上的真实水平。以证据 ID 的 F1 分数作为核心指标:
- DeepSeek-V4-Flash 取得最高分 0.360
- Qwen3.7-Max 以 0.316 紧随其后
- GPT-4o-mini 得分 0.294
值得关注的是,即便是表现最好的模型,其证据 ID 的 F1 也仅有 0.36 左右。这一数字直观地反映出:在需要精确定位证据、并将物理定量与生物机制严密串联的任务上,现有大模型仍有相当大的提升空间。这类跨学科、多步骤推理任务,正是暴露模型幻觉与归因薄弱环节的试金石。
F1 分数是信息检索与分类任务中常用的综合评估指标,它是精确率(Precision)与召回率(Recall)的调和平均值:精确率衡量模型给出的证据 ID 中有多少是正确的,召回率衡量所有正确证据 ID 中模型找到了多少。F1 值介于 0 到 1 之间,越接近 1 表示性能越好。在 BioPhys-Bridge 的语境下,证据 ID 的 F1 分数直接反映模型将结论与原始证据块精确对应的能力——即便模型给出了语义上合理的答案,若无法准确引用对应的证据来源,F1 分数依然会偏低。当前最优模型仅达到 0.36,意味着在精确归因这一维度上,模型的表现仍远低于科研实践的要求。
意义与展望
BioPhys-Bridge 填补了跨学科科学推理评测的一块空白。它不只是衡量模型能否答对题,更强调归因(attribution)、忠实性(faithfulness)、幻觉抑制以及生物实验设计这几个在真实科研场景中至关重要的能力。
对于希望将大模型引入科研辅助流程的研究者而言,这样的基准提供了一把更贴近实际的标尺——它逼迫模型在复杂证据链条中保持严谨,而非停留在流畅的表面叙述。
研究团队表示,后续工作将进一步扩大数据集规模、增加复杂度,并开展更全面的评测。目前,相关代码与数据已在 GitHub 仓库和 Hugging Face 上公开,为社区的复现与拓展提供了基础。随着基准的持续演进,它有望成为评估科学推理能力的重要参照。
相关推荐
AI大模型测试三阶段:从原理到API调用实战指南
面向测试从业者的AI大模型学习路径:从文本输入原理、提示词工程,到基于OpenAI库的API与SDK调用实战,理清Token与API Key区别、流式输出机制,并延伸到RAG与Agent智能体的落地方向。
Vercel首席软件官复盘:智能体构建从多智能体到文件系统的进化
Vercel首席软件官Andrew在AI Engineer大会复盘智能体构建历程:从巨型提示词到多智能体链、单体记忆管理,再到受Cloud Code启发的文件系统智能体,最终催生开源框架EVE。深度解析智能体架构演进与垂直智能体的核心壁垒。
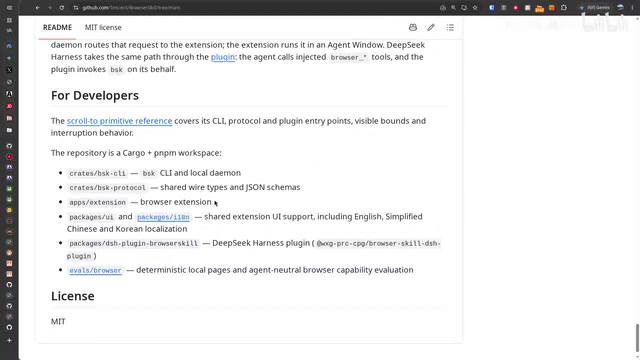
腾讯开源 BSK 实测:让 AI 接管你已登录的浏览器
腾讯开源 BSK(Browser Skill Kit)实测:让 AI 直接接管已登录的真实 Chrome 浏览器,通过 WebSocket 实现远程指挥。本文解析其架构原理、安装方式,以及插件版本、新窗口复用、验证码人机接管三大实操要点。