不训练,把一颗CPU编译进千问权重,意味着什么?

将32位RISC-V CPU编译进千问权重,不训练即实现精确计算,乘法正确率从22/40提升至39/40。
开发者将一颗完整的32位RISC-V CPU直接编译进千问3.5的权重中,不经过任何训练,原模型权重未改动。通过将Gated Delta Net状态矩阵的门控和写入强度设为1实现精确存储,并利用前馈层构建查找表执行指令,新增的11层约104万非零权重承载了CPU逻辑。在40道大数乘法题上,原版千问做对22道,装CPU后做对39道。代价包括速度慢、模型文件从9.3GB增至18.8GB、需要驱动程序。该工作证明了训练权重与编译器生成的确定性计算权重可以共存于同一模型,为混合架构提供了概念验证。
大模型不会精确计算,这是它的结构性缺陷。靠猜下一个字来生成答案的模型,遇到多位数乘法几乎必然出错。让千问3.5用40亿参数版本、不给外部工具、要求每一步精确计算40道题,它只做对了22道。
开发者DVN是Agro换了一条路:把一颗完整的32位CPU直接编译进模型权重里。同样40道题,做对了39道。这颗CPU一步训练都没有——它的每一个权重都是编译器直接算出来填进去的。
为什么模型算不准,而这个方案能算出精确结果
状态矩阵:从模糊记忆到精确存储
千问3.5这个版本一共32层,每四层里有三层使用Gated Delta Net结构,内部有多张状态矩阵。模型每读进一个字,就按固定公式改写一次表。公式里有两个关键参数:门控决定旧内容保留多少,写入强度决定新数据与旧数据的混合比例。
在正常模型中,一次写入会同时影响多行,因此状态矩阵只能记住一个大概,存不住精确数值。作者的做法是把门控设为1、写入强度设为1,并让每个键只对准一行——每次写入恰好整行替换,其他行不受影响。按行号读取,读回来的数一点不差。这就是内存。
我在自己的小模型里验证过:往8行的表里先后写进7、3、4,门控为0.9的那张表9步之后4只剩1.55;写入强度为0.5的那张表7只写进去一半;键不对准单行的表冒出大量噪声。只有门控和写入强度都设为1的那张表始终原样。
Gated Delta Net 是一种线性注意力变体,核心是用一个可更新的状态矩阵代替传统注意力中的键值缓存。与标准 Transformer 注意力不同,它不需要在生成长度增长时保留所有历史 Token 的键值对,而是用一个固定大小的矩阵压缩历史信息。每读入一个新 Token,就通过门控机制决定保留多少旧状态,再按写入强度将新信息混入。这种结构在长序列上内存占用恒定,但压缩过程天然有损,因此默认情况下无法精确还原数值。作者正是利用其可编程性,将门控和写入强度推到极端值,使状态矩阵退化为可精确寻址的内存。
前馈层:用神经元搭出查找表
记住数之后还要能算。这件事交给每层里的前馈层——一大排神经元,每个神经元把输入乘权重加总,结果小于0就输出0。只要权重设置正确,它就能在输入恰好是某种0和1组合时输出1,其他组合一律输出0。一排这样的神经元就是一张查找表,能判断一条指令是加法还是跳转、该读哪一格。
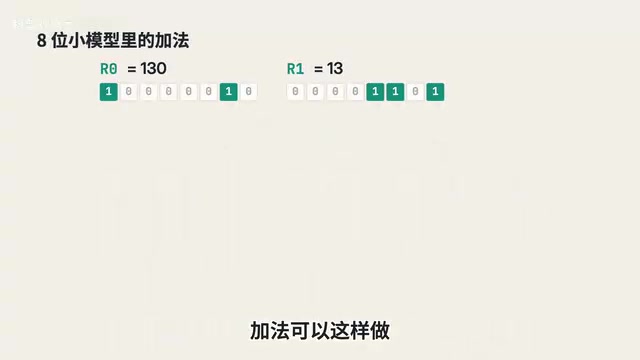
32位CPU的数太大,需要拆成每4位一段分开计算,道理与8位小模型一致。
ReLU 前馈层 是 Transformer 中每个块后面的两层全连接网络,通常用于增加非线性表达能力。其计算为:第一层将输入映射到更高维空间,经 ReLU 激活后,第二层再映射回原维度。当权重被精心设置时,每个神经元可以充当一个与门:仅当输入向量的特定维度同时为 1 时,加权和才为正,ReLU 后输出非零。通过组合多个这样的神经元,前馈层就能实现任意布尔函数,即一张查找表。作者将指令译码、寄存器选择等逻辑全部编码进这些权重,从而让前馈层执行确定性计算。
从8位玩具到32位RISC-V:规模与验证
作者先做了一个8位小CPU的验证:一个4层的小网络,8000多个非零权重全部由编译器算出。寄存器、程序计数器都存在状态矩阵里。网络每次输出一个Token——一条指令要两三个Token,先说改哪个寄存器,再说改成多少,最后说下一条指令在哪。每个Token生成后写回状态表,CPU就往前走一小步。
给它13乘以11(用反复加法实现),它执行38条指令、生成90个Token,最后写出143。1000个随机程序、116万多条指令,每个Token都与Python写的解释器逐一对比,没有一处不一致。
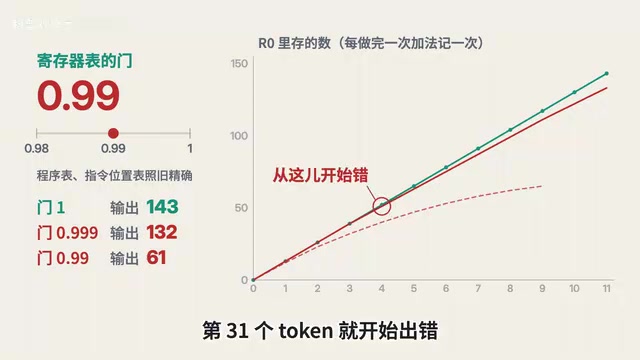
这个精度对参数极其敏感:只改一个数,把寄存器那张表的门控从1改成0.999(每步忘掉千分之一),同一个程序算出132;门控为0.99时算出61;门控为0.999时第31个Token就开始出错。
真正的QNPUTER是一颗32位RISC-V CPU,放在千问原有32层之前,整个模型变成43层。千问原来的权重一个没动,新增的11层里非零权重大约104万个(千问本身约41亿参数)。它通过了RISC-V官方测试集,作者用61个程序确认其输出与参考机器及QEMU模拟器完全一致,每个Token都与参考机器对齐。这11层单独拿出来还能跑精简版Python。
RISC-V 是一个开放标准的指令集架构,由加州大学伯克利分校于 2010 年发起,因其免费、模块化、可扩展而广泛用于学术研究和工业芯片设计。与 x86 或 ARM 不同,任何人无需授权即可实现 RISC-V 处理器。作者选择 RISC-V 作为目标架构,一方面是因为其指令集简洁规整,便于用查找表方式在神经网络中模拟;另一方面是因为有成熟的官方测试集和 QEMU 模拟器可供交叉验证。32 位 RISC-V 意味着寄存器宽度为 32 位,地址空间 4GB,足以运行精简版 Python 解释器。
模型如何调用这颗CPU
作者借用了千问本来就有的工具调用写法。千问照常写出调用计算器的格式,但外部并没有程序接住——前面那11层读到算式,在CPU上算完,再由模型自己一个字一个字写出结果,千问接着往下说。
效果对比:40道大数乘法题,原版千问对22道,装CPU的对39道,接真Python的对40道。作者逐个核查了CPU返回的结果,都是对的;错误出在千问自己身上,比如抄答案时丢符号,或者反复调用44次也没收尾。日常聊天时两者几乎分辨不出来,输出差异与同一模型换底层程序跑两遍的差别相当。
工具调用 是大模型的一种能力:模型在生成过程中输出特定格式的文本(如 JSON 或特殊标记),外部系统解析后执行相应操作(如计算器、搜索、代码执行),再将结果返回给模型继续生成。千问 3.5 本身支持这种格式。作者巧妙地将 CPU 嵌入模型前 11 层,当模型写出调用计算器的标记时,这 11 层直接接管后续 Token 的生成,在内部 CPU 上完成计算并逐字输出结果,而无需任何外部进程。这本质上是用模型权重模拟了工具调用的协议,但执行完全发生在模型内部。
代价与边界
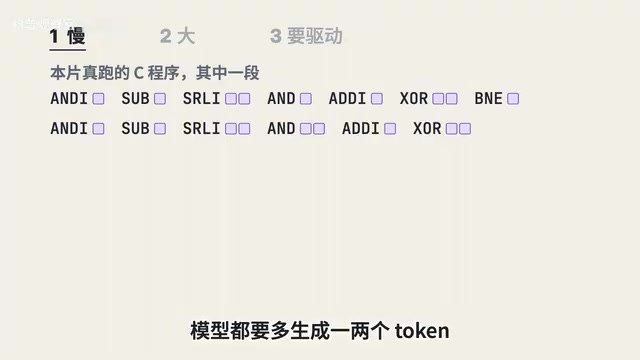
第一是速度。CPU每执行一条指令,模型要多生成一两个Token。在一块英伟达L4显卡上,一次计算器调用要半秒到一秒,这已经是用了作者专门写的加速程序;只用普通模型代码还要再慢十几倍。
第二是体积。模型文件从9.3GB变成18.8GB,多出来的大部分是填充的零。
第三是需要一个小驱动程序,开机时把CPU固件装进状态表,运行时让那些Token不进千问自己的32层。Hacker News用户GCR质疑"不靠外部运行环境"的说法不够老实。作者的回应是:驱动不做计算也不解析算式,每个Token仍然是权重算出来的;加速程序算的也是同一套电路,与走权重的结果一致。
作者也做过更正:博客发布前两天修了一个毛病——同一段对话里后一次计算可能把上一次留下的数字打印出来;同一天删掉了"这一版从没打印过错误结果"的表述。后来又放出实验版:在这颗CPU上用C程序跑一个26万参数的小语言模型,权重作为数据装进CPU内存,每生成一个Token约需41秒。开发者Drew Brionig则用QNPUTER的编译器把红白机处理器编进结构相同的模型,在里面跑起了红白机游戏。
这意味着什么
这件事的意义不在于"模型会算数了",而在于展示了权重可以承载确定性计算。训练出来的权重和编译器写进去的权重可以共存于同一个模型,前者负责语言,后者负责精确执行。这为混合架构提供了实证:不是所有能力都必须从数据里学出来,有些能力可以直接构造。
代价同样明确——速度、体积、工程复杂度都不低。它更像一个概念验证的里程碑,而非可直接部署的方案。但它打开了一个问题:模型权重里还能装进什么?
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。