B站最全AI大模型应用开发课:认知决定成败

学习大模型应用开发,第一步是改变认知,把AI当人看,从熟悉领域入手做产品。
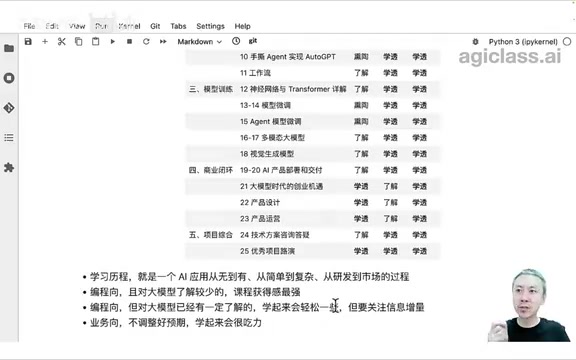
孙志刚的《AI大模型应用开发》课程强调,学习大模型的第一步不是写代码,而是“掰认知”——把AI当人看,而非 deterministic 的机器。课程预测AGI可能在三到五年内实现,但基础模型训练门槛极高,多数人的机会在成为AI产品制造者,需要懂业务、懂AI、懂编程。当前没有Killer App,大模型落地应从小场景和熟悉领域入手。技术选型优先Prompt和RAG,微调非必要不做;选模型没有最好只有最适合。最终心法是建立对象感,用与人相处的方式使用AI。
在B站上,一套名为《AI大模型应用开发》的教程被誉为“最全最细”,由孙志刚主讲。与常见的技术课程不同,第一课几乎不写代码,而是花大量时间讲“认知对齐”。这种设计背后有一个判断:学习大模型,第一步不是学技术,而是改变对机器的习惯性认知。
为什么“认知”比“干货”更重要?
孙志刚在开场直言,这节课“不够干货”。但他认为,传统技能学习可以直奔代码,大模型却不行。“学习大模型AI第一步最重要的是掰认知,改变自己这么多年以来对机器的习惯、对计算机的习惯、对编程的习惯。”
背后的逻辑是:大模型不是一个 deterministic 的软件系统,而更像一个概率性的“人”。如果沿用机器思维——输入A必然得到B——就会处处碰壁。课程将这种转变概括为 “把AI当人看”。图灵奖得主杰弗里·辛顿曾指出,数字神经网络与人脑生物神经网络在底层原理上有相似性;凯文·凯利也表达过类似观点:我们怎么和人相处,就该怎么和AI相处。
这种认知转变体现在多个层面。比如,不要问“大模型能不能做X”,而应该直接让它做,从结果判断。孙志刚说:“大模型的设计者甚至都不知道它能干什么不能干什么,所以不要问能不能,自己去试。”
Deterministic(确定性)系统指的是给定相同输入,总是产生完全相同输出的系统,传统软件和算法大多属于此类。大模型则相反:其输出由概率分布采样决定,相同的提示词可能得到不同结果。这种非确定性源于模型在训练中学习到的是词序列的统计规律,而非硬编码规则。因此,使用大模型时不能用“输入A必然得到B”的思维去调试,而应像与人沟通一样,通过调整提示词、提供上下文来约束概率空间,并接受一定程度的结果波动。
AGI时间表与三类参与者
课程对AGI(通用人工智能)给出了一个预测区间:主流观点认为三到五年内可能实现,学术界偏悲观,认为需要十年。孙志刚个人更相信三到五年的判断,并笑称“拼命锻炼身体就是为了活着见到AGI”。
在AGI时代,人与AI的关系可以分为三层:
- AI产品的使用者:使用别人开发的AI产品,人数最多,但“完全不稀缺”。
- AI产品的制造者:制造AI产品满足自身或他人需求,是课程的核心目标。
- 基础模型相关工作者:训练基础大模型或提供算力、框架等基础设施,门槛极高。
孙志刚透露,全球真正从头训练基础大模型的核心团队人数极少,一个典型团队核心成员不超过二十人,其中直接做训练的往往只有两三人。他认为,完全原创的国产大模型数量不会超过二十个,多数是在开源模型上优化。“全世界最后剩下的基础模型公司可能不超过一百家,甚至十家以内。”
对于大多数学习者,课程定位在第二层:成为 AI产品制造者。
AI产品制造者的能力模型:三懂
课程提出,AI产品制造者需要三种能力:懂业务、懂AI、懂编程。
- 懂业务:知道一个行业如何赚钱、如何运作。
- 懂AI:知道AI能做什么、不能做什么,以及如何做得更好、更快、更便宜。
- 懂编程:能独立完成一个完整程序。
孙志刚强调,三者缺一不可。“缺任何一样,产品都是残缺的:要么性能有问题,要么效果有问题,要么做得完美却无法获得商业回报。”课程目标是培养“AI全站工程师”,但学员可以根据自身情况定位为“业务向”或“编程向”,至少要两懂,且无论如何都要懂AI。
大模型落地现状:没有Killer App
课程用一首打油诗概括当前落地现状:“Killer App没有影,AI原生待证明,手握场景不着急,内部提效暗暗行。”
孙志刚认为,大模型并没有创造新场景,而是对旧场景的增强,因此不必苦苦追求“杀手级应用”。他提醒,如果有人张口闭口Killer App,“远离他,这是活在上一个时代的人”。
他将当前AI产品分为几类:
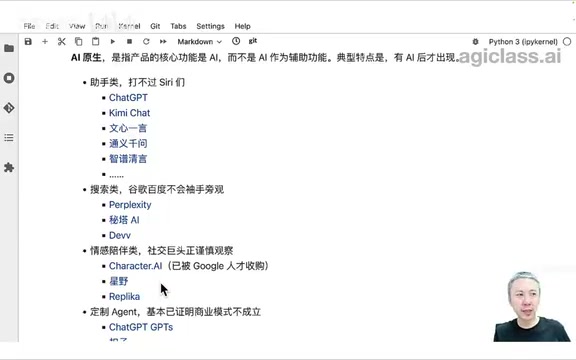
- AI原生:核心功能是AI,而非辅助。但多数所谓AI原生应用,如情感陪伴类,面临商业模式困境——一旦过滤成人内容,付费意愿急剧下降。
- 手握场景的巨头:拍照答题、办公、编程等领域,原有头部玩家将AI能力集成进产品,继续领先。
- 内部提效:大量企业在客服、营销、研发等环节用大模型降本增效,但不声张。
孙志刚指出,大模型落地最大的障碍是“认知没有对齐”——有人期望过高,有人评价过低。成功落地需要五个关键要素:业务人员积极、对AI能力有正确认知、业务团队自带编程能力、从小处着手、老板有耐心。
从最熟悉的领域入手
对于个人如何找到落地场景,课程给出一个核心原则:从最熟悉的领域入手。
“做大模型不存在改行,只存在让你在以前的行业领域里变得更厉害。”孙志刚说,“没有AI行业,只有教育、金融、工业、电力这些具体领域。”具体做法是:找到能用语言描述的任务,因为大模型目前最强的就是处理语言;别求大而全,把业务拆解,先解决小场景。
他以自己的项目为例:第一个创业项目是把AI和教育结合,教AI技术;第二个项目“爱师傅”是用AI直接当老师讲课。“我只干这一件事,不干AI销售、AI全套,就找小场景。”
大模型原理:概率预测与Token
课程用大量篇幅解释大模型的底层原理:根据概率猜下一个字。
演示中,输入“今天我很”,模型可能生成“忙”“高兴”等不同内容;输入“下班了今天我很”,生成内容会偏向工作场景;输入“放学了”,则偏向孩子视角。这说明提示词的作用是约束概率空间。“如果你前面输入的提示词能把场景限定得更窄更细,后面产生符合要求内容的概率就更大。”
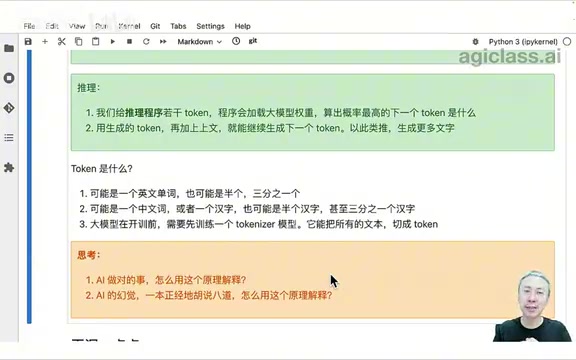
大模型有两个核心过程:训练和推理。训练是学习,将字词共现概率存入神经网络权重文件;推理是使用,基于权重和输入提示词,逐个生成下一个Token。
Token是大模型处理数据的最小单位,可能是一个英文单词、半个单词,也可能是一个汉字、半个汉字。外国大模型常把汉字拆碎,一个汉字可能占多个Token,而中文大模型一般不会。这直接影响中文处理的效率和成本。
Token是大模型处理文本的最小单位,但它并不等同于“字”或“词”。分词器(Tokenizer)会将文本切分成子词单元,常见算法如BPE(字节对编码)会根据语料频率决定合并规则。例如英文“unbelievable”可能被拆成“un”“believ”“able”三个Token;中文则可能一个汉字对应一个Token,也可能多个汉字合并。Token数量直接影响API计费(按Token收费)和上下文窗口长度,因此理解Token有助于优化提示词长度、控制成本,并解释为何同一段中文在不同模型上的表现和费用存在差异。
技术选型:Prompt、RAG、Function Calling与微调
课程梳理了大模型应用的技术架构:
- 纯Prompt:最简架构,通过提示词控制大模型。
- Function Calling + Agent:让大模型主动请求外部函数,比如查天气、查数据库。
- RAG(检索增强生成):通过向量数据库进行语义搜索,把相关知识注入提示词,解决大模型知识不足和幻觉问题。
- 微调:将新知识通过训练写入模型,成本最高,非必要不做。
技术选型的判断流程是:先准备测试数据,用部分数据在通用大模型上验证可行性;基础能力不够时,优先考虑RAG补充知识;需要对接外部系统则用Function Calling;只有在提高稳定性、降低推理成本、私有部署等场景下才考虑微调。
RAG(检索增强生成) 的核心思想是:在生成答案前,先从外部知识库中检索与问题相关的文档片段,将这些片段作为上下文注入提示词,再让大模型基于这些上下文作答。它通常依赖向量数据库——将文本通过嵌入模型转换为高维向量,用语义相似度进行检索。RAG能缓解大模型知识过时和幻觉问题,且无需重新训练模型,成本远低于微调。但其效果高度依赖检索质量,若检索不到相关内容,模型仍可能编造答案。
如何选择基础模型
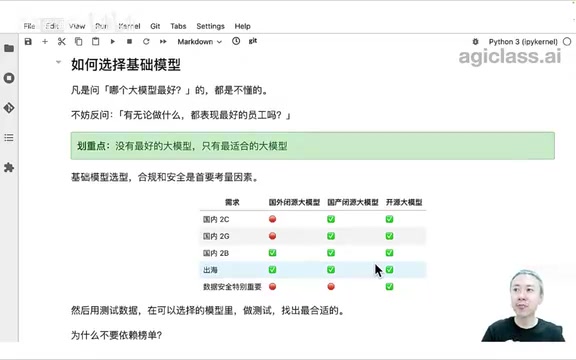
“凡是问哪个大模型最好的人,都是不懂的人。”孙志刚说,“没有最好的,只有最适合的。”
选择模型要考虑几个因素:合规安全(国内2C产品必须用国产大模型)、成本、具体任务表现。他提醒不要迷信榜单,“排行榜已经被应试教育污染了,很多公司有专门的打榜团队”。
课程以OpenAI为例讲解,因为“它是最流行的,整套玩法其他模型都在模仿,学会OpenAI其他模型触类旁通”。
榜单(Leaderboard) 如MMLU、C-Eval等,通过标准化测试集对模型进行评分排名。然而,这些榜单存在明显局限:测试题目可能泄露到训练数据中,导致分数虚高;部分公司专门针对榜单题目进行优化(即“打榜”),使排名不能真实反映模型在具体业务场景中的表现。因此,选型时应以自身业务数据构建小规模测试集,在实际任务上对比候选模型,而非盲目相信公开排名。
用AI的底层心法:建立对象感
课程最后回到核心心法:把AI当人看。
在不同场景中,赋予AI不同角色:学习时当老师,工作时当助手,休闲时当朋友。与AI交互时要建立“对象感”——知道你是什麼角色,AI是什么角色。
“人做事不可能百分百正确,AI也不可能。图灵说过,一台机器如果不会犯错,它就不可能是智能的。”孙志刚说,使用AI的所有技巧、框架、思路,几乎都能在人类社会和管理学中找到对应办法。
这或许就是这门课最反直觉也最有价值的地方:学大模型,先学做人。
相关推荐

Last Week Tonight深扒:政客与白人至上主义的危险纽带
Last Week Tonight调查佐治亚州参议员候选人Mike Collins与佛罗里达州候选人Marshall Rawson,揭露他们与白人至上主义者的多重关联,以及共和党内的沉默反应。
AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比
本周AI圈爆料汇总:GPT-6.5疑似泄露、微软配置现GPT-6.1 Tera、Anthropic新模型能识别整类Bug、Gemini 4 Carbon早期表现失望,以及MiniMax M3.1 Flash以极低成本在基准测试中超越Claude Opus 5和GPT-5.6 Sol。
AI快讯:Gemini 4 Carbon发布,蚂蚁开源Ling-3.1
AI快讯:Google发布Gemini 4 Carbon量子位模型,宣称超越Opus 5.5且首发Token半价;蚂蚁百灵开源Ling-3.1-1019推动Personal Agent真实任务;国产AI制药19个项目18个成功,6个GPCR靶点全命中;零营收公司估值200亿美元再融10亿美元;四川便利店机器人售货失败。