CacheGraft:用KV缓存为小模型RAG注入大模型知识

CacheGraft用离线融合KV缓存替代文本RAG,小模型零样本29/30胜出。
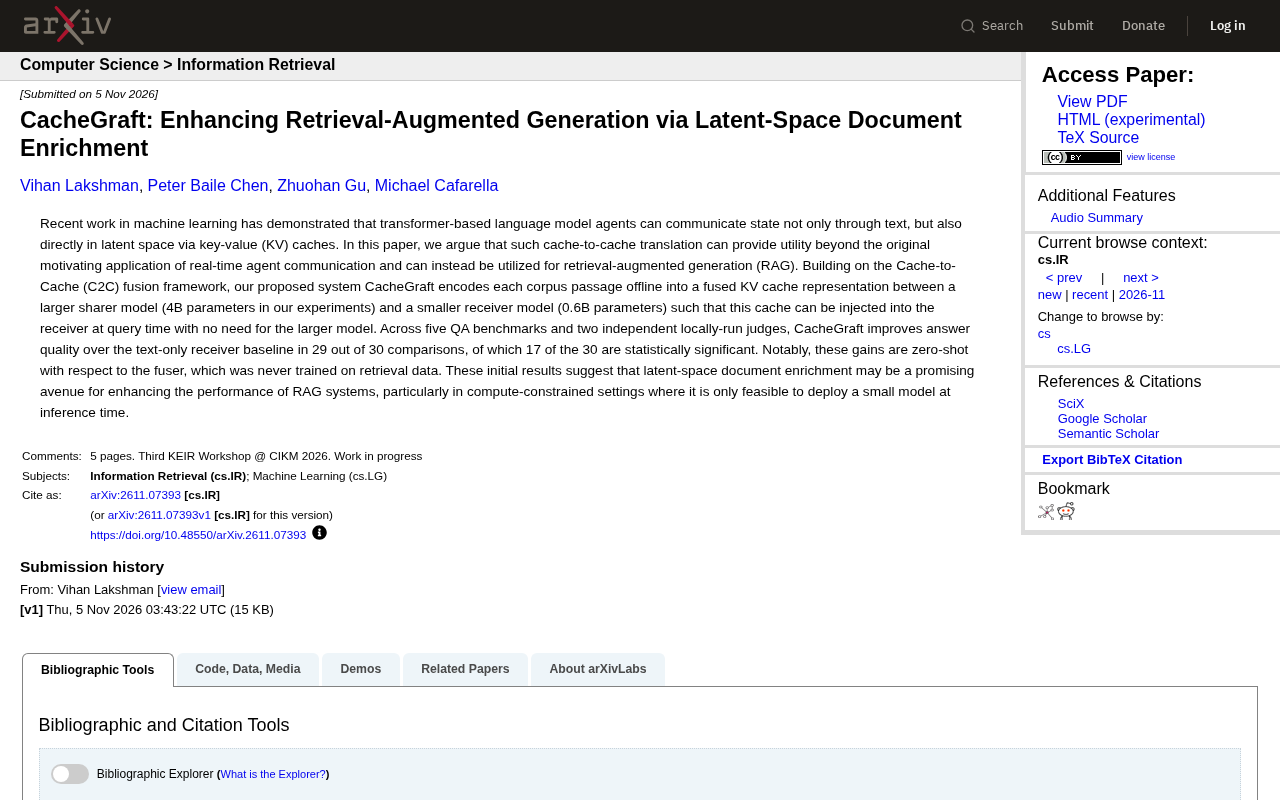
CacheGraft提出一种绕过文本片段的RAG新路径:基于Cache-to-Cache(C2C)融合框架,在离线阶段把语料库每个段落编码为大模型(4B)与小模型(0.6B)之间的融合KV缓存,查询时直接注入小模型,无需大模型在场。在五个问答基准、两个独立本地评委的评测中,该方法30次对比有29次优于纯文本接收方基线,其中17次统计显著;且增益对融合器是零样本的,说明C2C框架本身具备泛化能力。作者将结果定位为初步发现,认为潜空间文档富化对计算受限、推理时只能部署小模型的场景尤其有吸引力,但缓存兼容性、跨模型迁移与可扩展性仍待解决。
检索增强生成(RAG)的常规做法是把文档转成文本片段塞进提示词,但一篇新论文提出了另一条路径:把文档离线编码成大模型与小模型之间的融合KV缓存,查询时直接注入小模型,无需再调用大模型。这就是 CacheGraft,它基于 Cache-to-Cache(C2C)融合框架,试图用潜空间里的"缓存移植"替代文本层面的知识搬运。
从智能体通信到RAG:C2C框架的意外用途
C2C 框架最初的动机是让基于 transformer 的语言模型智能体之间不仅通过文本交流,还能直接通过键值(KV)缓存传递状态。CacheGraft 的作者认为,这种"缓存到缓存"的翻译能力可以跳出实时智能体通信的原始场景,转而服务于检索增强生成。
具体做法是:在离线阶段,将语料库中的每个段落编码为一个大模型(实验中为 4B 参数)与小模型(0.6B 参数)之间的融合 KV 缓存表示。到了查询时,这个缓存可以直接注入小模型,不需要大模型在场。换句话说,大模型的知识被"预编译"进了缓存,小模型只负责消费。
KV缓存是Transformer解码器在自回归生成过程中逐层缓存的键(Key)和值(Value)张量。每生成一个新token,模型只需计算当前token的注意力,历史token的K/V直接复用,从而把生成复杂度从二次降为线性。KV缓存本质上是模型对已处理上下文的"内部状态快照",其维度为层数×注意力头数×序列长度×头维度。正因它承载了上下文语义,且与模型权重解耦,才可能被提取、转换并注入到另一个模型中——这正是C2C与CacheGraft操作的对象。
融合KV缓存指并非来自单一模型的缓存,而是通过一个融合器(fuser)将大模型产生的KV表示与小模型自身的KV表示进行对齐、加权或变换后得到的混合缓存。由于不同模型的隐藏维度、层数和注意力头配置可能不同,融合器需要学习跨模型的投影映射,使大模型的缓存能"翻译"成小模型可直接消费的格式。CacheGraft的关键在于该融合器在离线阶段完成映射,在线时小模型无需大模型参与即可使用融合缓存。
零样本增益:29/30 次对比胜出
论文在五个问答基准上进行了评测,并使用了两个独立运行的本地评委模型。结果显示,CacheGraft 在 30 次对比中有 29 次优于纯文本的接收方基线,其中 17 次具有统计显著性。
更值得关注的是,这些增益对于融合器(fuser)来说是零样本的——融合器从未在检索数据上训练过。这意味着该方法并不是靠针对 RAG 任务的专门调优取胜,而是 C2C 框架本身的泛化能力在起作用。
**零样本(zero-shot)**在此处特指融合器没有在检索问答数据上进行过任何训练或微调,其参数完全来自C2C框架的原始训练目标。评测时直接把离线生成的融合缓存注入小模型并回答问题,属于分布外泛化测试。17次"统计显著性"通常意味着在多次采样或多次运行下,该方法相对基线的提升超过了随机波动范围(如p<0.05),而非仅凭单次结果判断优劣。两个独立本地评委模型的作用是降低单一评委的偏好偏差,但评委本身也是模型,其判断仍可能引入系统性偏差,这也是作者将结论定位为"初步结果"的原因之一。
为什么潜空间富化有吸引力
传统 RAG 的瓶颈之一在于文本片段的信息密度有限,且小模型对长上下文的利用效率往往不高。CacheGraft 的思路是把文档信息压缩进 KV 缓存这一更高维的表示空间,绕过文本瓶颈。
这对计算受限场景尤其有意义:如果推理时只能部署小模型,又想获得接近大模型的知识覆盖,那么离线用大模型生成缓存、在线只跑小模型,是一种有吸引力的折中。论文作者也明确指出,潜空间文档富化可能是提升 RAG 系统性能的有前景方向,特别是在仅能部署小模型的算力约束环境下。
**潜空间(latent space)**指模型内部高维连续表示空间,与离散文本token空间相对。传统RAG把文档切成文本片段再拼入提示词,信息受限于token数量和表面形式;而潜空间富化把文档编码为连续的KV张量,理论上能在相同或更少的"位置"里承载更密集的语义。其代价是可解释性下降——缓存中的知识难以像文本片段那样被检查、引用或编辑。此外,KV缓存的大小随层数和头维度增长,语料规模扩大时如何存储、检索和选择相关缓存,是该路线走向实用的关键工程问题。
初步结果与待解问题
论文将自身定位为"初步结果"。零样本表现虽然亮眼,但融合器未针对检索数据训练,也意味着后续还有通过训练进一步提升的空间。缓存注入的兼容性、不同模型对之间的迁移效果、以及缓存表示随语料规模增长的可扩展性,都是该方法走向实用需要回答的问题。
从更宏观的视角看,CacheGraft 提示了一条被较少探索的路线:RAG 的增强未必只能发生在文本层,潜空间里的缓存移植同样可以承载知识。对于关注小模型部署与 RAG 优化的研究者,这是一个值得跟进的信号。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。