CapMem:用文本字幕解决长视频情景记忆的新基准
CapMem研究证明用文本字幕替代视觉帧可高效实现长视频情景记忆推理。
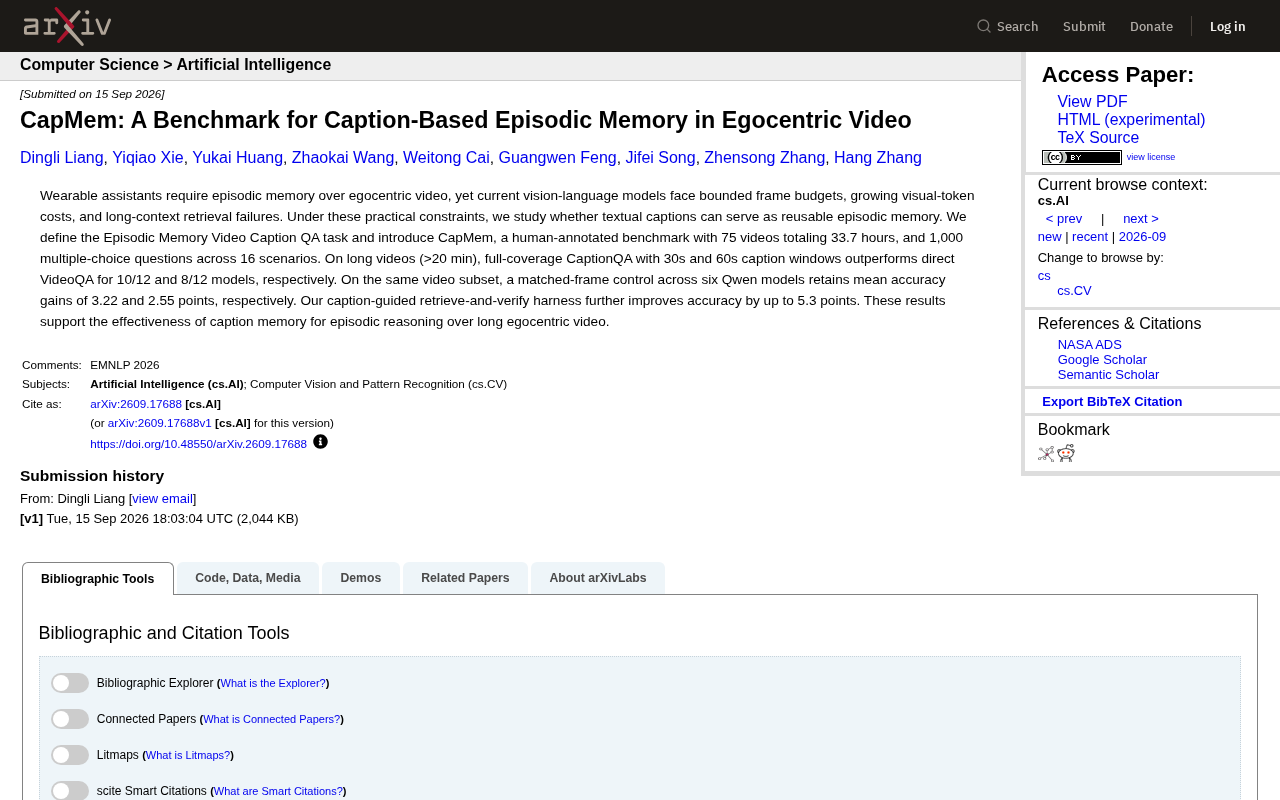
CapMem是一项针对可穿戴AI助手情景记忆问题的研究,提出以文本字幕作为长视频的轻量记忆载体,取代直接处理高成本视觉token的传统方案。研究团队构建了包含75段视频、33.7小时、1000道人工标注题目的基准数据集,系统评测了字幕方案在16种场景下的表现。实验显示,在超过20分钟的长视频中,以30秒或60秒为窗口生成的全覆盖字幕问答,在多数模型上超越了直接VideoQA;即使在匹配帧数的公平对照下,字幕方案仍保持3分左右的准确率优势。进一步引入字幕引导的检索-验证框架后,准确率最多再提升5.3分。研究表明,将视觉模态压缩为紧凑文本并配合检索增强,是实现实用化情景记忆助手的高效路径。
可穿戴助手面临的记忆难题
随着智能眼镜、AR助手等可穿戴设备的兴起,如何让AI记住并理解用户第一人称视角(egocentric)拍摄的长视频,成为一个核心技术挑战。理想中的可穿戴助手应当具备"情景记忆"(episodic memory)能力——能回忆起用户几分钟甚至几十分钟前经历过的场景细节。
但现实并不乐观。当前主流的视觉-语言模型(VLM)在处理长视频时受制于三大瓶颈:有限的帧预算、随视觉token增长而飙升的计算成本,以及在超长上下文中的检索失败问题。当视频动辄长达数十分钟,直接把画面全部喂给模型既不经济也不可靠。
视觉-语言模型(VLM)处理视频时,通常需要将视频帧转化为"视觉token"输入模型。每帧图像往往对应数百个token,一段30分钟的视频若以每秒1帧采样,将产生数万个视觉token,远超当前主流模型的上下文窗口限制(通常为4K至128K token)。即便是支持超长上下文的模型,随着token数量增长,注意力机制的计算量以平方级别膨胀,推理成本急剧上升。此外,研究表明模型在超长上下文中存在"中间迷失"(lost-in-the-middle)现象——对位于序列中段的信息的检索准确率显著下降。这三重约束共同决定了"暴力输入全部帧"的方案在实际可穿戴场景中既不可行也不可靠。
用字幕当作可复用的记忆
CapMem 这项研究提出了一个颇具巧思的思路:与其反复处理沉重的视觉信息,不如把视频内容转写成文本字幕(caption),将其作为一种可复用的情景记忆载体。
文本相比原始视频帧有天然优势——占用的token极少、易于存储和检索、可以跨查询重复使用。研究者据此定义了一个新任务:情景记忆视频字幕问答(Episodic Memory Video Caption QA),核心问题是:单靠字幕文本,AI能否有效完成对长视频的情景推理?
CapMem 基准的构成
为了系统性地验证这一假设,研究团队构建了 CapMem 基准数据集,其规模和标注质量值得关注:
- 75 段视频,总时长达 33.7 小时
- 1000 道多项选择题,全部由人工标注
- 覆盖 16 种不同场景
这样的规模确保了评测能够反映真实使用中的多样性,而非局限于单一任务类型。
实验结果:字幕记忆确实有效
研究最引人注目的发现集中在长视频(超过20分钟)场景上。
在这类视频中,采用全覆盖的 CaptionQA 方案——即以 30 秒和 60 秒为窗口生成字幕——其表现超越了直接进行 VideoQA 的传统做法。具体来说:
- 在 30 秒字幕窗口下,12 个模型中有 10 个表现更优
- 在 60 秒字幕窗口下,12 个模型中有 8 个表现更优
为了排除"字幕方案只是变相看了更多画面"的干扰,研究者还在六个 Qwen 系列模型上做了**匹配帧数(matched-frame)**的对照实验。在帧数对齐的公平条件下,字幕方案依然保持了 3.22 分和 2.55 分的平均准确率提升。这说明性能增益来自字幕这一记忆表示本身,而非额外的视觉信息输入。
检索-验证机制进一步提升表现
研究团队还设计了一套字幕引导的"检索-验证"(retrieve-and-verify)框架。这套机制先根据问题从字幕记忆中检索相关片段,再进行验证性推理,最终将准确率再提升了多达 5.3 分。
这一结果说明,字幕不仅可以作为静态记忆存储,还能配合更智能的检索策略,形成一套完整的长视频推理管线。
检索增强生成(Retrieval-Augmented Generation,RAG)是这一框架的核心思想来源。RAG的基本逻辑是:不将所有信息全部送入模型,而是先通过向量检索或关键词匹配找到与当前问题最相关的片段,再将这些精简后的上下文输入模型进行推理。在长视频场景中,字幕天然是良好的检索单元——每段字幕对应固定时间窗口、语义独立、且体积远小于对应的视频帧。"检索"步骤解决了"从哪里找答案"的定位问题,"验证"步骤则通过对候选答案进行二次推理来提升准确率,两者结合有效缓解了直接在全量字幕中推理时的噪声干扰。
意义与展望
CapMem 的价值在于为一个长期存在的工程约束提供了务实的解法。在可穿戴设备算力和内存受限的现实条件下,把视觉信息"压缩"为文本字幕,既降低了成本,又绕开了长上下文检索的痛点。
从更宏观的角度看,这项工作提示业界:处理长视频未必要一味追求更大的视觉token预算和更长的上下文窗口。将模态转换为更紧凑的文本表示,配合检索增强机制,可能是通向实用化情景记忆助手的一条更高效路径。
对于正在探索智能眼镜、AI助手等产品的团队而言,CapMem 提供的基准和方法论都具有直接的参考意义。当然,字幕方案也存在天然局限——字幕生成本身的质量、无法用语言精确描述的视觉细节,都可能成为信息瓶颈,这些将是后续研究需要面对的问题。
相关推荐
冰岛Treble获1800万美元融资,押注语音仿真平台
冰岛语音仿真公司Treble完成1800万美元融资,其平台服务于语音AI模型开发者、AI可穿戴设备及机器人公司。本文解析语音仿真技术价值与融资背后的行业信号。
开源之痛:非自回归架构的先行者,为何被前沿实验室抢了风头
一位独立开发者在 Reddit 发帖称,其一年前开源的非自回归 RL 架构,被前沿实验室重新包装为突破。本文拆解 PPO 序列嵌入与 RLCD 并行采样两种路线的异同,并探讨开源生态的溯源与署名困境。
AI全程规划葡萄园:一场100株葡萄藤的真实实验
华盛顿州斯波坎一位爱好者让Muse AI全程规划葡萄园,从品种选择、行距到灌溉全部交给AI,最终种下100株品丽珠。这场AI主导、人类执行的公开实验,揭示了AI辅助农业的机会与边界。