拆解 Claude Code 架构:前端进阶 AI Agent 开发指南
拆解Claude Code四大核心模块,指导前端工程师从「用透工具」到「亲手实现最小化编程智能体」。
本文基于一节围绕 Claude Code 架构与源码的公开课,系统梳理了通用型编程智能体的四大核心模块:负责「思考→执行→观测」循环的 Agent Loop、通过工具调用操作文件系统的 Tool 工具系统、可模块化扩展的 Skills 解析模块,以及分层管理上下文的 Memory 记忆模块。课程以「初中级认知→中高级架构→专家级从零实现」三段式递进,将知识点锚定在面试场景中,并通过一个用 TypeScript 手写的 minimal Claude Code 演示了完整运行链路。文章同时指出,纯前端岗位窗口收窄,「AI 提效 + AI Agent 开发」是前端/全栈工程师最值得押注的两条学习主线。
对前端和全栈工程师来说,理解一个通用型编程智能体(Coding Agent)的内部机制,正在从「加分项」变成「必备项」。这篇内容基于 B 站一节围绕 Claude Code 智能体架构与源码拆解的公开课,梳理出编程智能体的四大核心模块,以及一个可以从零实现的最小化版本(minimal Claude Code)的完整链路。
为什么前端要吃透编程智能体
课程一开始就抛出了一个现实判断:前端面试如果被问到 AI,很多人会完全摸不着头脑。UP 主给出的方向很明确——接下来两年的学习主线只有两条,一是 AI 提效,二是 AI Agent 开发。
AI 提效指的是把 Codex、Claude Code 这类工具用熟、用透,甚至能让它「24 小时帮你干活」;AI Agent 开发则是更进阶的能力,包括做工作流型智能体、通用型智能体,或者在垂直业务领域落地专用智能体。至于网上层出不穷的概念——提示词工程、Context Engineering、Vibe Coding、Spec Coding 等——课程建议先放一边,抓住工具使用和智能体开发这两个主干即可,不要被概念焦虑带偏。
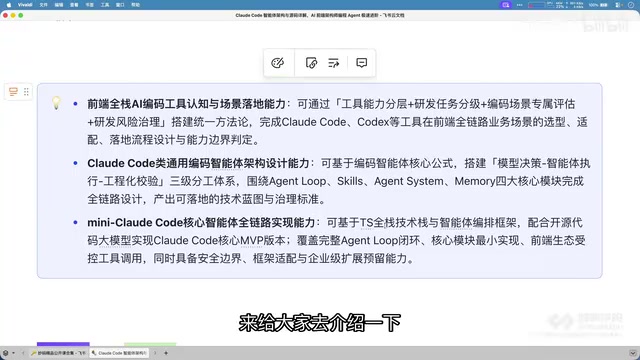
课程还给出了一个值得警惕的行业观察:纯前端岗位的窗口期正在收窄。要么前端基于 Node.js / TypeScript 往全栈和 AI 方向转,要么后端借助 AI Coding 来补前端。UP 主的看法是,前端转全栈缺的是服务端架构经验,而后端转前端在页面和复杂交互上往往吃力——「工具做出来的效果如何,最终取决于用的人」。
面试三段式:从认知到实现
课程把整套内容组织成三个递进的面试问题,很适合作为自我检验的框架。
初中级:工具认知
面试官会问「你对 AI 工具在前端 / 全栈编码方面的应用怎么看」。这一层考察的是对 Codex、Claude Code 等工具的场景理解和落地能力,属于认知层面。
中高级:架构与实现
往上一层,问题会变成「请说一说类似 Claude Code 这种通用型智能体的整体设计与实现」,具体展开就是 Agent Loop、Skills、多智能体协作怎么做。有些面试官换个问法,会问你有没有为团队设计过 Skills 或 MCP 来提效。
专家级:从零造一个
最难的一层是「让你开发一个类似 Claude Code 的通用型智能体,有没有思路」。到这一步,考察的已经不是 Claude Code 源码本身,而是你在真实业务里有没有通用型智能体的开发经验——能不能讲清实现方案与思路,并落地一个核心功能版本。
编程智能体的四大核心模块
课程明确了一个通用型编程智能体的四个关键模块,全部可以用 TypeScript 实现:
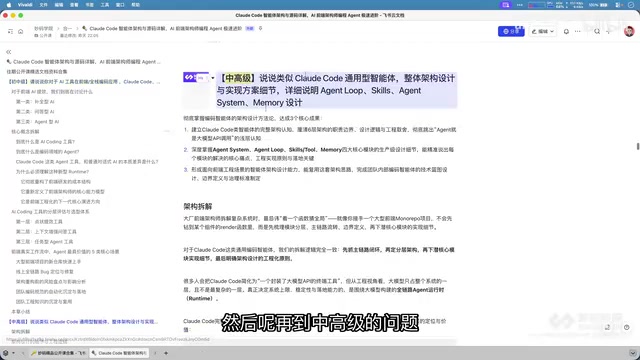
- Agent Loop(智能体循环):这是整个智能体的中枢。拿到用户提示词后,模型会判断需要调用什么工具,执行完再把结果喂回模型,进入下一轮,直到任务完成。
- Tool 工具系统:模型本身无法直接操作文件系统,所有读写、列目录等动作都必须通过工具调用(Tool Call)来完成。这是最小工具系统的核心。
- Skills 解析模块:负责解析和管理智能体可用的技能,让能力可以模块化扩展。
- Memory 记忆模块:文件化的记忆体系,进一步细分为会话记忆(短期记忆)、项目级记忆、团队与用户记忆,以及系统记忆等多个层级。
模型提供商这一层是可插拔的。演示中用的是本地部署的 Qwen3 系列小模型(约 9B 参数),通过 Ollama 提供服务;实际企业开发里则建议接入 Qwen3-Plus、GLM 或 MiniMax 等更大的模型,以保证工具调用和 JSON 解析的稳定性。
Agent Loop 的运作原理在学术上对应「ReAct」(Reasoning + Acting)框架:模型每一轮先推理(Thought),再决定执行哪个动作(Action),收到工具返回的观测结果(Observation)后进入下一轮推理,直到模型判断任务完成并输出最终答案。这个「思考→执行→观测→再思考」的循环是所有主流 Coding Agent(Devin、Cursor Agent、Claude Code)的共同骨架。理解了这一点,就能明白为什么有时候一个看似简单的指令会触发十几次工具调用——模型需要通过多轮反馈来逐步收窄信息缺口,而不是一次性获取所有上下文。
MCP(Model Context Protocol) 是 Anthropic 推出的开放协议,旨在标准化模型与外部工具/数据源之间的接口。Skills 解析模块与 MCP 关系密切:MCP Server 可以将文件系统、数据库、浏览器等能力封装成标准接口,智能体通过 MCP Client 动态发现并注册这些工具,而无需硬编码每一个工具的调用方式。这正是「能力可模块化扩展」的工程基础。
最小化实现的运行链路
课程演示了一个从 0 到 1 手写的 minimal Claude Code 项目,只实现最核心的部分,通过 npm run dev 启动后进入交互式聊天。
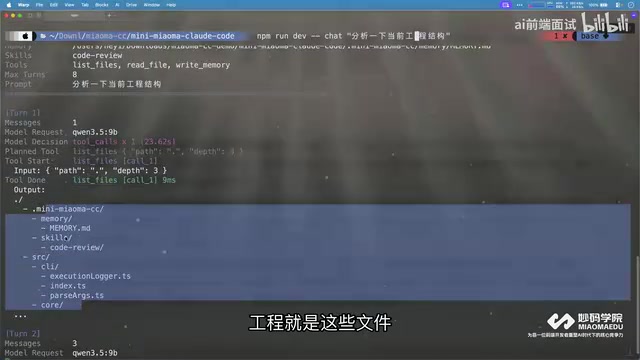
以「分析当前工程结构」这个指令为例,完整链路是这样跑起来的:
- 接收提示词:智能体拿到「分析当前工程」的请求。
- 进入 Agent Loop:模型判断需要什么工具,第一轮触发
list files,把当前目录下所有文件列出来。 - 信息读取:模型继续调用,读取各文件的基本信息。
- 汇总输出:最后生成一段总结,如果指令要求「记录结论」,还会尝试写入文档。
演示中也暴露了小模型的局限——9B 模型偶尔会出现参数解析失败、返回数据不稳定,或写入文档时报错的情况。UP 主坦言这是正常现象,换一个提示词或换更大的模型即可稳定。这恰好印证了工具系统对模型能力的依赖:Agent Loop 的健壮性,很大程度上取决于底层模型能否稳定地输出结构化的工具调用。
工具调用(Function Calling / Tool Call)是大语言模型能够驱动外部操作的关键机制。当模型返回的不是普通文本,而是一段包含函数名和参数的结构化 JSON 时,宿主程序(即 Agent Loop)会解析这段 JSON、在本地真正执行对应函数(如读文件、写文件),再把执行结果作为新消息追加到对话上下文中传回模型。这就是为什么 JSON 解析的稳定性直接决定 Agent 健壮性——小参数模型(如 9B)在输出格式上更容易出现截断或字段缺失,导致工具调用失败。企业级场景建议选用专门针对 Function Calling 做过对齐训练的模型,或在 Agent Loop 层增加重试与格式校验逻辑。
给前端工程师的落地建议
把这套内容压缩成一句话:先用熟工具,再看懂架构,最后能亲手实现一个最小版本。四大模块(Agent Loop、Tool、Skills、Memory)是理解任何编程智能体的通用地图,而 TypeScript 完全可以承载这套实现,这对前端和全栈背景的开发者尤其友好。
面对每天爆炸式的 AI 信息,与其焦虑,不如沿着「AI 提效 + AI Agent 开发」两条主线稳步积累。理解了 Claude Code 这类工具的内部机制,无论是面试还是实际业务落地,都会有底气得多。
相关推荐
HuggingFace开始内容审查?下架模型引发社区争议
HuggingFace下架一个标注「用于网络攻击」的去审查GLM模型,引发开源社区关于内容审查的争议。本文梳理事件始末,分析abliterated模型的敏感性,以及平台治理透明度这一真正痛点。
Cayu:构建长周期领域智能体的开源Python框架
Cayu 是一个用于构建领域专用、长周期 AI 智能体的开源 Python 框架。它让开发者围绕工具、知识与业务规则组装 harness,并提供集成的持久化运行时处理会话、状态、恢复、审批与可观测性。本文解析其核心思路与落地场景。
社交媒体真的在伤害青少年吗?一场悬而未决的科学争论
社会心理学家乔纳森·海特在《焦虑的一代》中将青少年心理健康下滑归咎于社交媒体,但这一论断在学术界引发分歧。本文探讨相关性与因果关系的争议,以及这场辩论对公共政策的现实意义。