长上下文失效真相:干扰竞争比长度更致命

长上下文检索失败的主因是干扰项注意力竞争,而非长度本身。
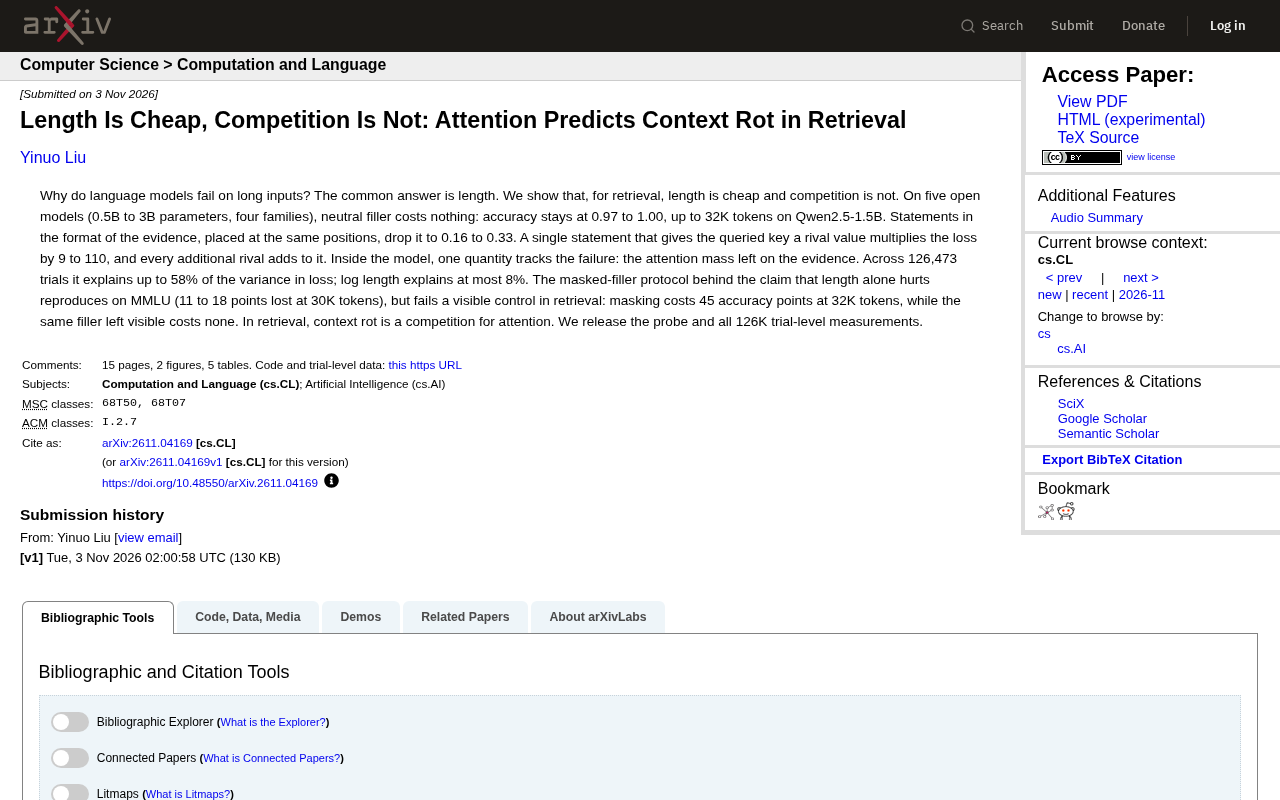
该研究挑战“长度导致长上下文失效”的直觉,在五个开源模型上系统测试检索任务。结果显示,用中性填充扩展上下文时准确率几乎不变(0.97-1.00),说明长度本身代价极低;但换成与证据同格式的干扰陈述后,准确率骤降至0.16-0.33,单条竞争陈述可使损失扩大9-110倍并逐条累积。机制层面,留在证据上的注意力质量最多解释58%的损失方差,而对数长度仅解释8%。研究还指出,屏蔽填充物的实验协议会引入额外干扰,可见填充下32K token损失为零。优化方向应从压缩长度转向减少候选冲突、监控注意力分配。
长上下文是大型语言模型(LLM)的核心能力,但模型为何在长输入上频频失手?多数人归咎于长度,而一项新研究提出了颠覆性观点:在检索任务中,长度本身代价很低,真正的杀手是干扰项之间的注意力竞争。
长度并非元凶:中性填充几乎无损精度
研究者在五个开源模型(参数从0.5B到3B,涵盖四个模型家族)上进行了系统测试。当上下文用中性填充文本(neutral filler)扩展时,模型的检索准确率几乎不受影响,保持在0.97到1.00之间,在Qwen2.5-1.5B上甚至能稳定维持到32K token。
这一结果直接挑战了“长上下文必然导致性能衰减”的直觉。过去常说的“上下文腐烂”(context rot)现象,在纯长度维度上并不成立——至少对于检索任务而言,模型对冗长但无竞争的上下文具有极强的鲁棒性。
竞争才是关键:同格式干扰项大幅拉低准确率
真正让模型“翻车”的是与证据格式相同的干扰陈述。当研究者把中性填充替换为与证据格式一致的陈述句,并放置在相同位置时,准确率骤降至0.16到0.33。这意味着,格式相似性触发了模型内部的混淆。
更严重的是,仅仅加入一条为查询键提供竞争性取值的陈述,就会让损失扩大9到110倍,而且每增加一条竞争陈述,损伤会进一步累积。这说明检索失败的本质不是“记不住”,而是“分不清”——模型在多个候选值之间发生了注意力争夺。
「同格式干扰项」指与正确证据在句式、字段结构或表述模板上高度相似、但取值不同的陈述。它们之所以危害更大,是因为模型在检索时往往依赖格式线索(如“X 的值是……”)定位答案,格式一致会使干扰项与证据在表示空间高度接近,注意力难以仅凭格式区分,只能在多个候选值之间竞争。这与随机中性填充形成鲜明对比:后者与证据格式差异大,不易被误认为候选答案。该现象也解释了为何 RAG 中重复或近重复的检索片段会显著拖累表现,而去重与重排序能直接缓解竞争。
注意力质量:解释力远超长度
研究者进一步深入模型内部,发现一个关键指标能够追踪失败:留在证据上的注意力质量(attention mass)。在126,473次试验中,该指标最多能解释58%的损失方差,而对数长度最多只能解释8%。
这为“竞争假说”提供了机制层面的证据。模型并非因为序列太长而丢失信息,而是因为竞争项分流了本应集中在证据上的注意力。注意力分配的质量,而非上下文窗口的物理长度,决定了检索成败。
「注意力质量(attention mass)」指模型在做预测时,分配给输入序列中特定位置(如证据片段)的注意力权重总和占全部注意力权重的比例。它衡量的是注意力“集中在哪里”,而非“窗口有多长”。在检索式任务中,若模型把大部分注意力分配给正确证据,则该指标高;若注意力被众多格式相似的干扰项分流,则该指标低。研究者通过在推理时读取各层注意力图并聚合到证据 token 上得到该值,再与最终答对与否做回归分析,从而量化其解释力。这一指标比输入长度更贴近失败机制,因此可作为长上下文系统的运行时监控信号。
屏蔽填充物的实验陷阱
此前一些研究通过“屏蔽填充物”(masked filler)方案得出“长度本身有害”的结论,但新研究指出这一协议存在缺陷。在MMLU基准上,屏蔽填充物确实能复现长度带来的11到18个百分点的性能下降(30K token时)。
然而在检索任务中,一个可见的对照实验揭示了问题:当填充物被屏蔽时,32K token下准确率损失高达45个百分点;而同样的填充物保持可见时,损失为零。这说明屏蔽操作本身引入了额外干扰,而非长度在起作用。
「屏蔽填充物(masked filler)」是长上下文评测中的一种常见协议:为控制长度变量,研究者把无关填充文本替换为特殊占位符或直接屏蔽,使模型看不到这些内容。其初衷是排除填充语义的干扰,但新研究指出,屏蔽操作本身会改变输入分布——特殊 token 或空缺位置可能被模型当作异常信号,诱发额外的注意力竞争或分布外行为。于是测得的性能下降被误归因于长度,实则是协议伪影。对照实验(同一批填充物可见与屏蔽两种条件)正是为分离这一混淆而设计,结果显示可见中性填充下长度几乎无损,屏蔽时损失才大幅出现。
对长上下文优化的启示
这项研究对RAG系统和长文档问答有直接指导意义。如果竞争是主要矛盾,那么优化方向应从“压缩长度”转向“减少候选冲突”。例如,在检索增强生成中,可以通过重排序或去重来降低同格式干扰项的数量;在提示设计上,避免让无关但格式相似的陈述与证据混排。
研究者开源了探针和全部126K条试验级测量数据,为后续复现和扩展提供了基础。对于构建长上下文应用的团队而言,一个可操作的检查项是:监控模型对证据的注意力质量,而不仅仅关注输入长度或召回率。
结语:重新定义“上下文腐烂”
“长度是廉价的,竞争不是。”这项研究用多模型、多任务的证据链条,将长上下文失效的归因从长度转向注意力竞争。对于追求更长上下文窗口的行业趋势而言,这提醒我们:窗口大小只是入场券,如何管理窗口内的竞争关系,才是决定模型实际表现的关键。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。