超图支配集:一种新颖的抽取式文本摘要方法
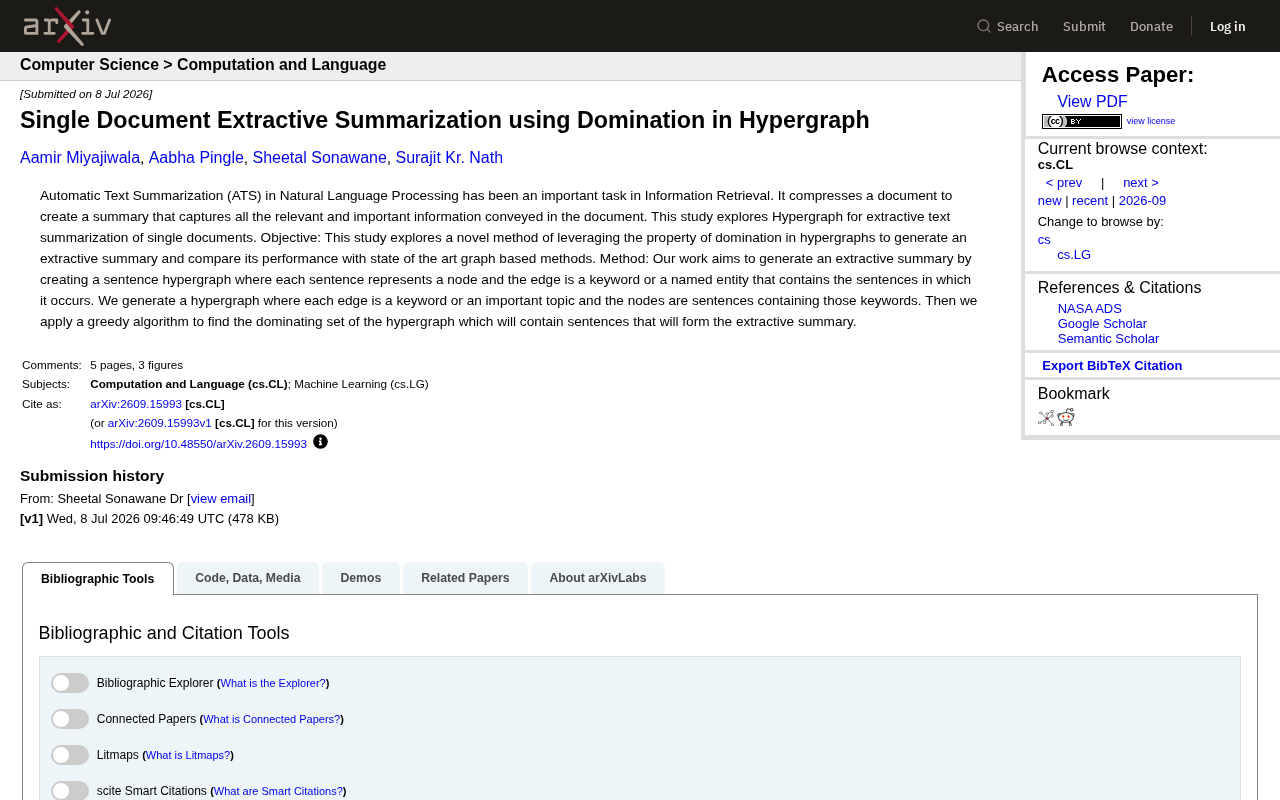
利用超图支配集理论,以关键词为超边连接句子,贪心选句构建可解释的抽取式摘要。
这项研究将图论中的超图与支配集概念引入单文档抽取式摘要任务。不同于 TextRank 等传统方法依赖句子间的成对相似度,该方法以文档句子为节点、关键词和命名实体为超边,构建能刻画多元主题关联的句子超图。随后通过贪心算法求解超图支配集,所选出的句子集合能够覆盖全文所有关键主题,从而在全面性与去冗余之间取得平衡。该方法无需大规模训练、可解释性强且不产生幻觉,在高可靠、低算力的文档处理场景中具有实用价值,也为将高阶语义结构融入摘要建模提供了新的理论视角。
自动文本摘要(Automatic Text Summarization, ATS)一直是自然语言处理与信息检索领域的核心任务之一。它的目标是将一篇冗长的文档压缩为一段简短的摘要,同时保留原文中所有相关且重要的信息。近期一篇发表于 arXiv 的研究提出了一种颇具新意的思路——利用超图(Hypergraph)中的支配(Domination)性质来完成单文档的抽取式摘要,并与当前主流的基于图的方法进行对比。
从普通图到超图:建模思路的升级
传统基于图的摘要方法(如 TextRank、LexRank)通常将句子视为节点,句子之间的相似度作为边,通过图的中心性算法挑选出最重要的句子。这类方法的局限在于,边只能表达两个句子之间的成对关系(pairwise relation),难以刻画多个句子围绕同一主题聚集的高阶关联。
超图的引入正是为了解决这一问题。在数学定义上,超图的一条边(超边,hyperedge)可以同时连接任意数量的节点,而不仅仅是两个。这种结构天然适合表达“多个句子共享同一关键词或话题”这类多元关系,从而在语义建模层面比普通图更为丰富。
TextRank 和 LexRank 是两种经典的无监督抽取式摘要方法。TextRank 借鉴 PageRank 算法,将句子视为节点,以句子间词汇重叠度构建有向图,再通过迭代计算节点的"投票权重"来排序句子;LexRank 则以 TF-IDF 余弦相似度构建无向图,用谱图的中心性(spectral centrality)来衡量句子重要性。两者的核心假设都是:被更多相似句子"指向"的句子越重要。这种成对相似度建模的缺陷在于,它只能捕捉两两句子之间的直接关联,当一个话题散布于多个不直接相似但都围绕同一关键词的句子中时,成对图无法将它们统一组织,而超图的超边结构则可以天然地将这些句子同时纳入同一条边,从而显式地刻画出话题的多路辐射关系。
句子超图的构建方式
该研究的核心方法是构建一个句子超图:文档中的每个句子作为一个节点,而每一条超边则对应一个关键词(keyword)或命名实体(named entity)。具体来说,某个关键词所对应的超边,会把所有包含该关键词的句子连接在一起。
换句话说,如果一个重要话题在多个句子中反复出现,这些句子就会被同一条超边“捆绑”起来。这样构建出的超图,本质上是把文档的主题结构显式地编码进了图的拓扑关系之中——关键词与命名实体成为组织句子的骨架,而句子则围绕这些主题聚集成群。
支配集:贪心算法挑选摘要句
方法的关键落点在于**支配集(Dominating Set)**这一图论概念。在图论中,一个支配集是指这样一组节点:图中任意一个节点,要么本身属于该集合,要么与集合中的某个节点相邻。直观地讲,支配集是一组能够“覆盖”整张图的代表性节点。
研究者将这一思想迁移到摘要任务中:通过一个**贪心算法(greedy algorithm)**在句子超图上求解支配集,得到的支配集所包含的句子就构成了最终的抽取式摘要。这样做的逻辑非常自然——支配集中的句子能够覆盖文档中的所有关键主题(超边),因此理论上它们所组成的摘要能够较为全面地捕捉原文的重要信息,同时避免冗余。
求解最小支配集(Minimum Dominating Set, MDS)在一般图上是 NP-难问题,因此实际应用中通常采用贪心近似策略:每一轮选择当前能"覆盖"最多未覆盖节点的节点加入集合,直到所有节点均被覆盖为止。这种贪心方法可以保证在多项式时间内完成,且理论上其解的大小不超过最优解的 O(ln n) 倍(n 为节点数)。在超图场景下,"覆盖"的含义被推广为:一个节点被覆盖,当且仅当它自身在支配集中,或与支配集中某节点共享至少一条超边。这样,贪心算法每一步优先选择参与超边数量最多的句子节点,实质上等同于优先选择涉及最多关键主题的句子,与"主题覆盖最大化"的摘要目标直接对齐。
方法的价值与局限
这项研究的意义在于,它把超图支配理论这一相对抽象的数学工具,与文本摘要这一实际 NLP 任务结合了起来,提供了一个有别于主流句子相似度图的建模视角。用关键词和命名实体作为超边,使得“主题覆盖”成为选句的显式目标,这与摘要任务“全面且不冗余”的本质诉求高度契合。
不过,从摘要中可获取的信息来看,该方法仍有若干值得关注的问题。其一,关键词和命名实体的抽取质量将直接决定超图结构的好坏,若关键词识别不准,整个超图的语义骨架便会失真。其二,贪心算法求解支配集虽然效率较高,但通常只能得到近似最优解,摘要的最终质量取决于贪心策略的具体设计。其三,抽取式摘要本身受限于原文句子,无法像生成式摘要那样进行语言重组与压缩。
在大模型时代的定位
在生成式大语言模型盛行的当下,这类基于图论的传统抽取式方法看似“古典”,但仍有其独特价值:它无需大规模训练、可解释性强、计算成本低,且不存在“幻觉”问题——摘要中的每一句话都真实来自原文。对于需要高可靠性、低算力开销的信息检索与文档处理场景,这类结构化方法依然是值得研究的方向。超图支配这一思路,也为后续将高阶语义关系融入摘要建模提供了有益的探索。
相关推荐
Ollama 入门指南:本地部署开源大模型的利器
Ollama 是一款免费开源的本地大模型管理工具,支持将 DeepSeek 等开源模型部署到本地。本文介绍 Ollama 是什么、跨平台特性、CPU/GPU 支持及本地部署的应用场景,适合零基础入门 AI 大模型开发。
LM Studio、Ollama、vLLM深度对比:本地大模型部署工具怎么选
LM Studio、Ollama、vLLM三款本地大模型部署工具深度对比。从上手难度、适用场景到性能表现全面解析:小白选LM Studio,开发者用Ollama,企业级高并发上vLLM,帮你快速选对工具。
Ollama入门:本地部署开源大模型的核心工具解析
本文详解 Ollama 是什么及其核心价值:作为一款开源免费的大模型管理工具,它能将 DeepSeek 等开源模型部署到本地,支持 GPU/CPU 灵活调度、跨平台运行,并提供 API 与命令行接口,适合搭建私有知识库等场景。