ChatBI企业级实战:用LangGraph与Multi-MCP打造去中心化数据分析智能体
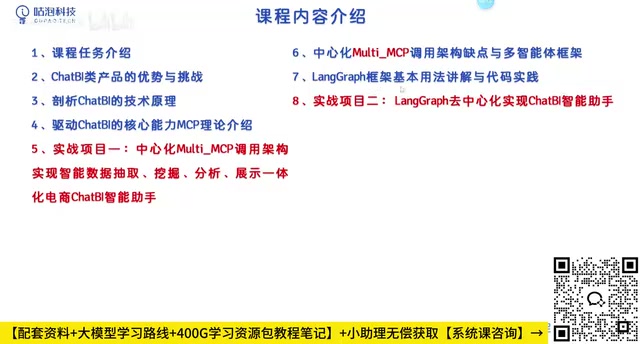
用LangGraph去中心化多智能体架构构建ChatBI,将企业数据分析从三级人工流程压缩为自然语言一键直达。
本文介绍了B站UP主威斯利基于Multi-MCP与LangGraph构建企业级ChatBI(对话式商业智能)智能体的完整方案。传统企业数据分析依赖"需求方→分析师→建模工程师"的三级链路,存在需求反复、协作耗时、低频需求浪费人效等顽疾。ChatBI通过语义理解分流、NL2SQL自动取数、NL2Python建模预测,将整条链路压缩为自然语言输入即得结果的自主化系统。技术路线上,课程先以Multi-MCP中心化调度快速原型验证,再以LangGraph去中心化多智能体架构重构,解决稳定性与可扩展性问题,并可无限融入RAG等新能力模块。核心工程理念是识别智能体能力边界,标准化任务自动化、复杂场景路由人工兜底,实现务实可落地的人机协同。
ChatBI:让数据分析回归“提需求即得结果”
在企业级大模型应用落地的浪潮中,ChatBI(对话式商业智能)是一个既有想象空间、又充满工程挑战的方向。B站UP主威斯利在其大模型企业级实战教程中,用一套完整案例拆解了如何从零构建一款ChatBI智能体——核心技术栈锁定当下两大热门方向:Multi-MCP(多模型上下文协议)与企业级智能体框架 LangGraph。
作者拥有UCLA数学系硕士背景与八年AI从业经验,研究方向覆盖智能客服、推荐系统与大模型智能体。他坦言,ChatBI类应用在市场上并不常见,各大平台虽有布局却鲜少大力宣传,这背后恰恰说明该方向存在真实的工程挑战。理解这类智能体的能力边界——哪些场景适合、哪些场景难以处理——比盲目堆砌功能更重要。
传统数据看板与三级分析流程的痛点
要理解ChatBI的价值,先得看清它要替代的是什么。作者以企业常见的数据展板举例:这类看板美观、适合对外展示、适合固定业务结构,但缺点也非常明显——每增加一列指标、每换一种呈现方式,都要重新走一遍开发流程,无法满足个性化和动态查询需求。想看“不含订单编号的数据”或“平均完成时长”,固定展板往往力不从心,只能手工导出再计算。
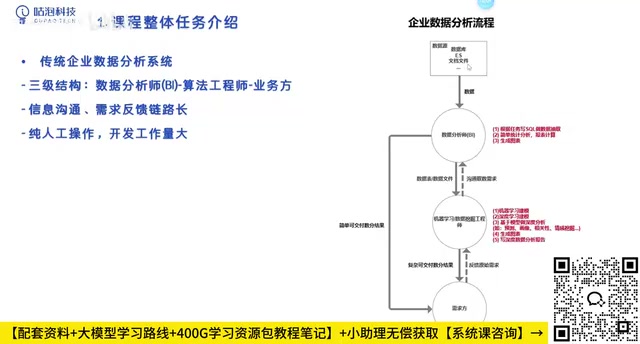
更深层的问题出在传统企业的三级数据分析流程上。需求方(运营或老板)提出需求,产品经理或数据分析师承接并从数据库、ES库或Excel文档中取数计算,遇到销量预测这类问题还需交给机器学习工程师做二次建模。作者点出这套链路的三大顽疾:
- 需求难以一次说清:需求方拿到结果后常要改需求,逆向反馈层层回传,同一链路来回走好几遍;
- 多人协作耗时长:一份分析要经过多人之手,交付周期被拉长;
- 低频需求浪费人效:像“今年双十一对比去年销量”这类临时性、低使用频率的需求,专门安排人力开发后只看一眼,性价比极低。
ChatBI的核心链路:从语义理解到智能总结
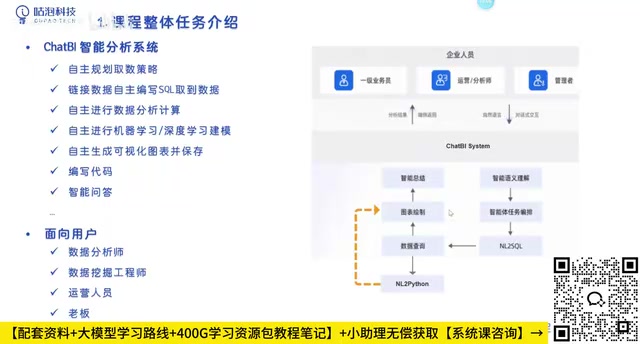
ChatBI系统的设计思路,是把三级流程压缩成一套“只需提需求”的自主化系统。不论业务员、运营分析师还是建模工程师,都以自然语言输入需求,例如“帮我预测某商品未来三个月的销量”。
系统的第一道关卡是语义理解模块,它承担业务分流的职责:闲聊交给自由生成,画图交给绘图智能体,数据分析交给数据分析智能体。通过预先编排的智能体流程图,需求被路由到对应的下游节点处理。
对于数据分析类需求,链路的关键环节是 NL2SQL——将自然语言转为SQL语句抽取数据,这正是数据分析师取数职能的自动化。取到数据后,简单需求可直接生成报表、文档或一句话回复;复杂需求如销量预测,则进入 NL2Python 环节,通过机器学习或深度学习算法基于历史数据构建预测模型,运行后再绘制图表、生成智能总结返还用户。
作者强调,整套系统是“高度灵活的自主化决策链路”:它会自行判断是否需要取数、是否需要建模、当前数据是否已足以回答问题,最终以图表、文档或文字等多种形式输出。
NL2SQL(Natural Language to SQL) 是将用户自然语言描述转换为可执行SQL查询语句的技术,是ChatBI系统的核心能力之一。实现难点在于:模型需要理解业务语义(如"双十一"对应具体日期范围)、正确映射表名与字段名(依赖Schema注入),并处理多表联查、聚合函数、条件过滤等复杂SQL结构。企业落地时通常需要将数据库Schema、字段注释、常见业务词汇表等作为上下文注入Prompt,或通过RAG检索相关Schema片段来提升生成准确率。NL2SQL的准确率直接决定ChatBI的可用性,也是该方向落地难度较高的核心工程挑战所在。
NL2Python 则进一步将自然语言需求转化为Python数据分析或机器学习代码,适用于SQL无法完成的预测建模、统计分析等场景。生成的代码通常在沙箱环境中执行,结果再传回主流程用于图表生成和总结输出,安全隔离是工程实现的重要考量。
从Multi-MCP中心化到LangGraph去中心化
课程的技术演进路线颇有教学价值。作者先用传统的 Multi-MCP + 大模型中心化调度 方式实现一个简易数据分析智能体。这种方案代码量少、搭建简单,能快速跑通,但缺陷同样突出:稳定性差、可扩展性弱。当以大模型作为唯一中心调度者去协调多个MCP工具时,一旦工具调用数量过多,模型容易“反应不过来”,出现调度混乱。
针对这一痛点,课程的核心落点是引入 LangGraph + 去中心化架构 来重构ChatBI。相比中心化方案,去中心化的多智能体框架在稳定性和可扩展性上都有极大提升。作者特别指出,LangGraph框架的一大优势是可以“无限融入”新功能——不仅限于数据分析,还能挂载RAG检索增强模块:当系统检测到用户提出专业领域问题时,路由到RAG智能体完成检索增强再生成答案。
这意味着ChatBI的“BI”只是切入点,其底层架构本质上是一套可无限扩展的企业级智能体平台。
MCP(Model Context Protocol,模型上下文协议) 是由 Anthropic 于2024年底提出的开放标准,旨在为大模型提供统一的工具调用接口。开发者可以将数据库查询、文件操作、API调用等能力封装成MCP服务,大模型通过协议统一发现并调用这些工具,无需为每种工具单独适配。Multi-MCP即同时挂载多个此类服务。中心化调度模式下,大模型既是"大脑"又是"调度中枢",需要在单次推理中规划工具调用顺序、解析返回值并决定下一步行动。当工具数量增加、调用链变长时,模型的上下文窗口压力和推理复杂度都会急剧上升,容易出现工具调用顺序错乱或中途"忘记"任务目标的问题,这正是中心化方案稳定性弱的根本原因。
LangGraph 是 LangChain 生态中专为构建有状态多智能体工作流设计的框架,采用有向图(DAG/循环图)对智能体协作流程进行显式编排。每个节点代表一个独立智能体或处理步骤,边代表数据流与控制流,路由逻辑由代码而非模型推理决定。这种"去中心化"设计将调度职责从单一模型分散到图结构本身,每个智能体只需专注自身子任务,系统整体的可预测性和容错性因此大幅提升。
谁该关注这套架构
这套ChatBI系统面向的群体相当广泛:数据分析师、数据挖掘工程师可以用它提效,运营人员和管理者则能直接以自然语言获取分析结果,无需再走冗长的需求传递链路。
对于正在探索大模型落地的团队,这个案例提供了一条清晰的工程化思路:扬长避短,识别智能体的能力边界。适合自动化的高频、标准化任务交给ChatBI,难以处理的复杂场景则通过路由到人工来兜底,实现人机协同。这种务实的“工程化理念”,或许比追求全自动的宏大叙事更贴近企业真实需求。
RAG(Retrieval-Augmented Generation,检索增强生成)是指在大模型生成回答前,先从外部知识库检索相关文档片段并注入上下文,从而让模型能够回答训练数据之外的私有或实时知识。在ChatBI架构中,RAG模块可以承接专业领域的政策查询、产品说明、历史报告等非结构化内容的问答需求——这类需求无法用SQL从数据库取数,却可以从文档库中检索。将RAG作为独立智能体节点挂入LangGraph工作流,体现了去中心化架构"按需扩展功能模块"的设计哲学:新能力的加入只需增加图节点和路由条件,无需重构已有链路,系统复杂度的增长是线性可控的。
小结
威斯利这套ChatBI教程的价值,不在于炫技,而在于把一个真实的企业痛点(三级数据分析流程的低效)与两项前沿技术(Multi-MCP、LangGraph)串联成完整的工程方案。从中心化调度的简易实现,到去中心化多智能体架构的稳定升级,路径清晰、层层递进,对希望将LangGraph、MCP、RAG、NL2SQL等技术真正落地的开发者具有较强的参考意义。
相关推荐
n8n零代码搭建AI员工:一人公司全自动朋友圈内容工作流
B站UP主原子分享用n8n零代码搭建AI员工"文书",串联大模型、飞书多维表格与微信接口,实现朋友圈文案的灵感采集、一鱼多吃与全自动分发,一人公司10分钟搞定一周内容分发。
n8n:可自托管的AI工作流自动化平台深度解析
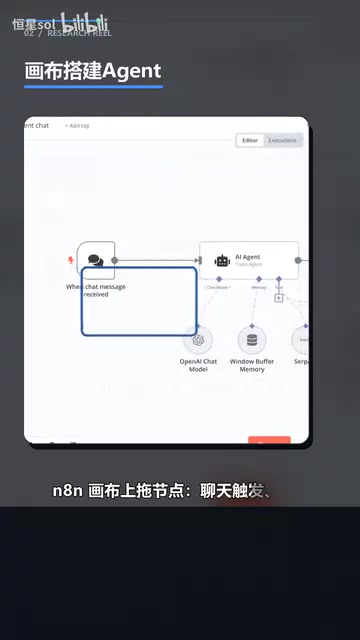
n8n是一款可自托管的AI工作流自动化平台,支持可视化节点搭建、JS/Python自定义代码、1500多个集成和9000多个模板。本文解析其低代码理念、开源生态与自托管优势,帮助团队摆脱单一AI厂商绑定。
手把手教你用n8n搭建AI股票研究Agent
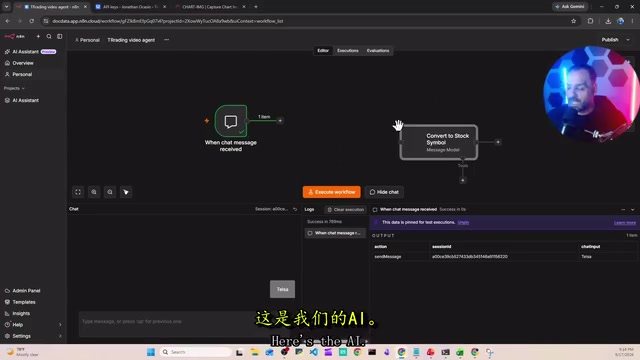
海外博主用n8n工作流搭建AI股票研究Agent,输入股票代码即可自动拉取行情、分析新闻情绪并输出买卖建议与信心评分。本文详解其完整架构与节点设计,包含Twelve Data免费API接入与成本优化技巧。