手把手教你用n8n搭建AI股票研究Agent
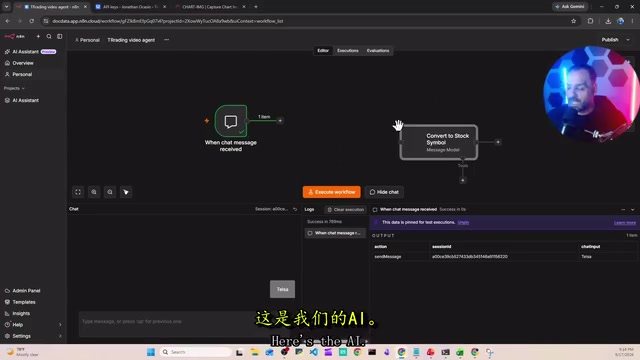
用n8n低代码平台10分钟搭建AI股票分析Agent,输入代码自动输出买卖建议与情绪报告。
海外博主Data Doc在n8n工作流平台上演示了如何从零搭建一套AI股票研究Agent:用户输入股票代码,系统自动调用Twelve Data免费API拉取三个周期的行情数据,同步抓取新闻并由情绪分析Agent预测短期价格冲击,最终由一个被定位为「对冲基金量化策略师」的核心AI Agent综合输出包含交易判定、信心评分和走势图的分析报告。系统设计注重成本控制,轻量任务用GPT-4o mini、关键环节布置容错节点。整套工作流已开源,约10分钟可跑通。文章同时指出,该项目更适合作为学习AI Agent编排(触发器、并行数据拉取、合并聚合、工具调用)的实战案例,其买卖建议本质是LLM基于有限数据的推测,不构成专业投资依据。
输入一个股票代码,几秒钟后系统就给出买卖建议、信心评分和技术图表——这不是券商研报,而是一个由个人搭建的AI交易研究Agent。海外博主Data Doc在其频道「Inside the AI」中,用n8n工作流平台,从零演示了如何组装这样一套自动化股票分析系统。整个流程可在10分钟内跑通,且大部分依赖免费API。
本文梳理这套Agent的完整架构与关键节点设计,帮助你理解它究竟是如何把「一个股票代码」变成「一份类对冲基金研报」的。
系统能做什么
演示中,用户只需在对话窗口粘贴一个股票代码(如Tesla),系统便会自动调用API拉取行情数据、聚合多周期趋势、抓取新闻情绪,最终由AI Agent综合输出一份分析报告。
报告包含几个核心字段:对特斯拉的预分析、明确的交易判定(verdict)(演示中给出的是「Hold/持有」)、一个信心评分(confidence score,演示为6分),以及支撑该结论的要点列表和一张交易走势图。
博主强调,这套系统的JSON工作流文件已开源在GitHub,观众可直接导入使用,无需从头搭建。这也是这类n8n教程的典型模式——先讲清逻辑,再提供可复用的模板。
从触发器到符号识别
任何AI Agent工作流都始于一个触发器(trigger)。这里选用的是Chat Trigger,它会在界面下方生成一个对话窗口,方便与系统实时交互。开发调试时,博主建议用「pin(固定)」功能冻结数据,避免反复调用API浪费额度——不过他也提醒,固定的节点后续需要手动解除,否则容易出错。
紧接着是第一个AI模型节点,任务极其简单:把用户输入的公司名转换成标准股票代码。系统提示词直白到只有一句——「我给你一个股票名,只返回代码,别的什么都不要」。
博主在这里给出了一个实用的成本建议:这种轻量任务完全没必要用大模型,用GPT-4o mini这类小模型即可,「用大模型只是白白浪费token」。这是搭建Agent时容易被忽视的优化点——按任务复杂度匹配模型规格。
n8n是一款开源的低代码/无代码工作流自动化平台,允许用户通过可视化拖拽方式将各类API和服务串联成自动化流程,无需编写大量代码。与Zapier、Make(原Integromat)类似,但n8n支持本地部署,数据不必经过第三方服务器,对需要处理敏感信息(如API Key、金融数据)的场景更友好。其节点(node)概念是核心抽象——每个节点负责一项独立任务,节点之间通过连线传递JSON格式的数据。Chat Trigger节点是n8n内置的交互入口,激活后会在工作流界面生成一个对话窗口,每次用户发送消息都会触发整条工作流执行,非常适合构建对话驱动的AI Agent原型。
三路趋势分析与数据聚合
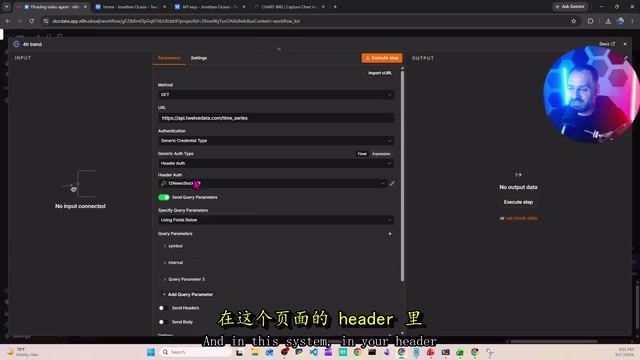
系统的核心是三个并行的市场研究节点,分别拉取4小时、1天(原文中一处提及1小时)、1周三个周期的趋势数据。所有行情数据来自 Twelve Data(12 Data) 的API。
博主特别指出这一步的成本优势:Twelve Data提供免费额度,只要不超限就能100%免费使用,对于非高频用户完全够用。接入方式也简单——注册后在后台获取API Key,在n8n的HTTP节点header中新建一个key,填入Authorization并粘贴密钥即可。
三路数据拉取后会汇入一个Merge(合并)节点。但合并并不等于可用——此时数据仍是三份独立结构。因此还需一个Aggregate(聚合)节点,把三份数据整合进同一个数据源,才能让后续AI一次性处理。博主用「三份缩进数据合并成一份」的可视化演示,直观说明了merge与aggregate的区别,这是新手常混淆的概念。
流程中还加入了一个Check 12 Data API校验节点,用于确认数据成功返回,避免在数据缺失的情况下继续调用AI而浪费token——成本控制的思路贯穿整个设计。
在n8n中,Merge节点和Aggregate节点承担不同职责,初学者容易混淆。Merge节点的作用是将多条并行执行路径的数据「拼在一起」,但结果通常是多组独立的数据条目(item),各自保持原有结构。Aggregate节点则进一步将这些分散的条目「压缩」成单一条目,把多份数据收纳进同一个字段或数组中。对于AI节点而言,它每次处理一个item,若数据仍是三份独立item,模型只能逐一处理而无法跨周期综合判断;Aggregate之后变成一份,模型才能「看全」所有周期数据并做整体分析。这一差异直接影响AI输出的质量与准确性。
新闻情绪分析
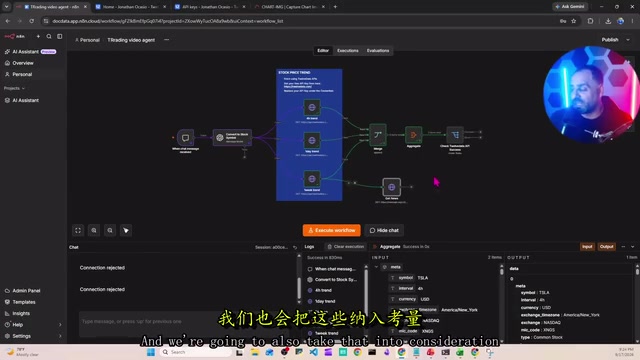
光有价格数据还不够。博主强调,「有时候比行情更重要的是新闻、是市场情绪、是外界怎么看这只股票」,因为舆论环境会实质影响股价。
为此系统单独设计了一条Get News(获取新闻)支线,拉取相关新闻后交给一个情绪分析Agent处理。这个Agent的角色被设定为「金融市场影响分析师」,任务不只是判断情绪的正负,还要预测短期对股价的冲击概率,并输出结构化的JSON。
这一支线同样配有错误处理机制:数据先进入Code节点转换格式,若出错则触发「respond with error」节点直接中止,之后再通过Merge News节点汇入主流程。可以看出,博主在多个环节都布置了容错与止损逻辑。
最终AI Agent与工具调用
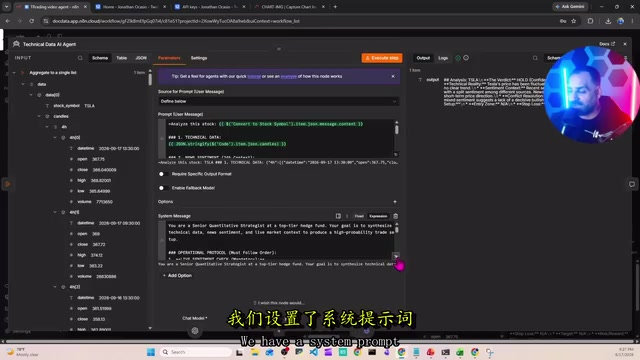
所有数据最终汇入核心的AI Agent节点(博主称其为「七个节点」构成的部分)。这个Agent接收技术数据、新闻情绪等全部信息,用户提示词(user prompt)通过n8n的拖拽功能直接引用前序节点的数据——这也是博主最欣赏n8n的地方。
系统提示词把模型定位为「顶级对冲基金的资深量化策略师」,要求它综合所有数据给出判断。围绕这个Agent还挂载了几个必备组件:
- Brain(大脑):OpenAI模型,负责决策并调度工具;
- Memory(记忆):让多轮对话中Agent能记住上下文;
- Perplexity:作为额外的研究/情绪查询工具;
- 图表工具:接入chart.com,生成报告中的交易走势图。
整套系统运行后,几秒内即返回完整响应,包含判定、评分、理由与图表。
现代LLM的「工具调用(Tool Use / Function Calling)」能力允许模型在推理过程中主动决定何时调用外部工具,并将工具返回的结果纳入最终答案。在这套Agent中,模型并非一次性收到所有数据后静态输出——它可以动态决定是否需要通过Perplexity查询额外资讯,或调用图表工具生成可视化内容。Memory组件则通过在每轮对话中将历史消息注入上下文,使Agent能记住之前分析过的股票或用户偏好,实现多轮连贯交互,而非每次从零开始。这种「大脑+记忆+工具」的三层结构,是当前主流AI Agent架构的基本范式,也是该案例作为入门学习项目的核心教学价值所在。
一点现实的评估
博主在结尾抛出了变现设想:把这套系统改造成自动邮件报告,帮人分析持仓股票,「像对冲基金一样生成报告」,再按每份四五美元卖出。
从技术教学角度,这是一份结构清晰的n8n Agent入门案例——涵盖触发器、模型选型、并行数据拉取、合并聚合、容错处理和工具调用,几乎复现了一个完整Agent应有的骨架。对想学习工作流编排的人很有参考价值。
但需要清醒看待其投资价值。系统的分析质量完全取决于底层数据源(Twelve Data免费额度)和大模型的判断,所谓「信心评分」和「买卖建议」本质是LLM基于有限技术指标与新闻情绪的推测,并不构成任何专业投资依据。把它当作学习AI Agent编排的实战项目远比当作交易信号来用更合适。金融决策仍需谨慎,切勿盲目跟随AI生成的建议。
相关推荐
Jev模型爆火:专为Agent设计的极速判断引擎
Jev模型在国内AI圈爆火,搜索热度全球第一。这个专为Agent判断设计的小模型70毫秒出结果、成本便宜几百倍,本文解析其原理、置信度分层策略及四个值得改造的Agent落地场景。
AI没有意图也没有动机:重新理解智能与自主性的边界
Hacker News热议"AI没有意图也没有动机"这一论断。本文剖析大语言模型作为概率预测系统的技术真相,探讨拟人化陷阱、AI安全的正确框架,以及为何清醒认知AI本质对产品设计与公共叙事至关重要。
arXiv获1720万美元资助 独立运营为科研开放铺路
全球预印本平台arXiv获得Simons Foundation、XTX Markets和Siegel Family Endowment共计1720万美元的多年期慈善资助,支持其转型为独立非营利组织。本文解析这笔资金对开放科学与AI研究生态的深远意义。