Cherry Studio+MCP搭建自动化AI智能体与本地知识库实战
Cherry Studio 结合 MCP 与 Ollama,20 分钟搭出可执行任务、可私密检索的桌面 AI 工作流。
文章基于 B 站教程,完整梳理了在 Cherry Studio 中接入 MCP 与 Ollama 的实操路径。工具选型上,Cherry Studio 因开源跨平台并支持 MCP,从聊天前端升级为智能体宿主;MCP 则像 USB 接口一样标准化外部工具接入。流程分五步:配置支持函数调用的对话模型(R1 不可用需换 V3)、在客户端内安装内置 UV 与 Bun 运行时、通过快速创建或 JSON 导入添加文件系统/网页抓取/Shell 等 MCP Server 并手动激活、用 Ollama 部署 qwen3:0.6b 与 bge-m3 嵌入模型、建立本地知识库并验证检索生效。三个实战场景检验了抓取转 CSV、搜索生成报告与执行 Shell 命令的能力,同时提示 Shell 权限风险与关闭 MCP 省 token 的习惯。整体门槛集中在环境安装,适合重视隐私与成本的用户。
Cherry Studio 近期加入了对 MCP(Model Context Protocol)的支持,配合本地模型部署工具 Ollama,普通用户也能在桌面上搭出一套既能自动执行任务、又能私密检索个人文档的 AI 工作流。B站 UP 主「有手就行」发布的实战教程完整演示了从模型配置、MCP 服务器安装到本地知识库搭建的全过程,整条链路在 Windows 上约 20 分钟即可跑通。本文基于该视频内容,梳理关键步骤与值得注意的坑点。
工具选型:为什么是 Cherry Studio + MCP
Cherry Studio 是一款开源免费的 AI 桌面客户端,支持 Windows、Mac 和 Linux,跨平台可用。它本身是一个多模型聚合的对话前端,而最新版本引入 MCP 支持后,角色发生了变化:从「聊天窗口」升级为「能调用外部工具的智能体宿主」。
MCP 由 Anthropic 推出,定位是为大模型提供标准化的外部数据与工具连接方式。UP 主用了一个贴切的比喻——MCP 像 USB 接口,让 AI 以统一协议访问文件系统、网页抓取、命令行等资源,而不需要为每个工具单独写适配代码。实际体验中,这种「搭积木」式的扩展方式让非开发者也能按需拼装助手能力。
函数调用(Function Calling) 是大模型的一项关键能力:模型在对话中不直接回复文本,而是输出结构化的调用请求(如「调用 file_system.write,参数为路径和内容」),由宿主程序真正执行后再把结果回传给模型。MCP 服务器本质上就是被调用的外部工具,因此宿主客户端必须依赖模型的函数调用能力来触发它们。DeepSeek广告 R1 属于推理模型,设计上专注长链思考而非工具调度,未开放 Function Calling,所以在本流程中会出现「思考很久但无法执行」的现象;而 V3 是通用对话模型,原生支持工具调用,这也是作者建议主模型选 V3 的原因。
第一步:配置对话模型
安装完成后进入设置页配置模型。视频中演示了两条路线:默认的硅基流动服务注册后可获赠 2000 万 token,适合零成本起步;作者则切换到 DeepSeek,在开放平台创建 API Key 后粘贴回 Cherry Studio,点击「检测」分别验证 DeepSeek Chat(V3)与 DeepSeek Reasoner(R1)的连通性。
这一步有一个容易被忽略的前提:R1 模型不支持函数调用(Function Calling),而 Cherry Studio 正是依赖该能力来触发 MCP 服务器。视频中作者让 R1 在本地创建 txt 文件,等待许久后报错,换成 V3 才顺利在指定目录写入 hello.txt。如果你打算用 MCP,主模型选 V3 或同级别支持工具调用的模型。
第二步:安装 MCP 运行环境
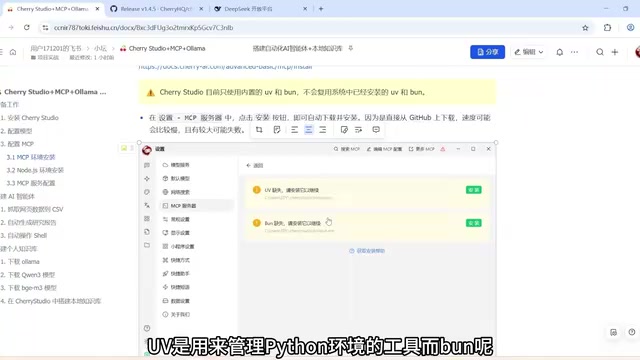
大部分 MCP Server 用 Python 或 TypeScript 编写,因此需要两个运行时:UV 管理 Python 环境,Bun 运行 JavaScript/TypeScript 应用。
这里有个官方设计上的细节:Cherry Studio 只使用内置的 UV 和 Bun,不复用系统已安装的版本。即便你电脑里已有,也必须在客户端内重新安装。安装包从 GitHub 下载,网络不畅时容易失败,视频作者的做法是手动下载三个文件放到指定路径,具体位置可参照官方文档。装完记得重启客户端才会生效。
此外还需安装 Node.js 最新稳定版,并在命令行用 node -v、npm -v 验证版本号正常输出。
UV 与 Bun 分别是 Python 和 JavaScript/TypeScript 生态中的新一代运行时与包管理器。UV 由 Astral 团队用 Rust 编写,替代 pip/venv,安装依赖速度远快于传统方案;Bun 则是集运行时、包管理器、打包器于一体的 Node.js 替代品,可直接执行 TypeScript。大量 MCP Server 以 uvx 或 bunx 形式分发——即「临时拉取包并运行」,无需预先全局安装,这让配置只需一条命令。Cherry Studio 选择内置这两个运行时,是为了屏蔽用户系统环境的差异(版本冲突、PATH 未配置等),保证 MCP Server 在任何机器上行为一致;代价是占用额外磁盘空间,且必须通过客户端内的安装流程获取。
第三步:添加并激活 MCP Server
Cherry Studio 提供两种配置方式:快速创建(填命令,类似 Claude 客户端的配置)和从 JSON 导入(与 Claude Desktop 一致)。视频中两种都做了演示:
- 文件系统(File System):从 GitHub 复制 JSON 配置,把路径参数改为本地目录(示例为 D 盘 ABC 文件夹),授权该目录的读写操作。
- 网页抓取(FileCrawl):同样导入 JSON,但需要先去官网获取 Token 并替换配置中的 API Key。
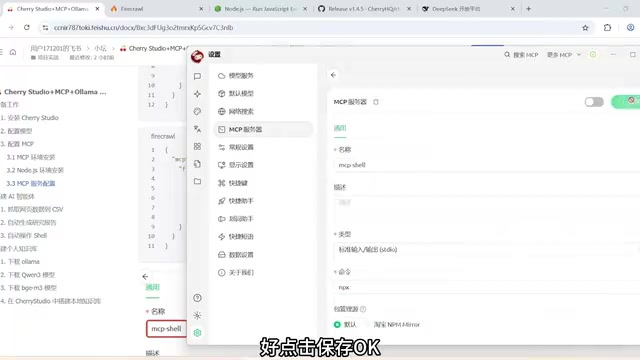
- Shell 控制:用快速创建方式,名称自定义,类型选 STDIO,命令填
npx -y加包名启动。
保存后需要手动点击激活,状态变为绿色才算就绪。
STDIO 是 MCP 的两种主要传输方式之一(另一种是 SSE/HTTP)。采用 STDIO 时,客户端把 MCP Server 作为一个子进程启动,双方通过标准输入输出流交换 JSON-RPC 消息,不占用网络端口,天然适合本地工具。快速创建时的「命令」字段就是子进程的启动命令,npx -y 表示用 npm 临时下载并直接运行指定包而不询问确认,-y 参数不可省略,否则会卡在交互式确认。JSON 导入方式则把启动命令、参数和环境变量(常含 API Key)打包成一份配置,便于从 Claude Desktop 等客户端直接迁移复用。
实战验证:三个自动化场景
视频用三个任务检验 MCP 链路是否真正可用:
- 网页数据转 CSV:让 AI 抓取某网页的 AI 模型排行榜并整理为 CSV。FileCrawl 成功抓取内容并输出表格,格式无误。
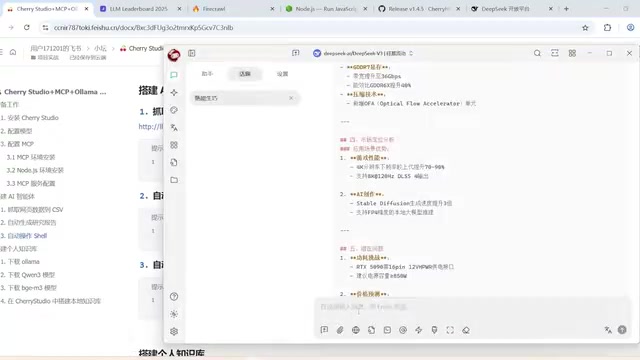
- 搜索并生成分析报告:要求搜索 RTX 50 系列显卡资料、写成 Markdown 中文报告并保存本地。AI 先调用搜索工具收集信息,再通过文件系统创建文档,但未能直接写入本地路径,最终靠手动下载拿到文件。内容本身覆盖了架构、核心技术与性能参数,信息完整度尚可。
- 执行 Shell 命令:查询 Docker 版本号,execute command 返回 28.0.4,与本地实际一致。
第三个场景值得单独提醒:Shell 类 MCP 权限极大,务必限定可执行的任务范围,否则误操作可能中断运行中的进程或造成数据丢失。另外,不使用时关闭 MCP 开关可以减少 token 消耗,这是成本控制的一个实用习惯。
第四步:用 Ollama 部署本地模型
知识库部分切换到本地模型路线。从 Ollama 官网下载对应系统版本安装,桌面不会生成快捷方式,需在命令行执行 ollama version 确认安装成功,右下角状态栏会出现羊驼图标表示后台运行中。
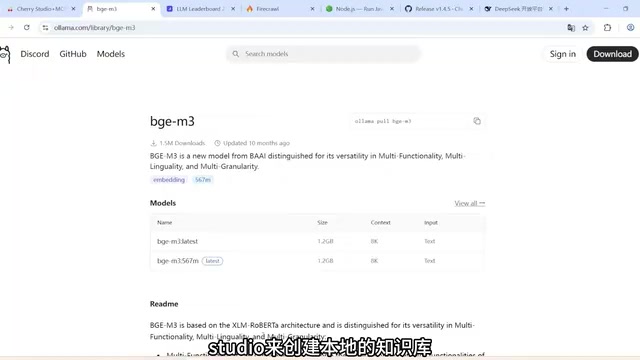
模型选择上,视频演示了通义千问广告 3 系列:旗舰版 235B 参数体积达 142GB,普通个人电脑无法承载;作者选用 0.6B 最小版本做演示,在性能与资源消耗间取平衡,通过 ollama run 命令拉取并进入对话。嵌入模型则选用 bge-m3,负责把文本转为向量以支持语义检索,同样用命令下载加载。
第五步:创建本地知识库并验证检索
回到 Cherry Studio,在模型服务中启用 Ollama,把 qwen3:0.6b 与 bge-m3 两个模型名称完整填入添加(名称可从 ollama list 输出中复制,避免拼写错误)。随后在知识库页面新建库,嵌入模型选本地 bge-m3,支持导入文件、目录、网址、笔记等多种来源。
视频用一份 AI 生成的「爱猫手册」PDF 做测试,上传后出现绿色勾表示解析完成。对话时选中本地模型、关闭 MCP、关联该知识库,提问「小花什么时候打的疫苗」,AI 依据文档内容准确答出狂犬疫苗时间与加强针记录;解除关联后再问同一问题,模型则无法回答——检索链路确实生效了。
本地部署的核心优势在于离线可用与数据不出本机,适合处理公司保密文件或个人隐私数据。代价是性能通常弱于云端服务,选型时需要在效果、硬件资源与隐私要求之间权衡。
嵌入模型与语义检索 是知识库能「答对问题」的技术基础。bge-m3 属于 BGE 系列多语言嵌入模型,它把每段文本映射为一个高维向量,语义相近的文本在向量空间中距离更近。上传 PDF 时,系统先切分成小块(chunk)并逐一向量化存入本地向量库;提问时,问题同样被向量化,系统检索出最相似的若干片段,再连同问题一起交给对话模型生成答案——这就是 RAG(检索增强生成)的典型流程。因此嵌入模型的质量直接决定召回准确率,而对话模型只需负责组织语言;两者可以是不同模型,这也是视频中 qwen3:0.6b 与 bge-m3 搭配使用的原因。
这套组合适合谁
整条流程的门槛主要集中在环境安装环节:GitHub 下载不稳定、UV/Bun 必须内置安装、模型名称需精确匹配,这三处是最常见的卡点。跨过之后,MCP 的 JSON 配置与知识库的拖拽上传都相当直观。对于需要重复处理网页数据、批量整理文档、或希望把敏感资料交给 AI 分析又不想上云的用户,Cherry Studio + MCP + Ollama 构成了一条成本可控、隐私可控的桌面级方案;对性能有更高要求的场景,仍可保留云端模型作为主力,本地链路作为补充。
相关推荐
ChatGPT正在为你建立心理画像:隐私边界再引争议
Reddit热帖讨论ChatGPT是否在为用户建立心理画像。本文解析对话记忆、情绪信号与行为数据如何累积成心理侧写,探讨个性化服务与隐性监控的边界,并给出用户保护隐私的实用建议。
多AI智能体邮件身份管理:别名、独立收件箱还是API方案?
多个AI智能体如何管理邮件身份?本文分析邮件别名、独立收件箱和API按需创建三种方案的优劣,并给出按智能体角色分层管理的实践建议,帮助团队在安全隔离与运维效率之间取得平衡。

iPhone Duo碎屏门:YouTuber拆解揭示铰链缺陷
苹果iPhone Duo折叠屏手机爆发碎屏门,用户报告铰链处屏幕快速开裂。YouTuber拆解发现铰链设计缺陷或异物入侵,导致应力集中。事件引发社区热议,苹果尚未回应,折叠屏可靠性再受质疑。