稠密模型 vs MoE:激活参数、吞吐量与选型指南
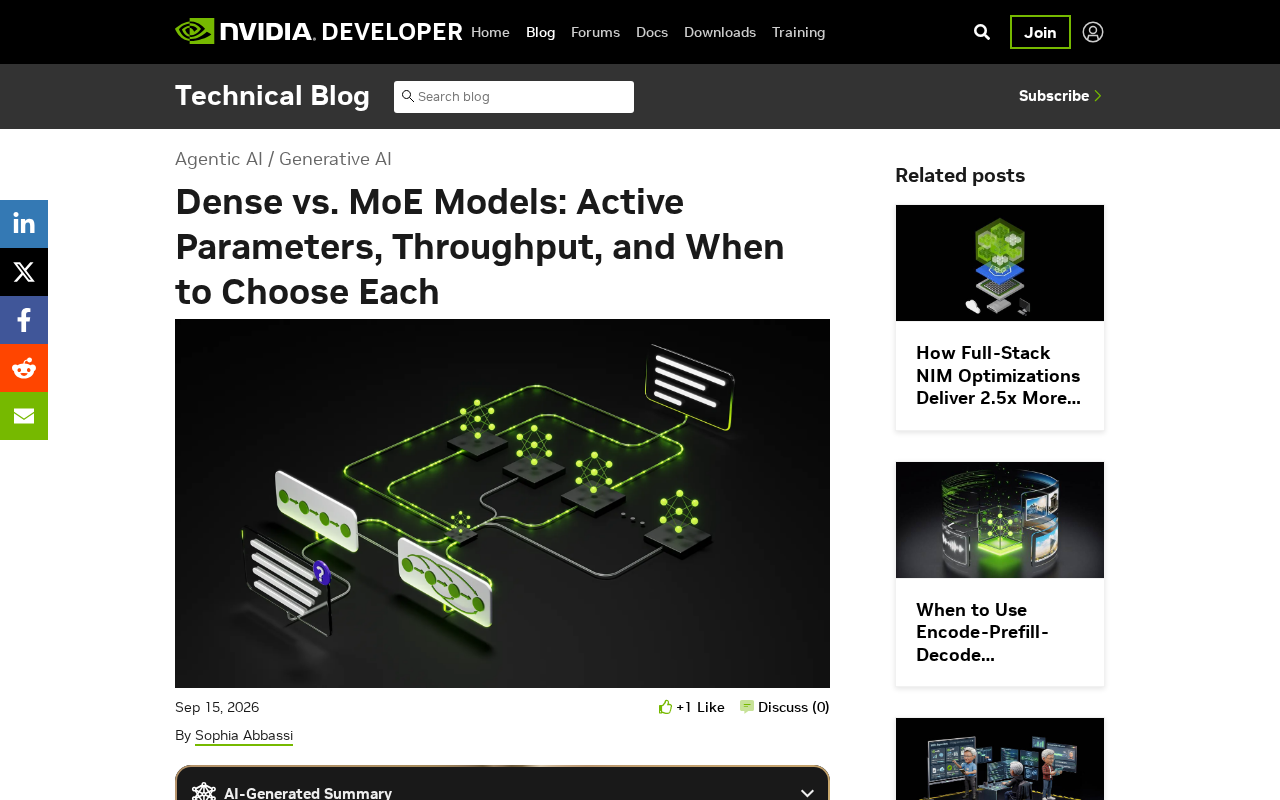
MoE架构通过专家路由将总参数与激活参数解耦,以大容量换能力、小激活换推理效率。
本文以 NVIDIA Nemotron 3.5 Lightning 为切入点,深入解析混合专家模型(MoE)的核心设计哲学:30B 总参数量的模型每个 token 仅激活约 3B 参数,根本原因在于「专家路由」机制将模型的知识容量与单次推理计算量彻底解耦。相比稠密模型「用多少参数就算多少参数」的线性关系,MoE 以显存存储全部专家权重为代价,换取了高并发场景下显著更优的吞吐效率。文章同时指出 MoE 的工程代价——路由不均衡、显存占用依赖总参数量而非激活参数量、以及多卡通信开销——并给出了稠密模型与 MoE 在不同部署约束下的选型框架:算力与吞吐是瓶颈时选 MoE,显存受限或追求部署简洁时选稠密模型。
一个反直觉的问题:30B 模型为何只激活 3B 参数?
NVIDIA 在其开发者博客中抛出了一个值得深思的问题:一个拥有 300 亿参数的模型,如何做到每个 token 只激活 30 亿参数,同时又能保留大模型的能力?答案就藏在**混合专家模型(Mixture of Experts, MoE)**的架构设计之中。Nemotron 3.5 Lightning 正是这一思路的典型代表。
这个问题背后,其实是当下大模型工程实践中最核心的权衡之一:在保证模型能力的前提下,如何最大化推理效率、降低部署成本。理解稠密模型(Dense)与稀疏 MoE 模型之间的差异,已经成为模型选型绕不开的一课。
稠密模型与 MoE 的本质区别
稠密模型的逻辑非常直接:模型有多少参数,每次前向计算就用到多少参数。一个 30B 的稠密模型,处理每一个 token 时,全部 300 亿参数都会参与运算。这种设计的优点是结构简单、行为可预测,训练与推理链路成熟,但代价是计算量与参数规模严格挂钩——参数越多,推理成本越高。
MoE 模型则引入了「专家路由」机制。模型内部包含多个「专家」子网络,但每个 token 只会被路由到其中少数几个专家进行计算。这就解释了「30B 模型只激活 3B 参数」的现象:模型的总参数量很大(决定了知识容量),但激活参数量很小(决定了单次推理的计算开销)。
两个关键概念:总参数与激活参数
在讨论 MoE 时,必须区分两个容易混淆的数字:
- 总参数量(Total Parameters):模型全部权重的规模,反映其知识容量与表达能力上限。
- 激活参数量(Active Parameters):处理单个 token 时实际参与计算的参数量,直接决定了推理时的算力消耗和延迟。
MoE 的核心价值,就是把这两个数字「解耦」开来——用大总参数量换取模型能力,用小激活参数量换取推理效率。这也是为什么 Nemotron 3.5 Lightning 这类模型能在保持较大容量的同时,实现远超同等规模稠密模型的吞吐表现。
MoE 架构并非近年才有的新发明,其理论根源可追溯至 1991 年 Jacobs 等人提出的「专家混合」框架。真正让 MoE 在大语言模型领域大放异彩的,是 Google 2017 年发布的 Sparsely-Gated MoE 论文,以及后来 Switch Transformer(2021)和 Mixtral 8×7B(2023)的落地实践。现代 MoE 大模型通常在 Transformer 的 FFN(前馈网络)层引入专家结构,每个专家本质上是一个独立的 FFN,由一个轻量级的门控网络(Gating Network)决定每个 token 被分配到哪几个专家。Nemotron 3.5 Lightning 所采用的正是这一主流范式:共享的注意力层保持稠密计算,FFN 层则替换为稀疏激活的专家组合,从而在架构层面实现了「知识存储」与「推理计算」的分离。
吞吐量:MoE 的核心优势场景
从吞吐量(Throughput)角度看,MoE 的收益十分明显。由于每个 token 只激活一小部分参数,MoE 模型在相同硬件上可以处理更多的并发请求,或者在相同延迟预算下服务更大的模型容量。对于需要高并发、大批量推理的生产环境,这种效率优势可以直接转化为服务器成本的下降。
不过,MoE 并非没有代价。专家路由机制带来了额外的复杂度:路由不均衡可能导致某些专家过载而另一些闲置;专家分布在多张 GPU 上时,会引入额外的通信开销;模型加载时需要将全部专家权重驻留在显存中,因此显存占用往往由总参数量决定,而非激活参数量。这意味着 MoE 省的是「算力」,而不一定省「显存」。
路由不均衡(Load Imbalance)是 MoE 工程落地中最棘手的问题之一。如果门控网络总是偏好少数几个「热门专家」,其余专家便会长期闲置,模型的有效容量大打折扣,同时热门专家也会成为计算瓶颈。为解决这一问题,研究者引入了辅助损失函数(Auxiliary Loss)在训练阶段强制各专家的负载趋于均匀,以及专家容量上限(Expert Capacity)机制——当某个专家已接收的 token 数量超过上限时,多余的 token 将被丢弃或直接传递,牺牲少量精度换取路由的可控性。在多机多卡部署中,专家并行(Expert Parallelism)还会引入跨设备的 All-to-All 通信,这是 MoE 在分布式环境下延迟高于等算力稠密模型的主要原因之一。
如何在稠密与 MoE 之间做选择
模型选型没有绝对的赢家,关键在于匹配具体的部署约束和业务目标。以下几个维度可以作为决策参考:
优先考虑 MoE 的情况
- 追求高吞吐、低单位成本的大规模在线服务
- 显存资源充足,但对计算延迟和并发能力敏感
- 希望在有限算力预算下获得更强的模型能力上限
优先考虑稠密模型的情况
- 部署环境显存受限,无法容纳大总参数量的专家权重
- 追求推理行为的可预测性与部署链路的简洁性
- 中小规模场景下,稠密模型的工程复杂度更低、更易调优
换言之,如果你的瓶颈是算力和吞吐,MoE 通常是更优解;如果瓶颈是显存容量或运维复杂度,稠密模型反而更稳妥。
写在最后
Nemotron 3.5 Lightning 这个例子的价值,在于它直观展示了 MoE 架构「大容量、小激活」的工程哲学。随着模型规模持续膨胀,如何在能力与成本之间取得平衡,MoE 提供了一条极具吸引力的路径。但它带来的路由复杂度、显存开销和通信成本,也要求团队在选型时做出更细致的评估。理解激活参数与总参数的区别,是做出正确决策的第一步。
相关推荐
同款模型三大AI Agent横评:DeepSeek Harness、ZCode与Hermes谁更强
同一个GLM Flash模型、相同提示词,分别放进DeepSeek Harness、ZCode和Hermes三大AI Agent中横评对比。实测显示Agent框架差异显著,速度、代码量与最终效果各有高低,DeepSeek Harness综合表现最佳。
DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。
DeepSeek Harness实战改造:打造低成本AI编程神器
国外技术UP主分享如何改造DeepSeek官方harness,用Claude Code驾驭开源框架,配合Bright Data数据抓取与视觉模型,打造成本仅半分钱的AI编程工作流,实测比Claude Code更便宜。