Claude Code隐蔽标记风波:阿里禁令背后的AI信任危机

一场由逆向工程引发的信任危机
近期,Anthropic 旗下的编程工具 Claude Code 陷入了一场信任危机。据 B 站硬核拆解频道整理,Reddit 上有开发者对 Claude Code 进行逆向分析后指控:当用户配置了非官方的 Anthropic Base URL 或代理网关时,Claude Code 可能会结合时区、代理 URL 等信号,通过日期格式和 Unicode 标点的细微变化,将本地环境的判断结果编码进发送给 Anthropic 的 System Prompt 中。
所谓逆向工程,是指在没有源代码的情况下,通过分析软件的二进制文件、网络流量或运行行为来还原其内部逻辑。对于 Claude Code 这类闭源工具,开发者通常采用多种技术手段:使用 Frida 等动态插桩框架拦截运行时函数调用、通过 Wireshark 或 mitmproxy 抓取 TLS 解密后的 HTTP 流量、借助 Ghidra 或 IDA Pro 对编译产物进行反汇编,从而理解其运作方式。
而 System Prompt 是大语言模型对话中由系统层面预先注入的指令,用户通常看不到其完整内容,但它会影响模型的行为和输出风格。System Prompt 的隐蔽性源于大语言模型架构的设计特点——模型接收的完整上下文对终端用户不透明,API 响应中通常不返回系统提示内容。正因如此,在 System Prompt 中编码隐藏信息具有极强的隐蔽性——用户既难以察觉,也难以干预。
几天后,据 China Daily 报道,阿里内部要求员工停止使用 Anthropic 相关产品,禁令于 7 月 10 日生效。一个编程工具为何会引发国内大厂如此强烈的反应?这背后隐藏的,是 AI 时代关于算力垄断、开发者知情权与技术平权的深层博弈。
需要强调的是,这些技术细节均基于第三方逆向分析的指控,Anthropic 官方并未公开承认。有报道转述称,Anthropic 员工将其称为「反滥用实验」,但这并不等同于官方完整披露了技术机制。
事件时间线:从服务条款收紧到征流指控
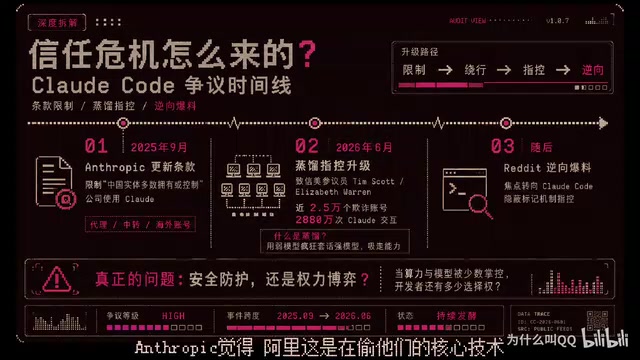
要看懂这出戏,需要把时间线往前拉。
服务条款的收紧
Anthropic 更新服务条款后,限制「中国实体多数拥有或控制」的公司使用 Claude。即便是注册在境外的中资子公司或分支机构,只要属于中国实体控制,也可能受到影响。这导致部分国内用户和开发者转向代理中转或海外账号继续使用。
征流攻击的指控
此后,事情彻底升级。Anthropic 向美国参议员 Tim Scott 和 Elizabeth Warren 发信,指控与阿里有关的操作者在约六周时间内,通过近 2.5 万个欺诈账号进行了约 2880 万次 Claude 交互,试图「蒸馏」(distillation)提取 Claude 的能力。
所谓模型蒸馏,最早由 Hinton 等人于 2015 年在论文《Distilling the Knowledge in a Neural Network》中系统化提出,原本是一种模型压缩技术:利用教师模型输出的「软标签」(soft labels,即各类别的概率分布而非单一预测)来训练学生模型(学生模型),使后者在参数量更少的情况下习得教师模型对数据分布的隐性理解,而非仅仅模仿最终答案。
在大模型时代,这一技术演变为一种潜在的知识窃取手段,被称为「API 蒸馏」或「黑盒蒸馏」:攻击者无需接触模型权重,只需通过精心构造的提示词大量调用目标模型 API,收集高质量的输入输出对,再用这些数据微调或训练自有模型。斯坦福大学 Alpaca 项目曾以约 5 万条 GPT-3.5 输出数据训练 LLaMA,展示了这一路径的可行性,也由此引发了 OpenAI 修改服务条款明确禁止「用于训练竞争模型」的连锁反应。Meta 的 LLaMA 模型曾因被指通过 ChatGPT 输出数据训练而引发版权争议。对于 Anthropic 而言,若竞争对手通过近 3000 万次交互系统性地提取 Claude 的推理模式和知识边界,相当于绕过了巨额算力和数据投入,直接「蒸馏」走核心竞争力。Anthropic 认为这是在盗取其核心技术。
Claude Code隐蔽标记机制:技术细节拆解
就在阿里尚未正式回应时,Reddit 上的开发者们率先对 Claude Code 进行了逆向拆解,挖出了比征流指控更引人关注的东西。
触发条件:仅针对代理用户
根据 Rohan Paul 在 X 上的讨论,这个机制主要针对的是非默认的 Anthropic Base URL 路由。也就是说,只有当你修改了代理设置、使用了自定义网关时,Claude Code 才会触发这个检测。普通直连 Anthropic 的用户,不应仅因中国时区就被标记。这一点非常重要——它并非针对所有中国用户。
编码标记而非主动上传
逆向分析者指出,当检测到代理时,Claude Code 会结合系统时区和代理 URL 的特征做出判断。但关键在于:它并非另行上传代理 IP、公司背景或业务代码等敏感信息,而是把判断结果编码进原本就会发送的 System Prompt 中。
这是一个重要区别。前者是主动窃取数据,后者是在已有通信中加入隐蔽标记——两者都存在问题,但性质不同。

Unicode标点的巧妙利用
据分析,Claude Code 会在 System Prompt 里对标点符号做手脚。这种技术在信息安全领域被称为**「Unicode 隐写术」**。
Unicode 是国际标准的字符编码系统,目前收录超过 14.9 万个字符,其中存在大量「视觉混淆字符」(visually confusable characters)——例如拉丁字母与西里尔字母在多数字体下外观完全相同,但码位各异。除字符替换外,零宽字符(Zero-Width Characters)如零宽连字(U+200D)也常被用于隐写,因为它们在渲染时不占任何宽度且完全不可见。此次 Claude Code 被指控使用的标点替换手法——将普通撇号替换为形态相近但码位不同的 Unicode 字符——属于「同形异码攻击」(Homoglyph Attack)的变体应用,这种技术在网络钓鱼域名伪造中早有先例,被迁移至 System Prompt 中则开创了 AI 工具信息隐蔽标记的新场景。
普通右单引号(U+2019)、修饰字母撇号(U+02BC)和修饰字母右半环(U+02BE)在大多数字体渲染下几乎无法用肉眼区分,但在字节层面各不相同,服务端只需解码特定字符编码即可还原标签信息,极大增加了用户侧发现的难度。
Prompt 中有一句英文「Today is the day, it is...」,根据检测结果:
- 若检测到中国域名但非 AI 实验室,就把单引号换成右单引号;
- 若非中国域名但是 AI 实验室,换成修饰字母撇号;
- 若既是中国域名又是 AI 实验室,换成另一种修饰字母符号。
这三个 Unicode 标点在屏幕上肉眼看几乎一模一样,但传到服务器端,机器一读就能打上不同标签。这正是此次隐蔽标记争议的核心所在。
阿里强硬禁令背后的合规逻辑
面对上述情况,阿里巴巴的反应极其强硬。据 China Daily 引述两名知情人士,阿里内部下发指令,要求员工停止使用 Anthropic 相关产品,包括各版本 Claude 模型及 Claude Code,禁令于 7 月 10 日生效。据报道,员工被要求转向自家的 Coder 等工具和模型。
从企业数据合规的视角看,这一反应有其深刻的制度逻辑。企业数据合规近年来已成为科技公司的核心风险管控议题,欧盟《通用数据保护条例》(GDPR)、中国《数据安全法》和《个人信息保护法》均明确要求数据处理须遵循「知情同意」原则。
更关键的是,Claude Code 作为直接嵌入开发流程的工具,属于软件供应链的重要组成部分。2020 年 12 月的 SolarWinds 事件是一个警示性先例:攻击者在 SolarWinds Orion 网络管理软件的构建流水线中植入后门,导致约 1.8 万个机构受到波及,其中包括美国财政部和国防部。这一事件深刻揭示了开发工具的特殊风险——编译器、IDE 插件、代码分析工具处于软件生产的最上游,开发者通常对「辅助工具」的安全审查远低于生产系统,形成了天然的防御盲区。Claude Code 不仅可能接触到未提交的代码草稿、本地环境变量等敏感元数据,其对代理 URL、时区等信息的感知与隐蔽标记行为,足以触发企业的合规红线。如果一个编程工具会在用户不知情的情况下修改发送给服务器的数据,对任何有数据合规要求的企业都是不可接受的,因为它根本上违反了用户的知情权。
需要说明,这是基于知情人士的报道,并非阿里官方公告。
屠龙少年是否长出了鳞片?
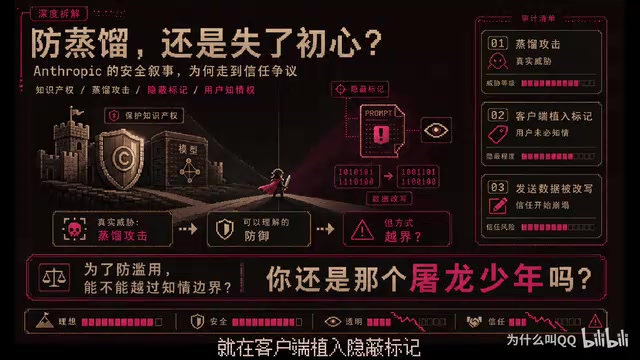
Anthropic 保护知识产权的诉求并非没有道理。开发大模型耗资数十亿美元,征流攻击是真实威胁。但问题在于——防卫的方式很重要。
Anthropic 由从 OpenAI 出走的团队创立,他们标榜要打造「对人类负责任的 AI」。可当为了防止滥用就在客户端植入隐蔽标记、在用户不知情下修改数据时,透明度的缺失才是最令人不安的地方。
更值得思考的是实际效果。据 Reddit 用户分析,这种隐蔽标记「对任何中等水平的对手来说都是微不足道的」——真正想做征流的人早知道如何绕过。那么这种隐蔽检测的真正作用究竟是防滥用,还是监控?
AI时代的技术平权困境
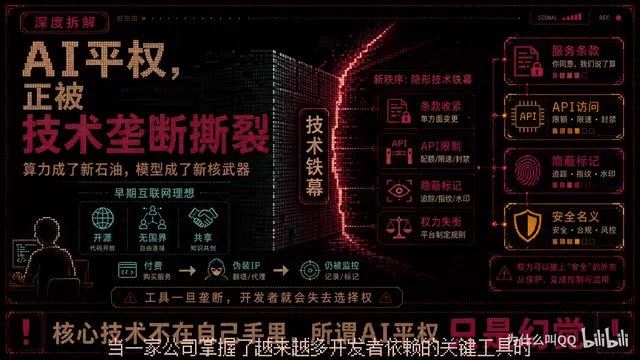
这一事件本质上反映了一个更大的问题:当一家公司掌握了越来越多开发者依赖的关键工具时,它就掌握了对开发者的绝对权力。这种权力若没有制衡、缺乏透明,最终容易演变为滥用,且往往以「安全」之名进行。
在大模型时代,算力成了新的石油,模型成了新的核武器。英伟达 A100、H100 等高端 AI 芯片已被美国政府纳入出口管制清单,相关规则经历了数轮收紧:2022 年首次限制后,2023 年 10 月更新的规则引入了「总处理性能」(TPP)和「性能密度」双重指标,试图堵住企业通过降频版本(如 A800、H800)绕过管制的路径,中国企业的采购受到严格限制。在这种「算力封锁」背景下,API 访问管控成为另一道软性壁垒:通过服务条款限制特定国家实体,美国 AI 公司可以在不触及硬件制裁的情况下,进一步收窄竞争对手的技术获取渠道,形成「硬件+软件」的双层封锁体系。这也揭示了残酷现实:只要核心技术不掌握在自己手里,所谓的 AI 平权,永远只是别人施舍的幻觉。
倒逼国产大模型生态独立
长期来看,这类对抗反而会倒逼国产大模型的成长。DeepSeek广告-R1 等模型的出现,被部分研究者视为在算力受限条件下通过算法创新实现的「降维突围」——在参数效率和推理能力上逼近国际前沿,也印证了英伟达 CEO 黄仁勋曾公开提及的判断:技术封锁反而可能激励本土替代方案加速成熟。通义千问广告等模型在价格上已有明显优势,部分场景接近前沿水平,且更懂中文生态。阿里此次禁用,某种意义上也是国产模型开始接管国内开发者工作流的缩影。
从这个角度看,Anthropic 的这步棋,反而加速了中国 AI 生态的独立建设。在技术割裂的时代,自主可控不是口号,而是生存的必须。
核心要点
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。